Haiku 5.5 昨天出來,官方定價輸入每百萬 token 0.10 美元、輸出 0.50 美元(100k 以內),Sonnet 5.5 是 2 跟 10 美元。
官方頁面自己也講,複雜的 agentic coding 還是 Sonnet、Opus 比較好。但我在意的是我每天派給 subagent 的那些工作,它到底接不接得住。
所以這次我沒看官方跑分,直接拿自己的工作出考卷。
(想直接用自己的工作測的,方法我做成公開套件了,在文末。)
題目從哪裡來
我讓 Opus 去翻我過去 45 天的 Claude Code 對話紀錄,裡面一共派了 761 次 subagent,大部分給 Sonnet,一百多次給 Opus。
從裡面挑出 8 種最常派、又能對答案的工作,做成 8 題:
- 長逐字稿抽取(一份 62 分鐘的訪談,要逐字引原文)
- 草稿數字核對(13 條主張,埋了 5 條錯的)
- 公開版電子報紅隊審查(埋了客戶名、內部代號、對不上的數字、成效承諾)
- 找文件裡的死連結
- 派工紀錄 CSV 統計(時間是 UTC,題目要用曼谷時間算)
- 驗證程式找 bug(埋了 3 個)
- 金流對帳(時區切月份、部分退款、失敗的交易)
- session 收尾時,待辦要寫進哪個檔、寫成什麼格式
再加上 9/29 測舊模型時用的 5 題簡單題,看基本功有沒有退步。
每一題都是先算好標準答案、再開跑。Haiku 開 medium 跟 high 各跑 3 次,Sonnet 5.5 跑 2 次,Opus 5.5 跑 1 次當天花板,總共 87 次,花了大約 15 美元。
結果
5 題簡單題,Haiku 三種 effort 全對,每題大約 1 美分。9/29 測的時候,舊的 Haiku 4.5 每題大約 9 美分,Sonnet 5.5 大約 15 美分。
第 2 到第 8 題,Haiku 跟 Sonnet、Opus 一樣全部答對,只有一次是被權限擋住交白卷(下面會講)。
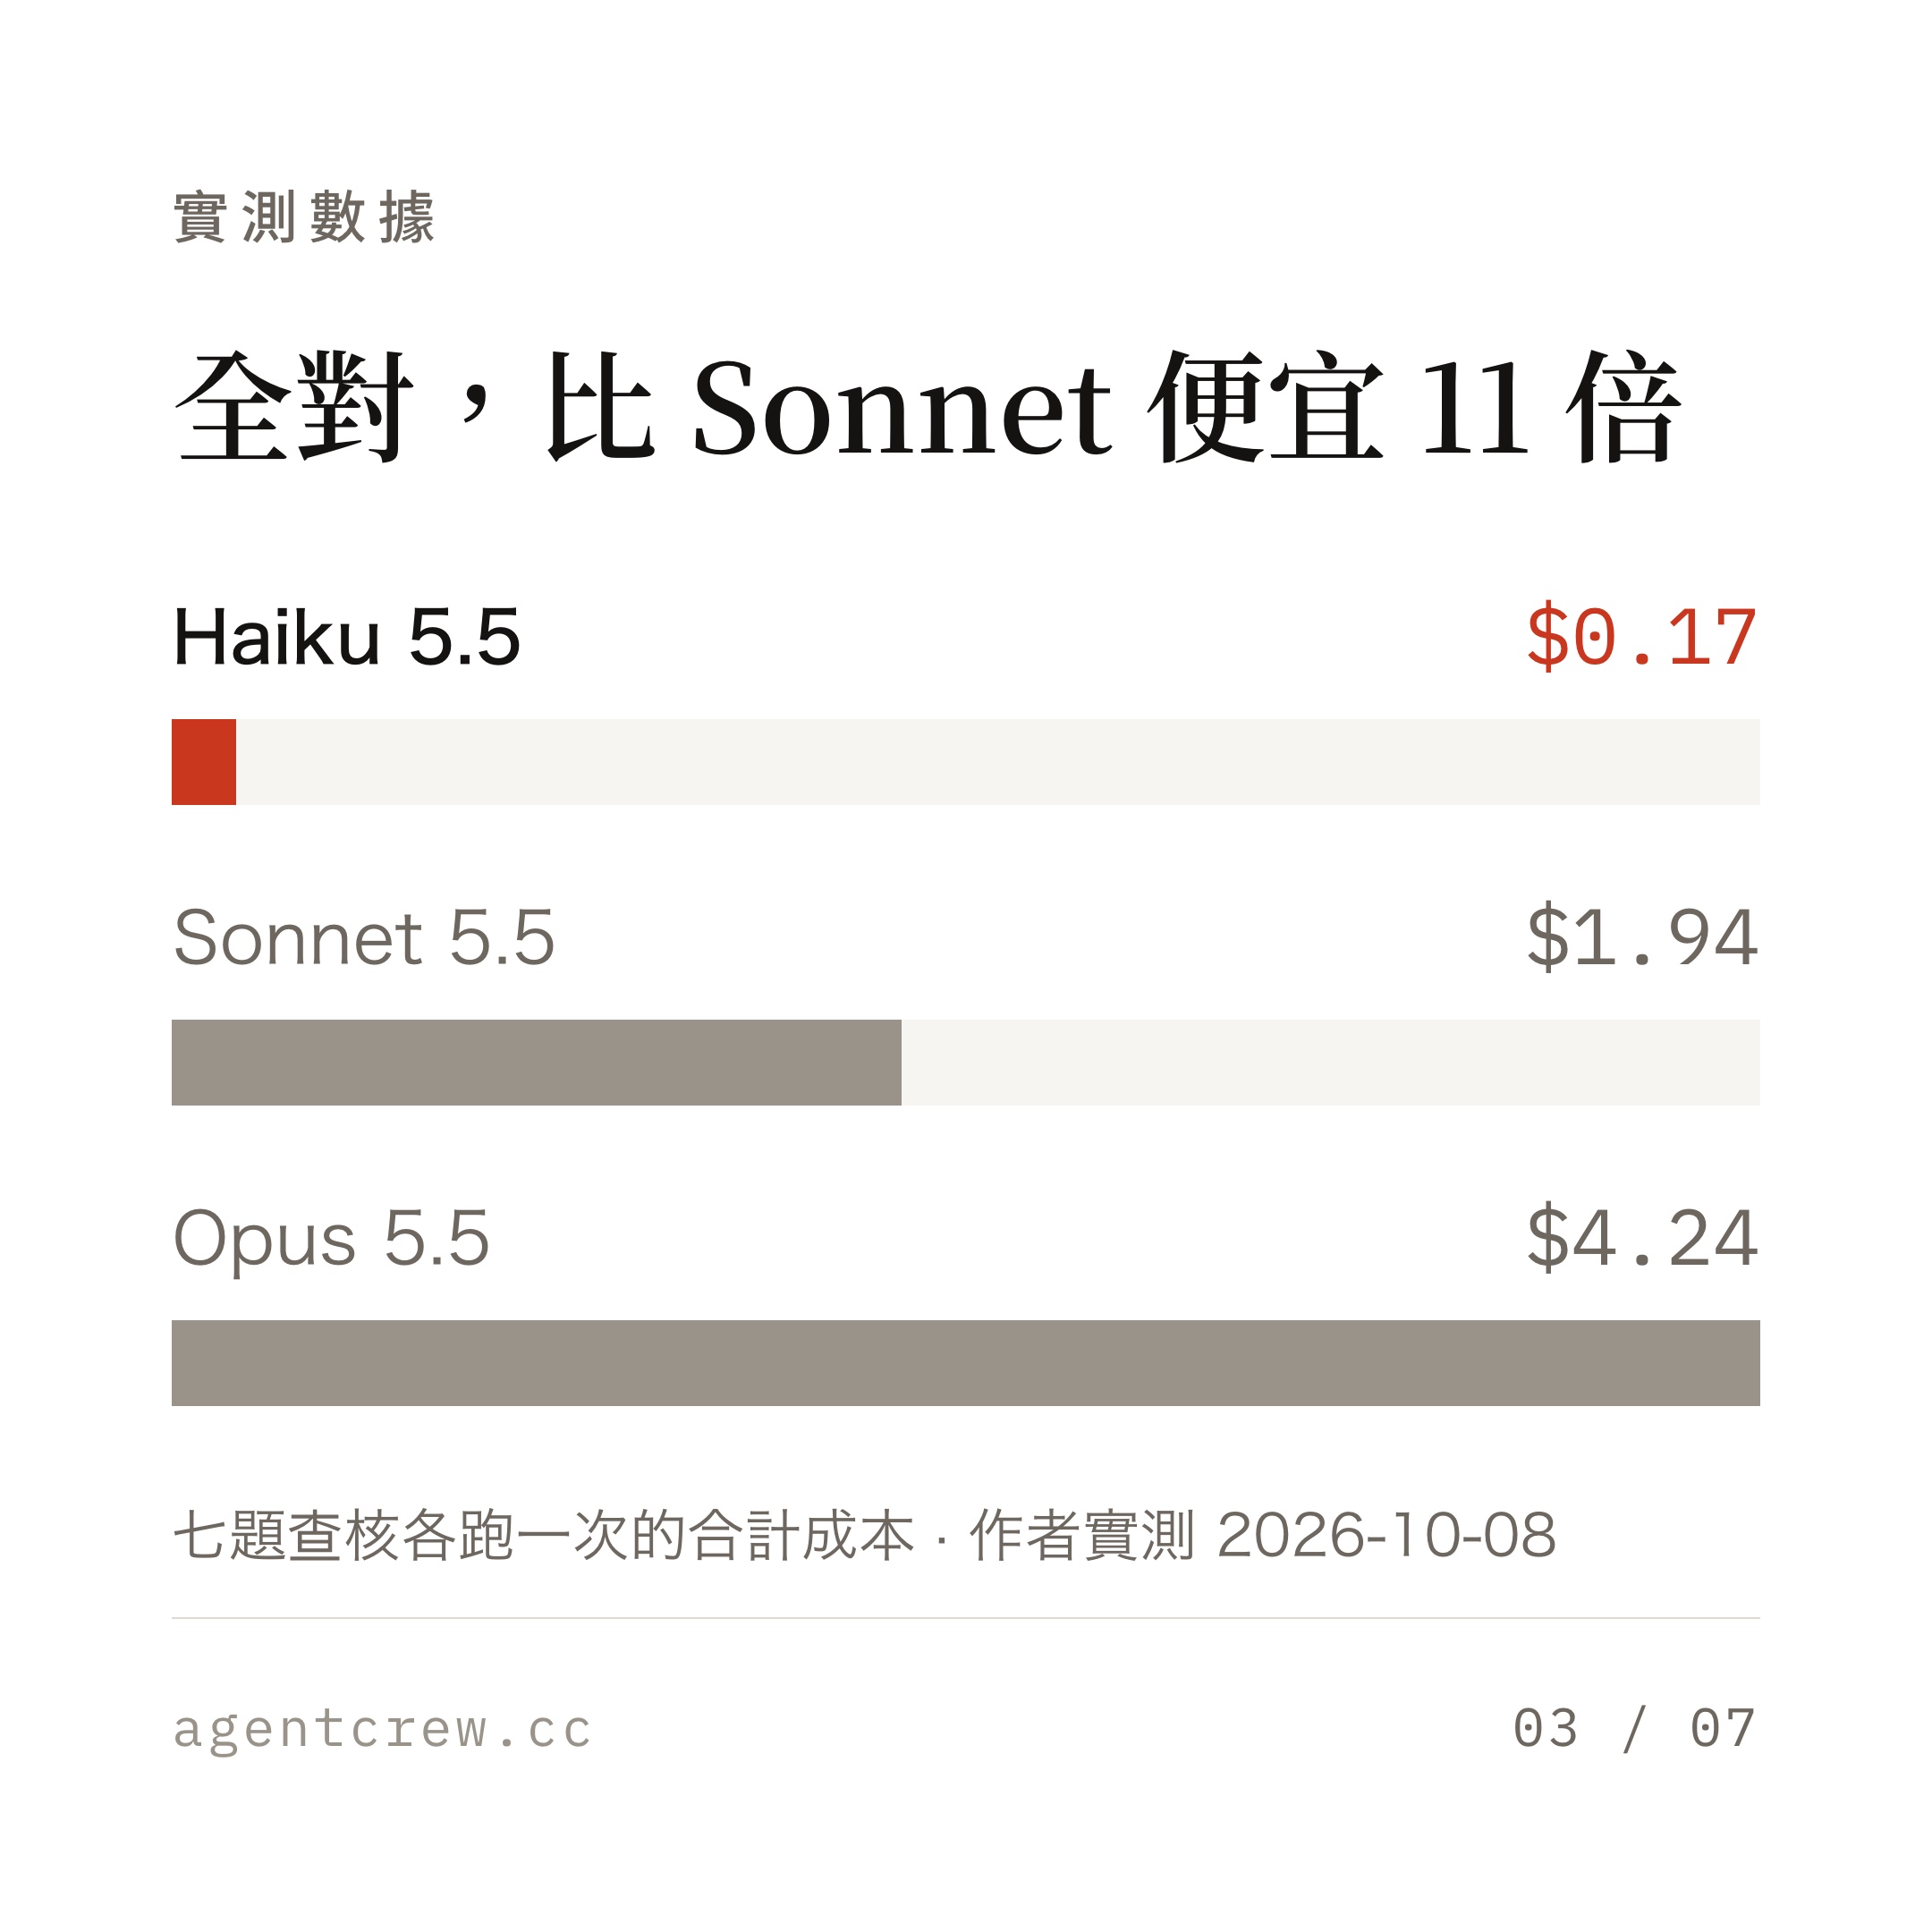
七題加起來的成本:
| Haiku 5.5 | Sonnet 5.5 | Opus 5.5 | |
|---|---|---|---|
| 七題合計(每題跑一次) | 0.17 美元 | 1.94 美元 | 4.24 美元 |
| 七題合計耗時 | 約 300 秒 | 約 300 秒 | 約 300 秒 |
分數一樣、速度也差不多,成本大概是 Sonnet 的十一分之一。
最讓我意外的是第 6 題,找程式 bug。這類工作我以前都是派 Opus,結果 Haiku 開 medium、high 各跑三次,六次都把三個 bug 全抓到。
唯一沒過的:長逐字稿抽取
第 1 題是 10/3 舊 Haiku 不及格的原題。那次它 44 筆裡有 6 筆引句在原文找不到,還自己回報「全部逐字相符」。
這次四個模型都過了引句驗證,沒有捏造,這點進步很大。
但完整度差很多。Haiku 六次各抽出 45 到 85 筆,Sonnet 兩次是 93 跟 99 筆,Opus 是 112 筆。開到 high 也沒有穩定變好。
逐字稿這種工作,漏抽的東西沒有任何程式能幫你檢查出來,所以這類我還是會交給 Sonnet。
一個小毛病
考試時我把權限鎖得很緊,需要算的題目只准它跑 python3。Haiku 有一半的時候會順手用 wc、cd、mkdir,或把幾個指令串在一起,結果被擋下來。Sonnet 一次都沒有。
大部分時候它會自己換個方法繞過去,但繞路多燒的輪次讓同一題的成本翻了 6 倍。還有一次被擋一次就直接交白卷。
平常派工的權限沒鎖這麼緊,應該不太會遇到。不過把可以用的指令寫清楚再派給它,重跑三次都全對,每次 1 美分多一點。
我的分工改成這樣
上週寫過 Opus 指揮、Sonnet 實作、Fable 當顧問,這次多切了一層:
- 答案能對照驗證的工作,查設定、核對數字、照規則審稿、找死連結、對帳、統計,先派 Haiku
- 要讀得完整才做得好的抽取、寫稿、會動到檔案跟 commit 的收尾,還是 Sonnet
- 安全、程式驗收的終審、金流的最後拍板,留給 Opus
沒出題測過的工作類型,照舊,不從這次的結果去推。
評分器自己也出包
順帶一提,這次出包最多的是我自己寫的評分程式。
一次是只讀最後一則訊息,模型被收工檢查逼著多回一句「內容同上」,正確答案就被算成零分。一次是紅隊題把「多抓到的問題」自動當成誤判,人工一條條看完,其實全部成立。還有一次是答案行比對,撿到了說明文字裡同樣有「Q2」的那一行。
三次都是模型答對、評分器判錯。所以分數出來之後,沒拿滿分的每一筆我都打開原文看過。
你也可以用自己的工作考
這套方法我整理成一個公開的套件:model-bench-kit。
裡面沒有現成的考卷。你的 agent 讀了之後,會自己去翻你的對話紀錄,挖出你平常在派的工作、出題、算好答案、跑分、評分,最後幫你重寫你自己的派工原則。
裡面附了三題合成資料的範例,可以先跑通流程。下次新模型出來,加一行設定重跑就好。
想自己測的話:
- 用 Claude Code 的人,把 repo clone 到
~/.claude/skills/model-bench - 跟它說:「用 model-bench 幫我測 Haiku 5.5 能不能接我平常派給 Sonnet 的工作」
- 它會先估要跑幾次、花多少錢,你點頭才開跑
沒用 Claude Code 的,直接把 repo 網址 丟給你的 agent,叫它讀 SKILL.md 照做。測完歡迎回來跟我說你的結果。