目錄
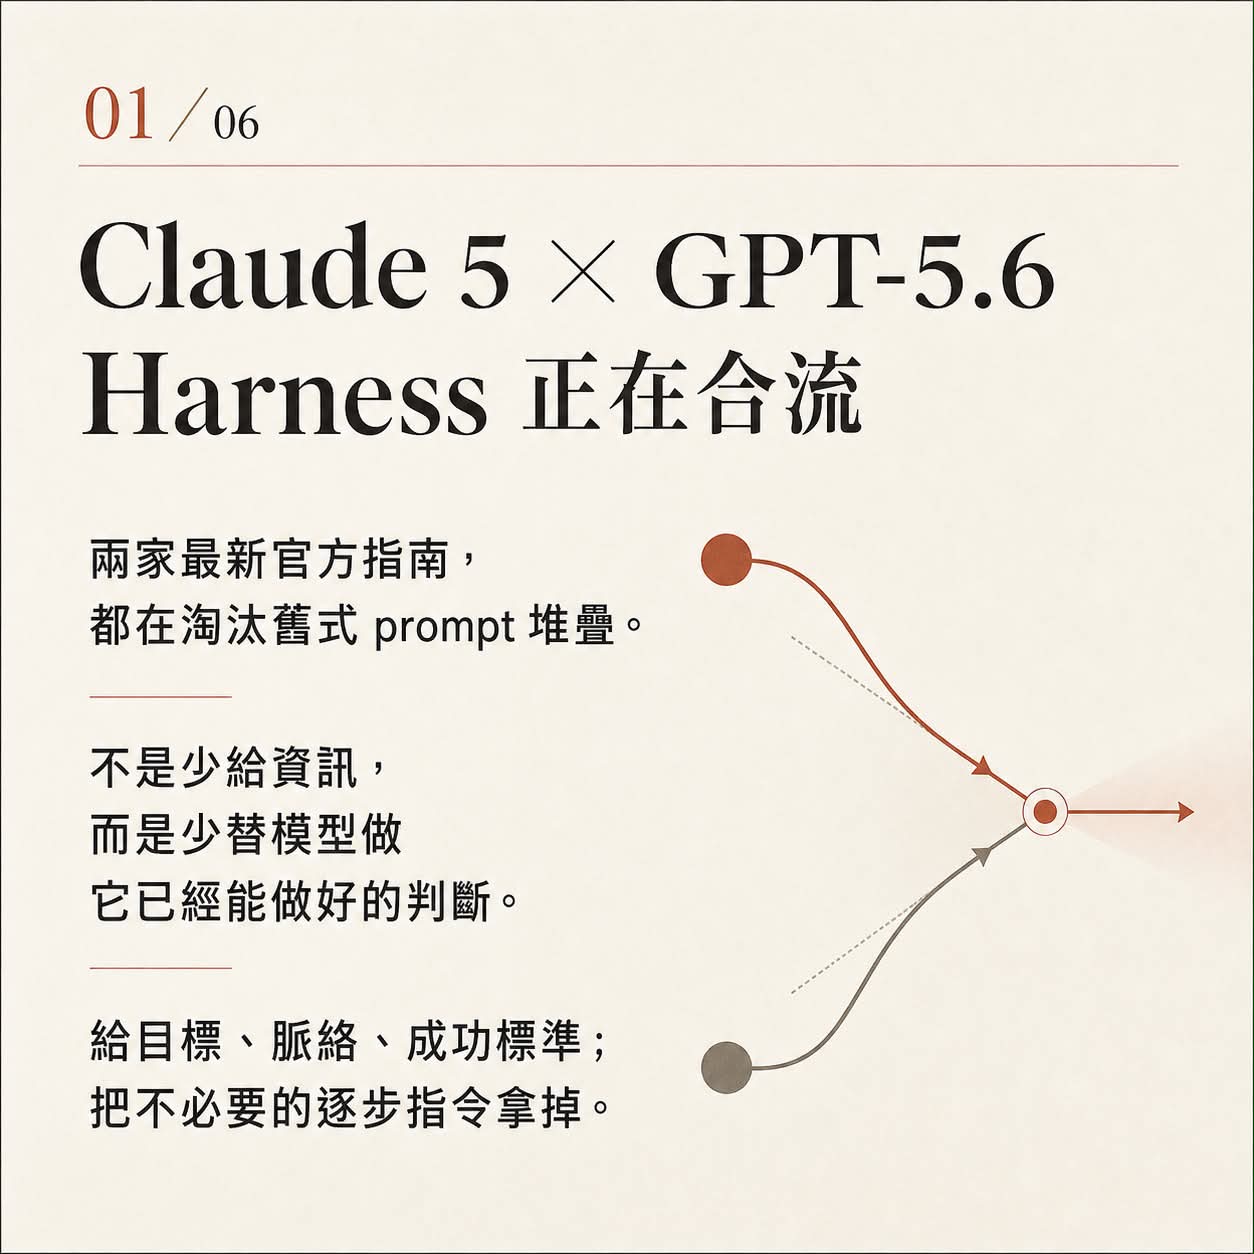
我把 Claude 5 跟 GPT-5.6 兩家最新的官方指南擺在一起看,結論比我想像的更一致:它們都在淘汰舊式的 prompt 堆疊。
重點不是少給資訊,而是少替模型做它已經能做好的判斷。給目標、給脈絡、給成功標準;把不必要的逐步指令拿掉。
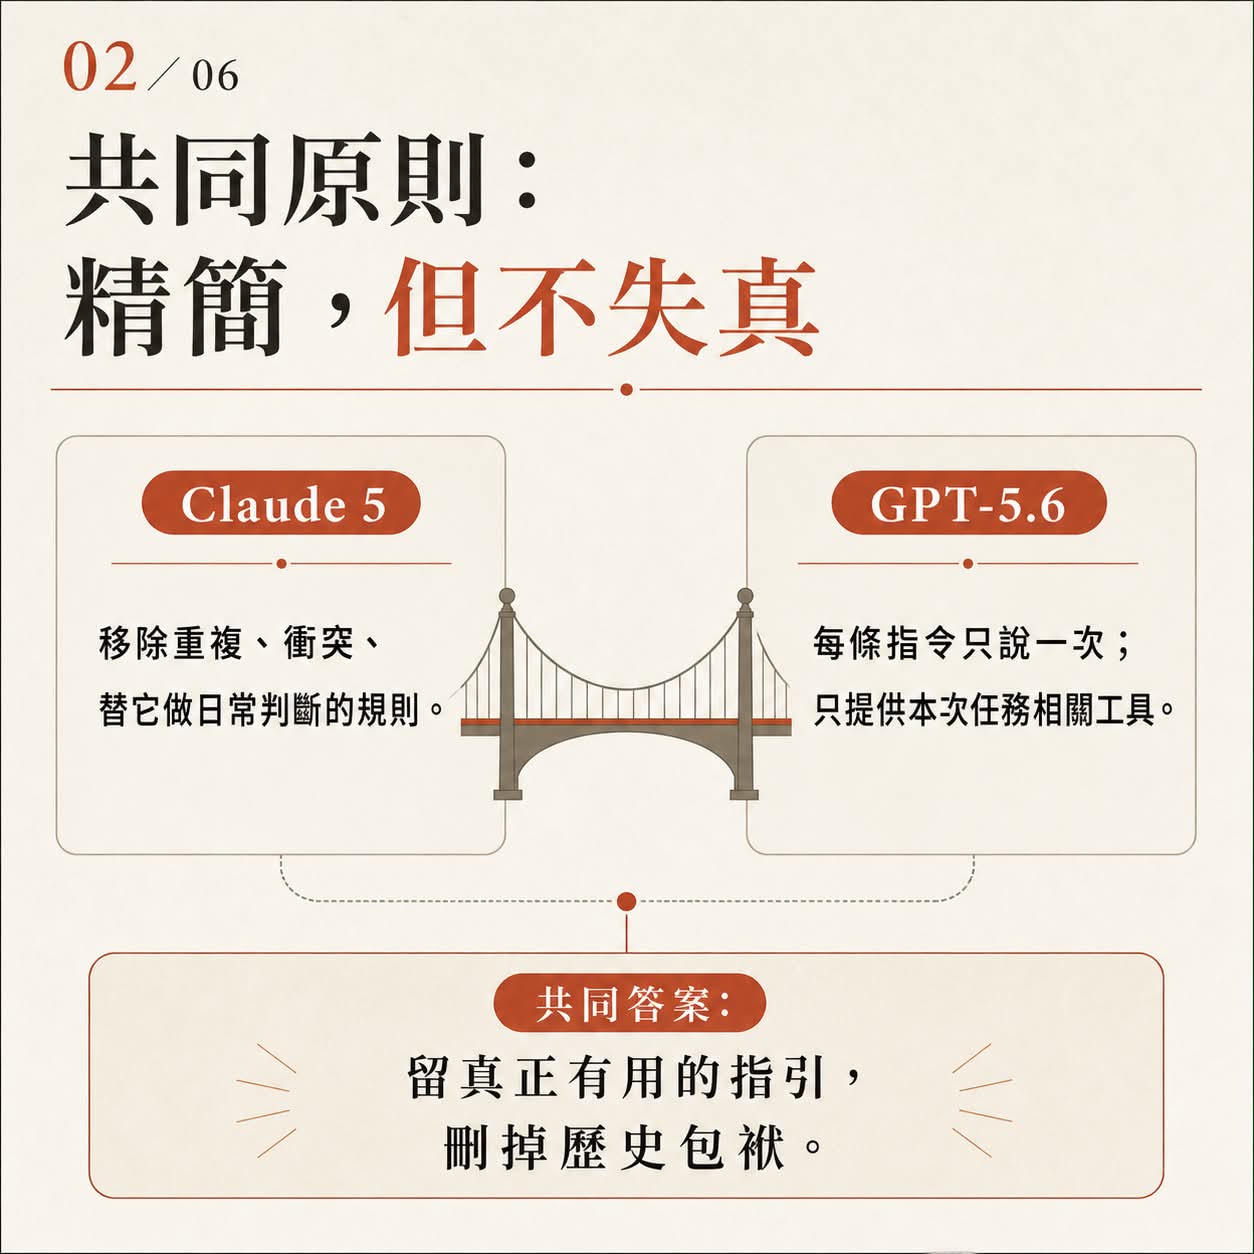
共同原則:精簡,但不失真
Claude 5 那邊講的是移除重複、衝突、以及那些替它做日常判斷的規則。GPT-5.6 講的是每條指令只說一次、只提供本次任務相關的工具。
兩邊的共同答案是同一句話:留真正有用的指引,刪掉歷史包袱。
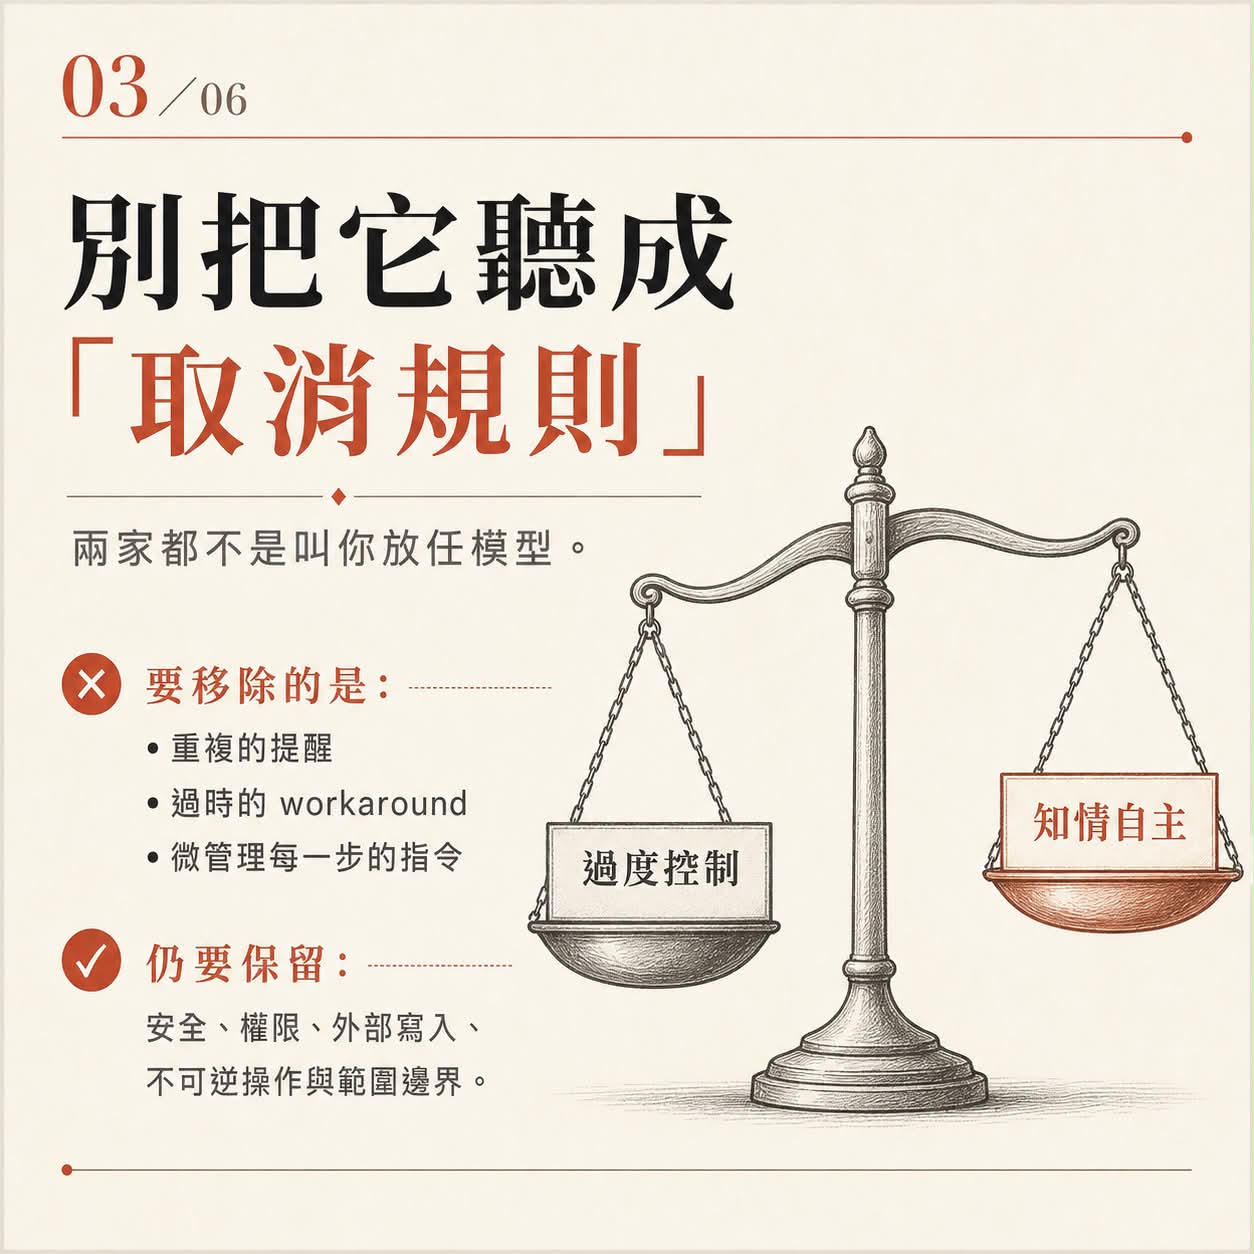
別把它聽成「取消規則」
兩家都不是叫你放任模型。要移除的是重複的提醒、過時的 workaround、微管理每一步的指令。仍要保留的是安全、權限、外部寫入、不可逆操作與範圍邊界。
這個分界不講清楚,後果我看過。有一個極高度推崇自動化的團隊,就是光頭的 CC 團隊,還有他們公司,結果天天都在爆炸。原以為人可以出來收攤,結果他們公司的人是出來提油救火。
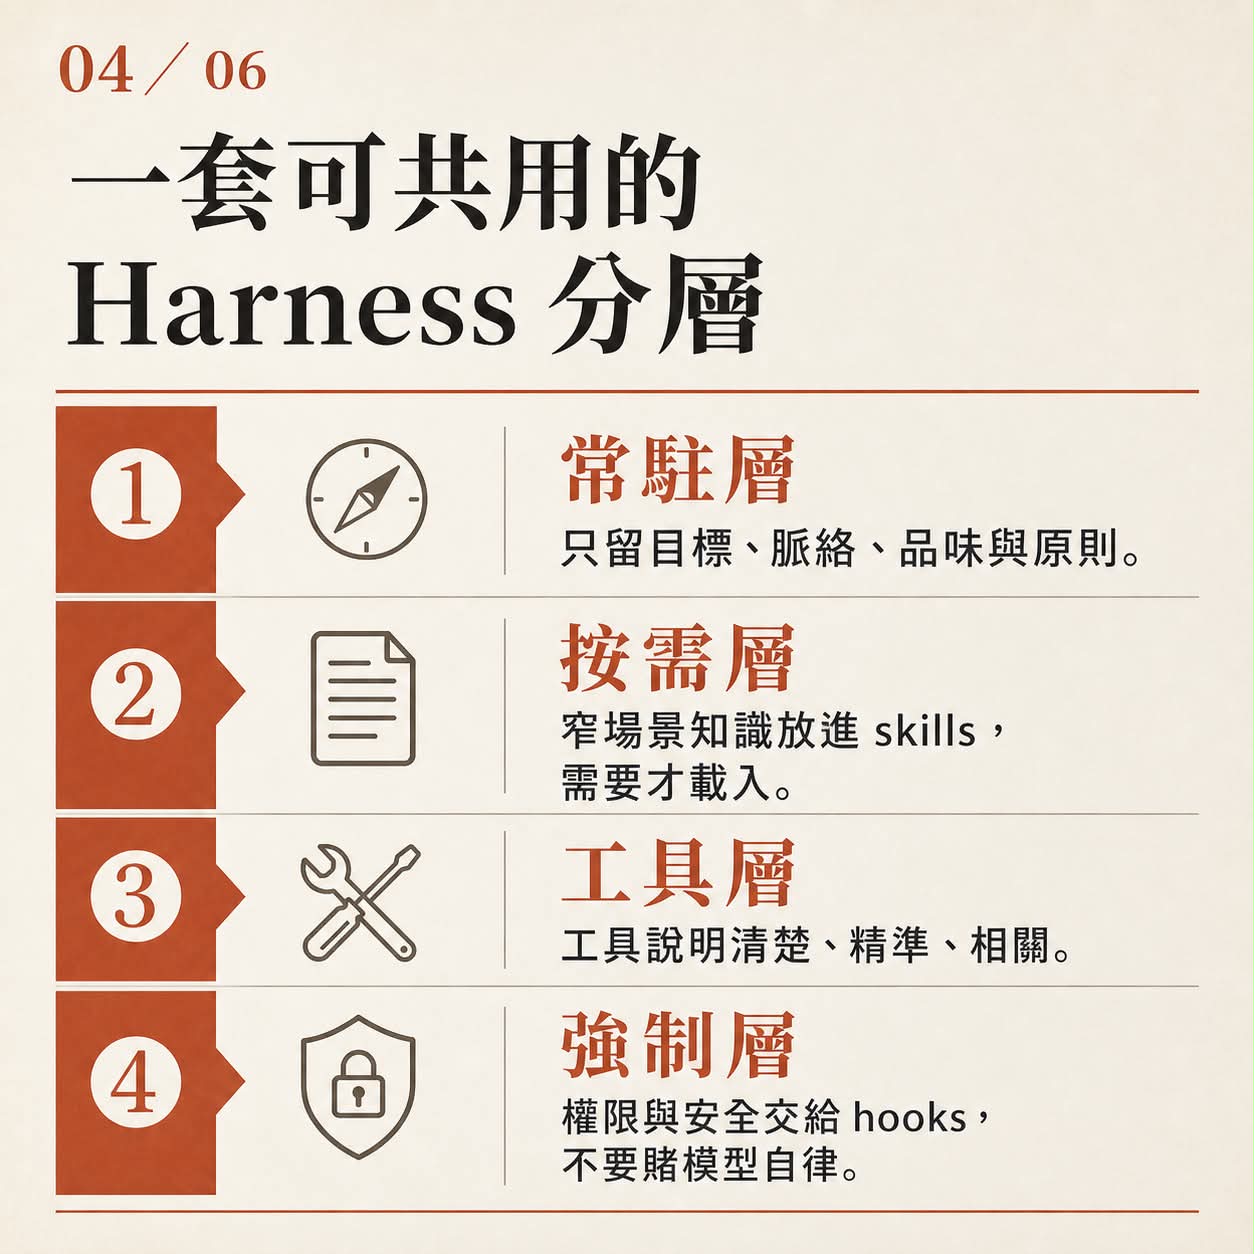
一套可共用的 Harness 分層
我自己整理出來的分層是四層:
- 常駐層——只留目標、脈絡、品味與原則。
- 按需層——窄場景知識放進 skills,需要才載入。
- 工具層——工具說明清楚、精準、相關。
- 強制層——權限與安全交給 hooks,不要賭模型自律。
最後那句「不要賭模型自律」,是被打臉打出來的。我在 CLAUDE.md 寫了「被使用者糾正時禁止說『你說得對』」。結果 Claude 馬上無視,被我罵沒有遵守規則後,下一句回:「你說得對,我不應該違反語言禁令。」
CLAUDE.md 寫的是建議不是強制,真要擋就得用 Hook。這條分界不是理論潔癖,是我付過學費才搞懂該把哪種規則放在哪一層。
驗證要換位置,不是消失
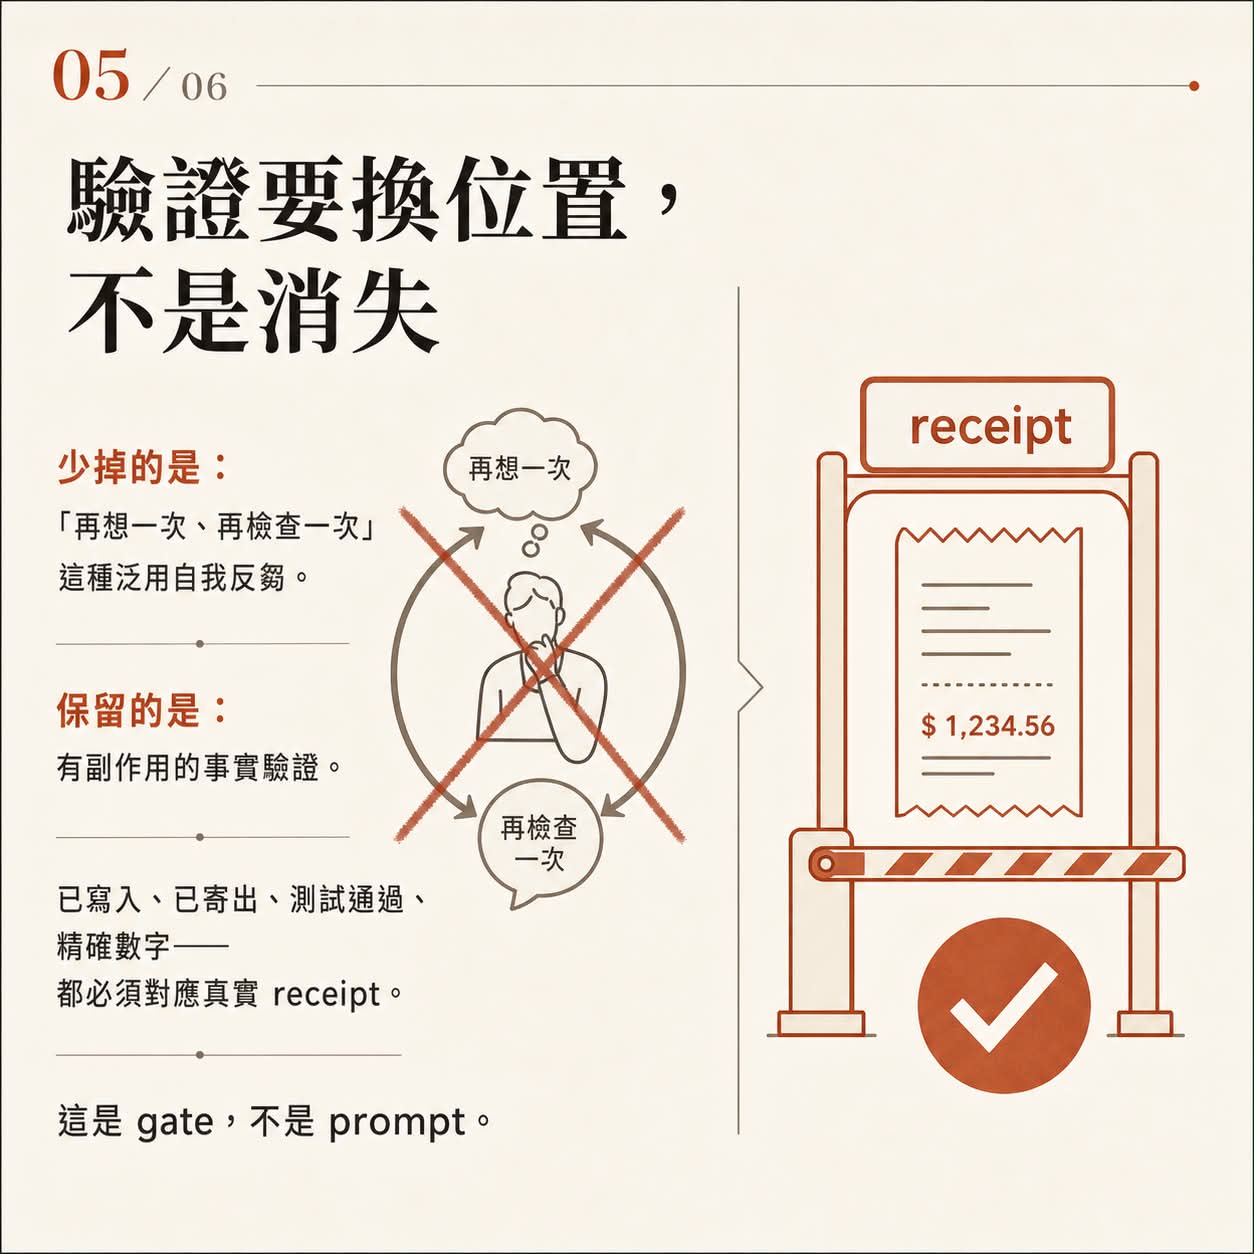
精簡掉的是「再想一次、再檢查一次」這種泛用的自我反芻。保留下來的是有副作用的事實驗證。
已寫入、已寄出、測試通過、精確數字——這些都必須對應真實的 receipt。這是 gate,不是 prompt。差別在於前者你賴不掉,後者模型心情好才理你。
維護好這套分層的紅利是可攜
前幾天的 AI 流水線影片用 Codex 做,現在額度平衡一下(氣死,還不 reset),所以今天這部影片用 Claude Code 做。還好那個開源 repo 裡面的 workflow、skills、內建的 project-level harness 已經寫得夠好,跟我原本的 harness 也很相容,所以換了模型根本沒有障礙,Claude Sonnet 5 high effort 也是一次過。
所以 harness 的個人維護還是很重要的,這樣不管你切哪一個工具,模型都能夠迅速上手接管你的任務。狡兔三窟大概就是這個意思。
教非工程師的時候,順序也是同一套
有人問我,怎麼教非工程師建立安全感。我的教學順序很基礎,但就是這樣:
先請他們把要操作的檔案全部複製一份副本在新的資料夾裡,這是最容易解釋也最讓他們放心的。然後再教不同權限模式,讓他們感受到兩種極端:最嚴的麻煩感覺跟最鬆的不安心感。這時候再推出版控跟 auto mode 這個觀念,他們比較能理解「危險指令有 auto 幫我把關,改壞了有版控也可以幫忙還原」。
不然一開始就教 git 一定一堆問號哈哈哈哈。
這個順序其實跟前面的分層是同一件事:先給邊界,再談自由度。
下一輪怎麼優化
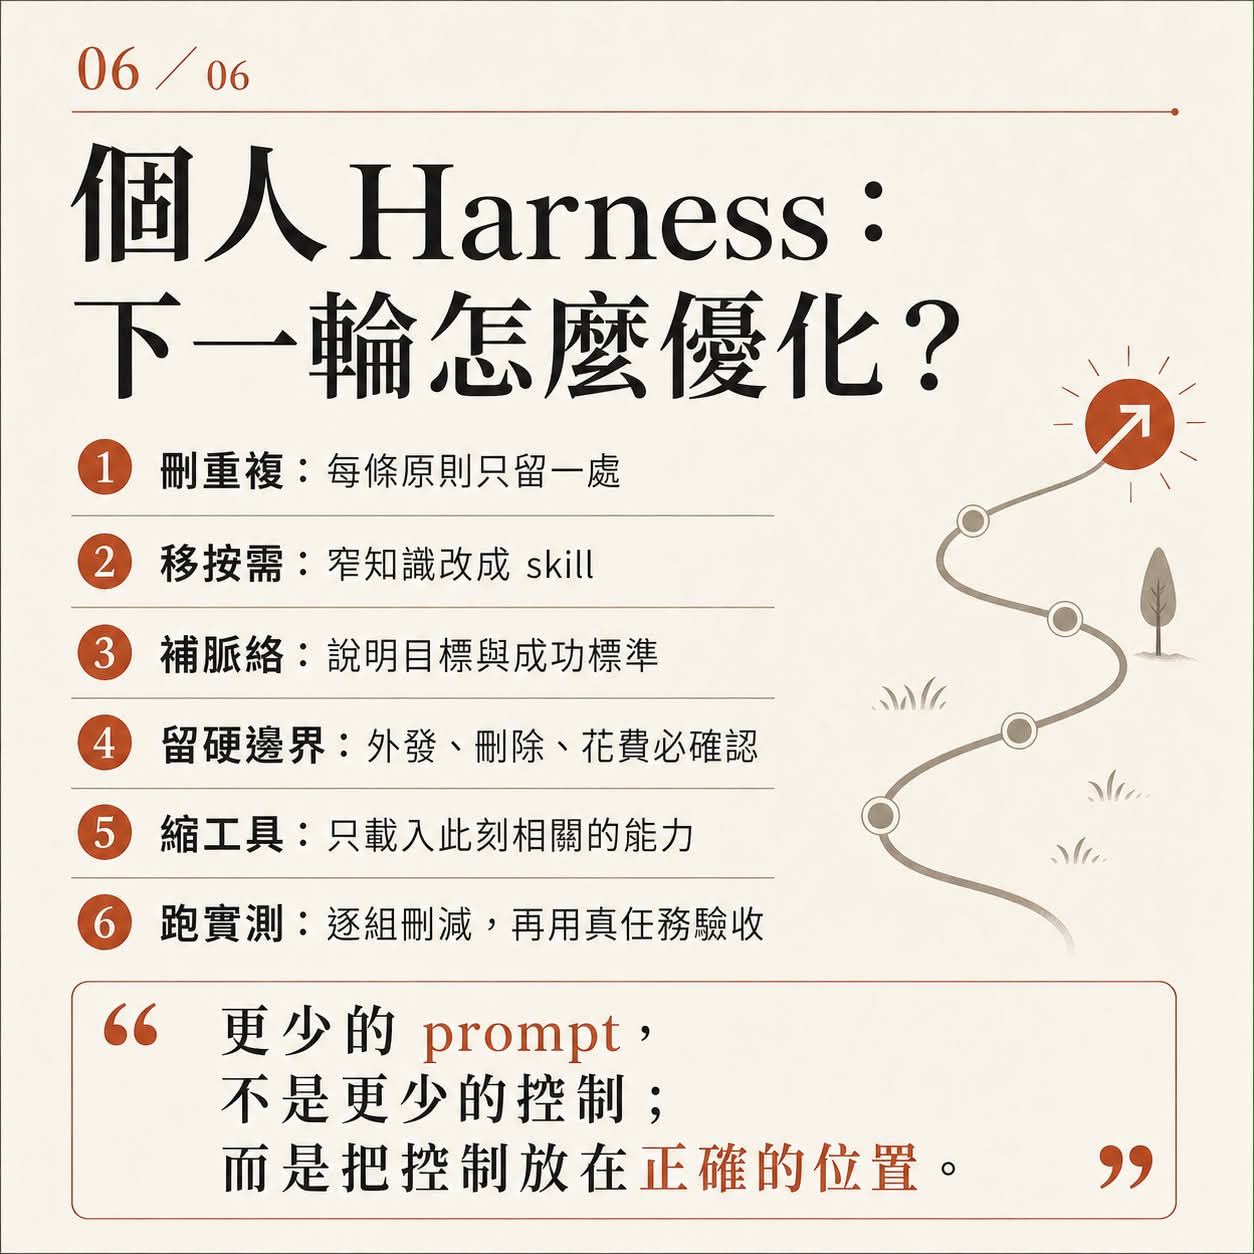
我自己接下來要做的是六件事:
- 刪重複:每條原則只留一處。
- 移按需:窄知識改成 skill。
- 補脈絡:說明目標與成功標準。
- 留硬邊界:外發、刪除、花費必確認。
- 縮工具:只載入此刻相關的能力。
- 跑實測:逐組刪減,再用真任務驗收。
一組不是我做的數字
寫完這些之後,我看到 Schema 團隊在 ARC-AGI-3 的 25 個公開遊戲上做的一組對照:裸跑 API 是 42.83%(Claude Code 基線),外加 harness 是 98.98%。
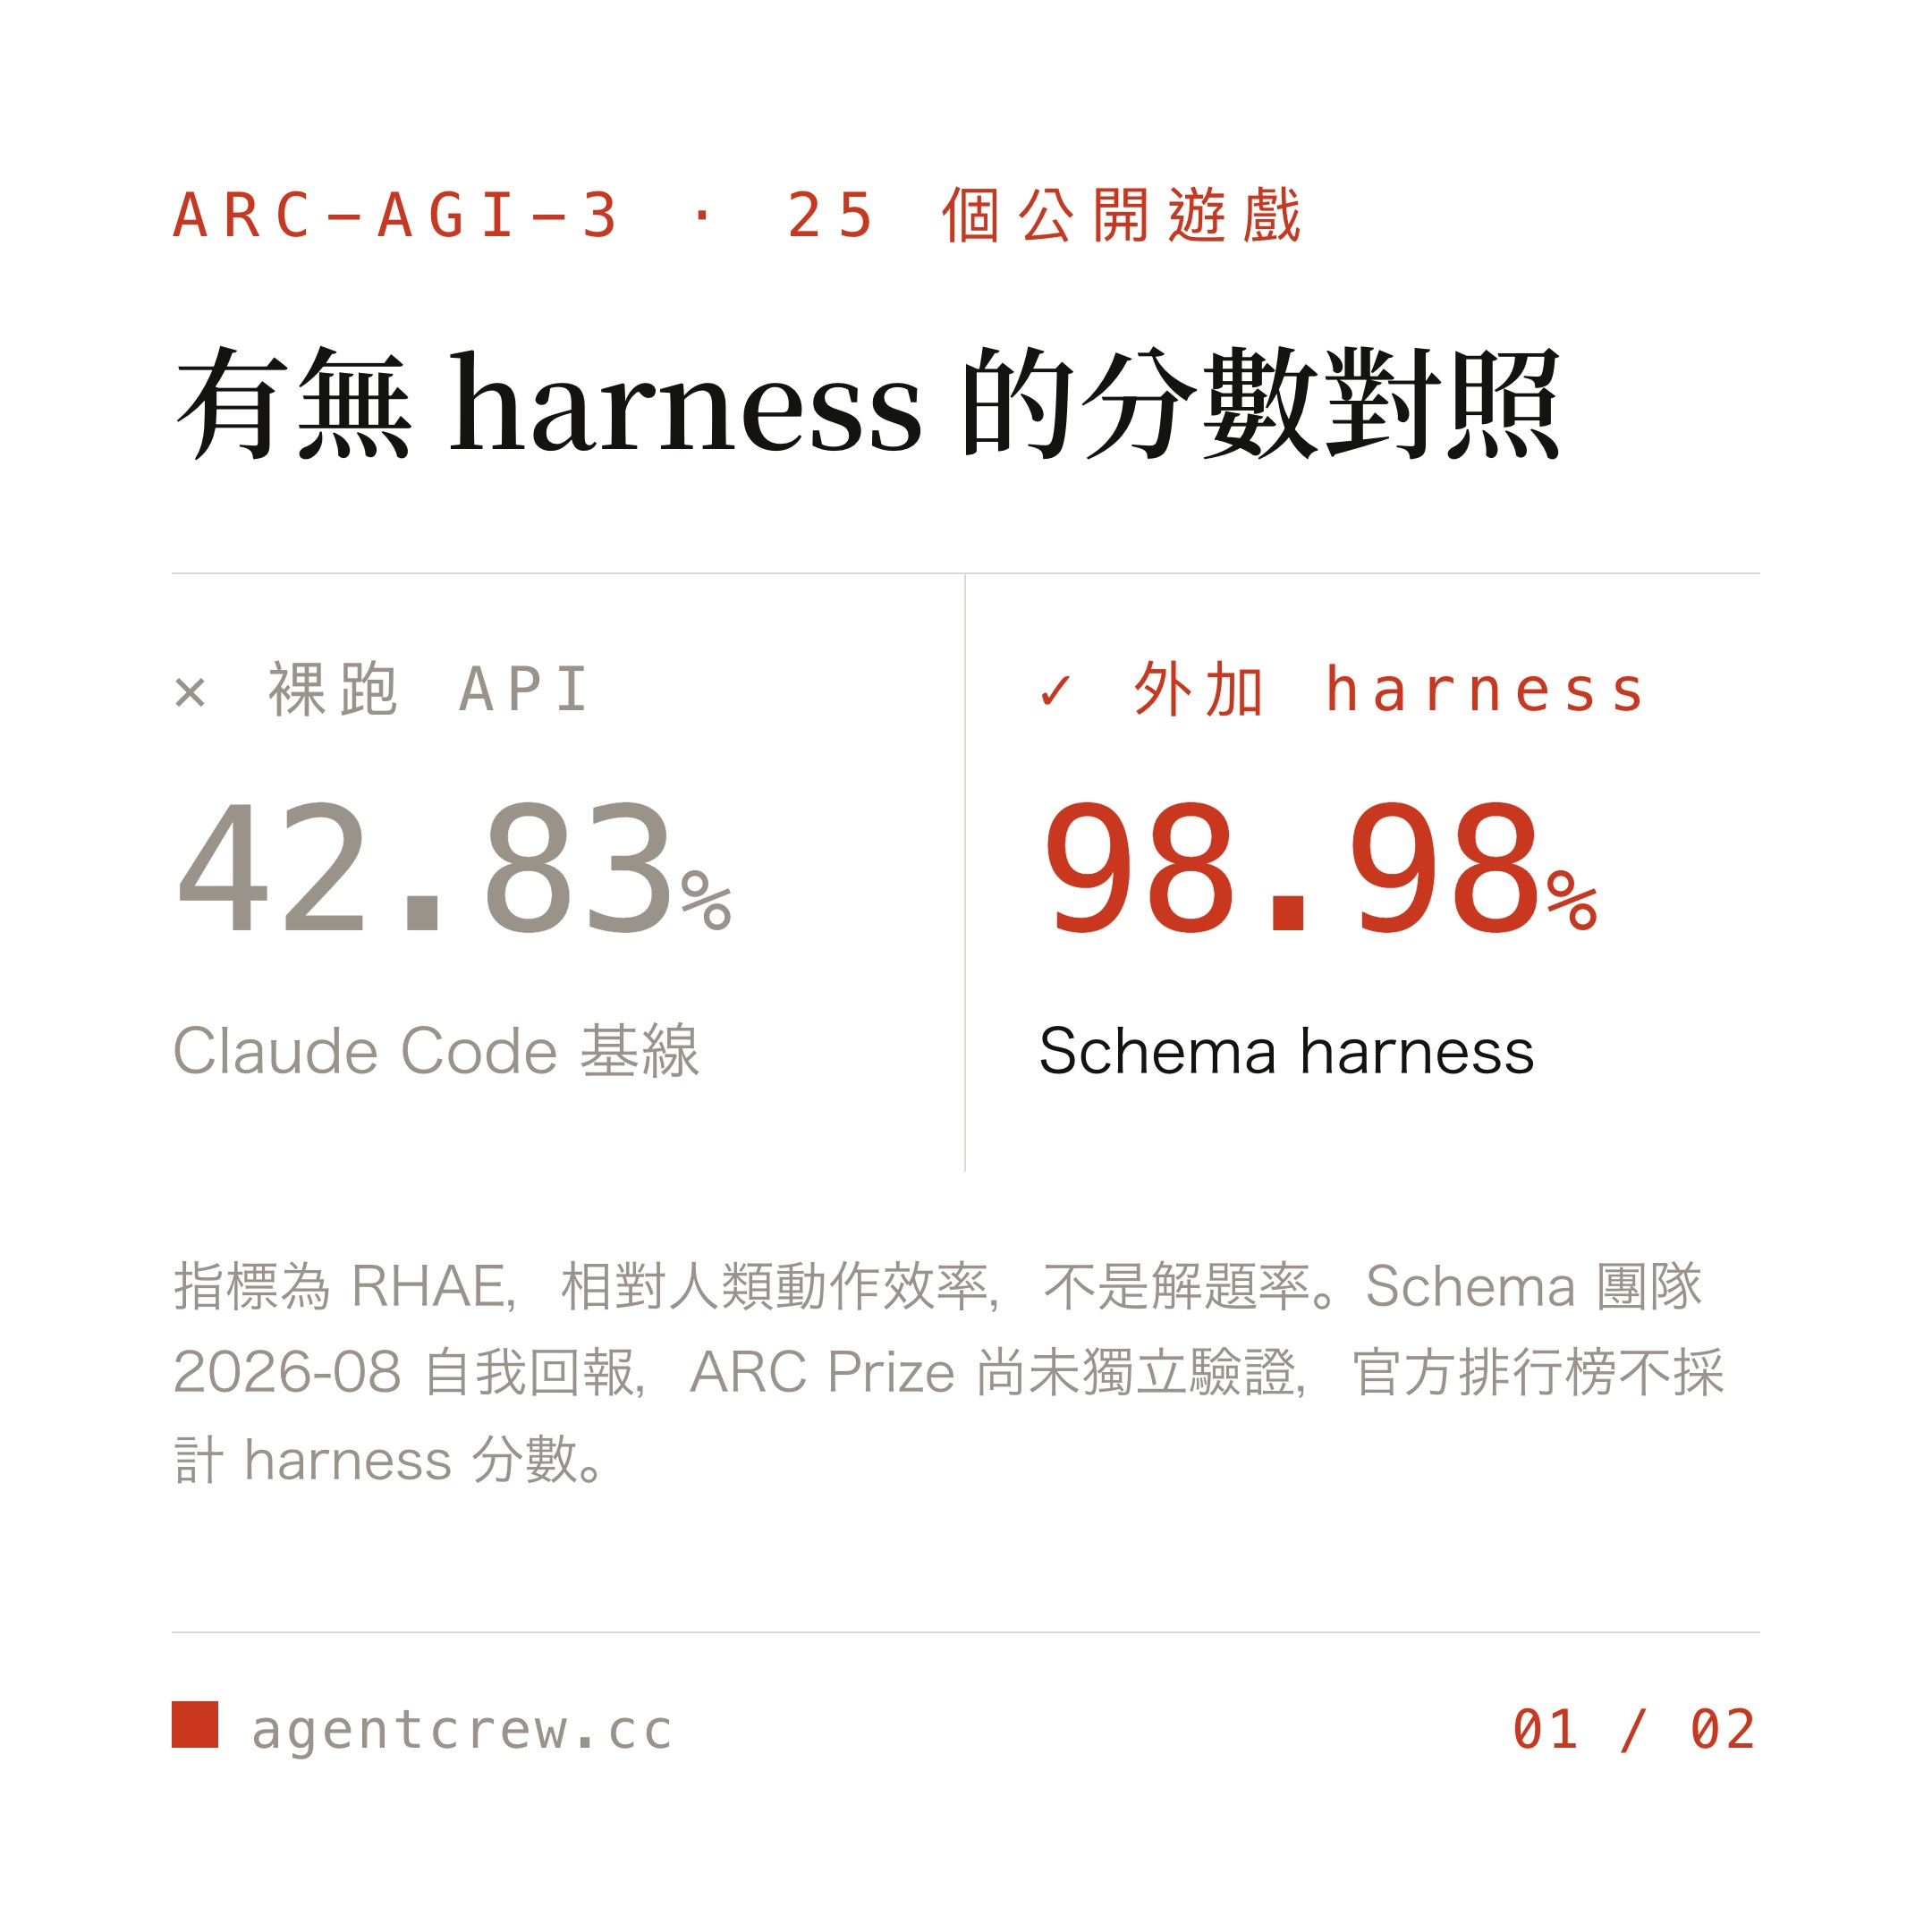
這個數字要打三層折扣才能看:指標是 RHAE,也就是相對人類動作效率,不是解題率;數字是 Schema 團隊 2026 年 8 月自我回報的,ARC Prize 尚未獨立驗證;官方排行榜也不採計 harness 分數。我不打算拿它當證據,只是同一個模型有沒有外殼差這麼多,跟我這一整篇在講的事情是同一件。
同一組圖卡的第二張是他們的一句話,我覺得比數字更值得留著:
harness 降低的是「使用一套理論」的成本,底層模型決定的是「發現一套理論」的成本。
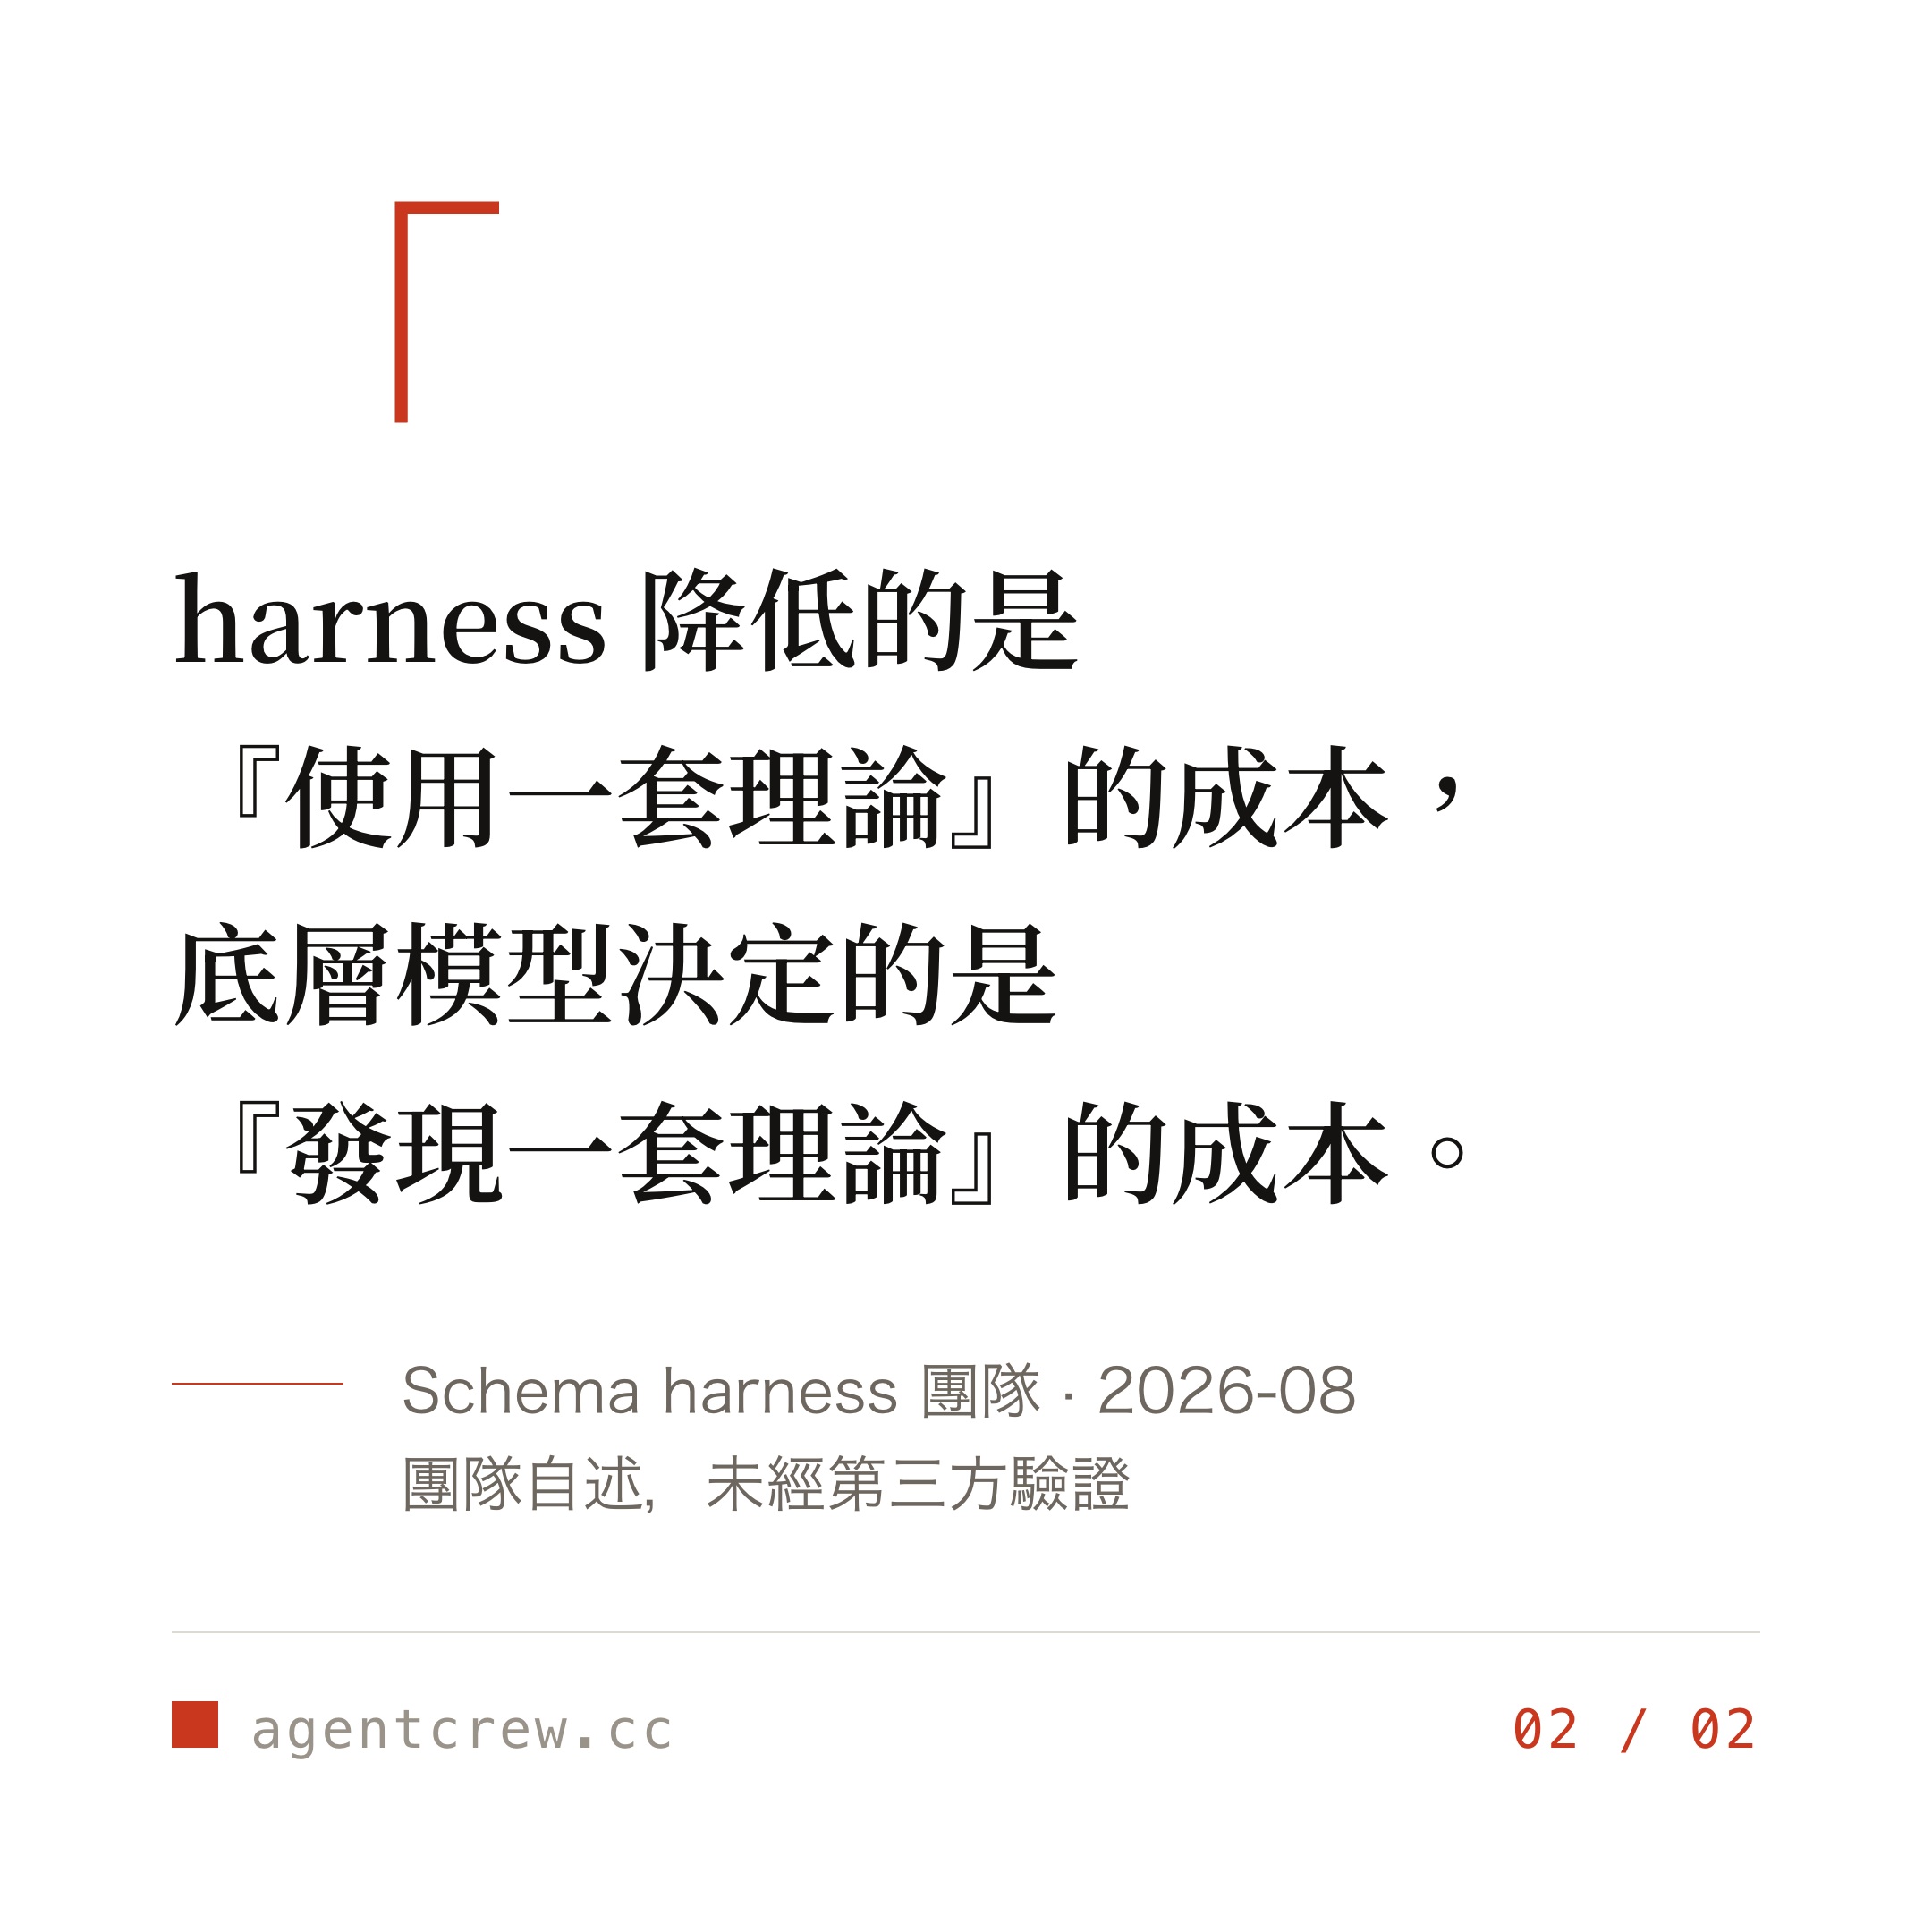
這句話也順便把我上面講的話框住了:harness 值得你花時間維護,但它不會替你長出模型本身沒有的能力。
8 月 2 日我有一場工作坊叫「換模型,不換方法論」,副標是「把你的規則、習慣和工作環境、一起搬走」,對象是非工程背景的 AI 使用者,限額 30 人。海報上我手寫了一張便條:方法在我手裡,環境隨我走。
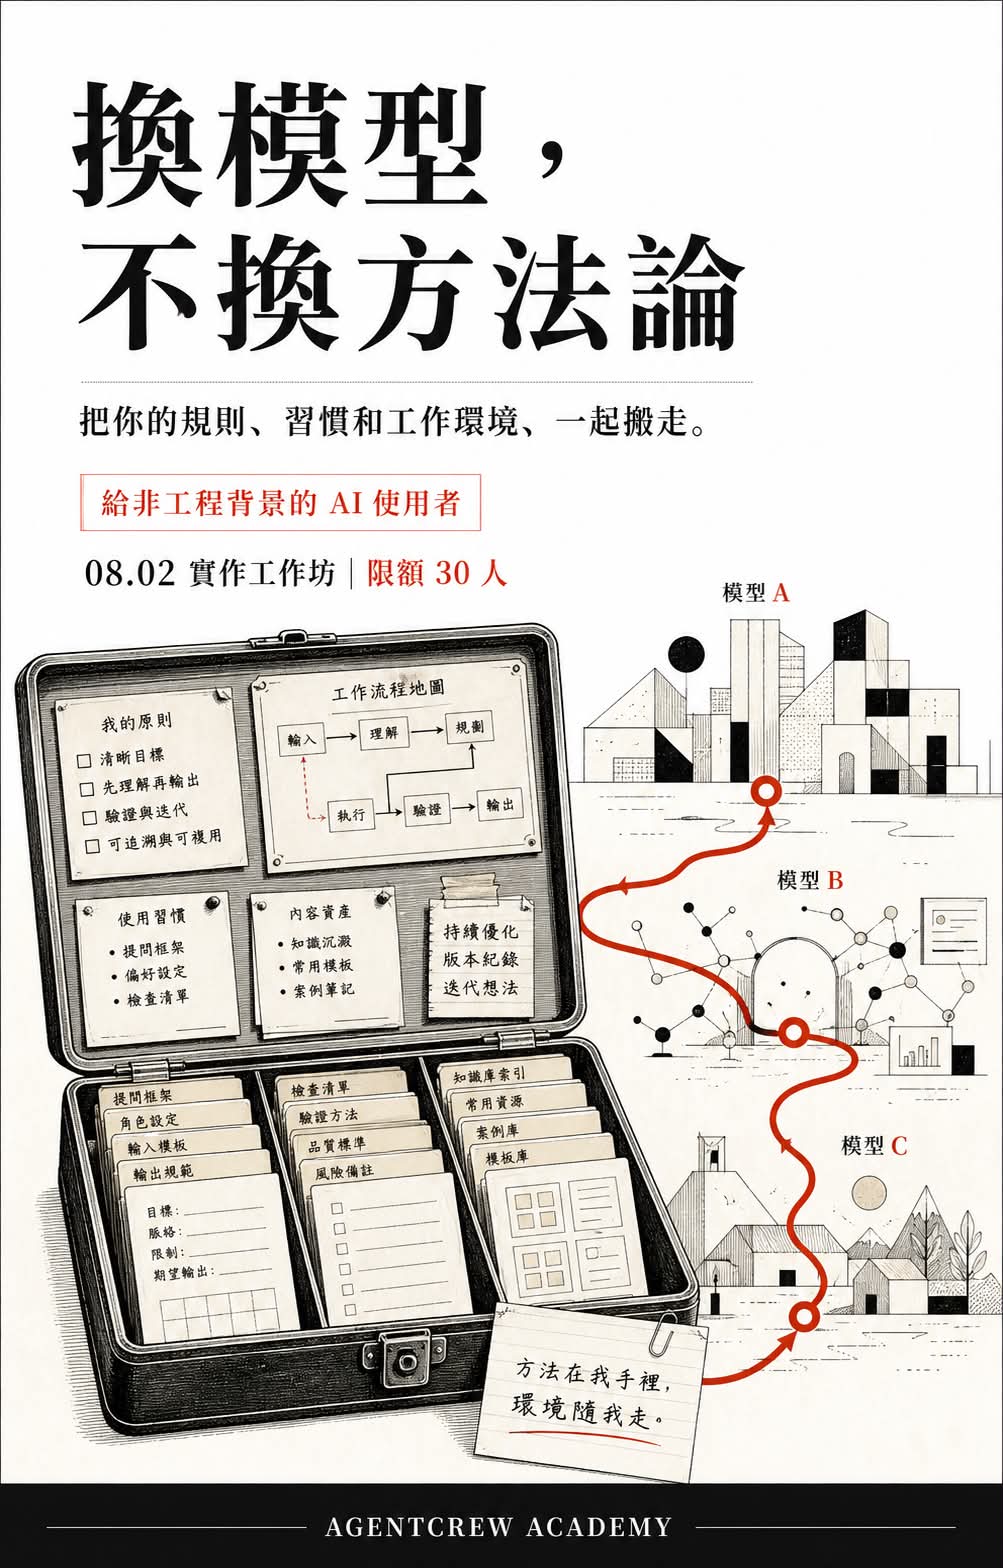
更少的 prompt,不是更少的控制;而是把控制放在正確的位置。