如果你是個人消費者,考慮買硬體架本地模型的目的是為了「省錢」,我建議你再想一想,聽我幫你算這筆帳。
消費級硬體跑得動 agentic 模型,但代價不小
消費級硬體如果想要跑有綜合 agentic 能力的本地模型,首先要先接受能力下降、速度慢的現實。硬體成本至少要課到 10 萬台幣以上,電費另計。很簡單一句話理解:家用怎麼跟機房拼算力?
這裡要跟我之前寫的〈最需要 CLI 的電腦,主人最不可能學會 CLI〉分開看。那篇講的是跑得動小模型的門檻——那個門檻確實沒那麼高。這篇講的是跑得動有綜合 agentic 能力的模型要花多少錢,是兩個不同的問題。
商用模型已經卷到流血價
如果是想要養一些本地模型幹雜活,那其實也有更好的選擇。現在很多商用模型都卷到流血價了。GPT 5.6 Luna 最便宜,擅長瀏覽器與電腦操作;Gemini 3.7 Flash 我體感上比 Sonnet 5 略強,價格也是對半折,還有原生影音多模態,甚至額度可以當作是買雲端硬碟送的,根本用不完,跑一整晚都不會心疼。在這種價格之下我覺得甚至沒必要去追中國更便宜的 provider。
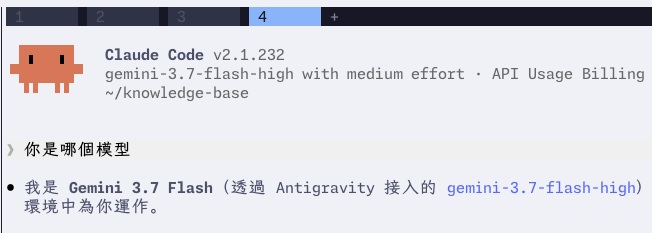
圖為昨晚發布的 3.7 Flash,已經接入 Claude Code,能力已經可以用在正常工作。
唯一不可取代的優勢是隱私
本地模型唯一不可取代的優勢,就是機密資料隱私保護。如果確實有這方面的需求,那買一個剛好能跑資料去敏小模型的硬體就差不多了。讓資料在半夜閒置時間透過本地模型去敏,白天工作送給商用 AI 處理後,再在本地還原。這樣會是最合算的選擇。
去敏需求可以考慮參考這個:https://github.com/danyuchn/pii-guard。先用 regex 做大部分的去敏,最後再讓本地小參數模型掃漏,就算受硬體限制無法很聰明,也能夠圓滿完成任務。
買硬體之前,你的評測本身可能就是假的
我這幾天在做本機模型的橫向評測,連續踩到三個坑,全部指向同一件事:你以為在評測本地模型,其實在讀錯數字。
第一個坑是舊欄位。我引用了當天稍早跑出來的 benchmark 欄位,因為欄位名稱一樣就直接拿來比——但那時候的題目版本跟現在不同。光這一條就推翻了六個結論,包括「兩顆模型總量死平」(實際上快 16.5%)、「某顆慢 3.2 倍」(實際只差 4%)。修法很土:兩邊共同格的 prompt token 數只要對不上,就直接拒絕比較。兩個模型共用同一套 tokenizer,同一題的 token 數不可能不同,數字對不上就必然是題目被改過。
第二個坑是我拿來當「能力值」的那個欄位,其實取的是最大值。它會跳過中間沒過的格子——某顆模型的「5」實際上乾淨跑完的只有 1,而我拿這個 5 去跟人家比,報了整整一輪。反過來另一種算法又會低估:爬梯子遇到洞就停,洞之上的格子永遠沒被測到。要比能力就得兩邊都把格數補齊,只補一邊等於用兩套標準。
第三個坑是我用 curl 打端點驗相容性。帶 system、帶 tools、帶 streaming 全部正常回應,我就以為之前記錄的故障已經過期了。實際跑帶工具迴圈的 claude -p 才發現,故障只在需要「自動生成 tool parser」那條路徑上才觸發,而 curl 探針根本走不到那裡。驗相容性只認實跑。
三個坑加起來的意思是:在你決定要不要花十萬塊之前,先確認你手上那組決定要不要花錢的數字是真的。