我在 Threads 隨手分享過一個做法:請 AI 撈出自己所有的對話紀錄,依自己的任務做一份專屬的模型評測集,每次新模型發布就拿同一套去考。這篇把這個做法完整寫出來。
我會依序講四件事:為什麼官方跑分幫不了我、這份考卷三週內怎麼長大、每一輪考出了什麼,以及我實際下的提示詞。最後附一份起手範本。想知道評分和執行怎麼做的,可以直接跳到附錄:技術做法。
這是我在 Threads 的原文:
建議一次性的請AI撈你的所有chat session jsonl log,根據自己的任務做屬於自己的模型評測集
比如我的評測集就有長文抽取、待辦規劃、合約審閱、課程教案等類別,每個類別5-8題
每次發新模型,我就拿同一套來測,不同effort都測一次然後跟現有model的紀錄比較 現在額度耗費也都可以算得出來了
額度、速度、effort、模型等等都拿到了之後 自然知道該怎麼根據新模型調整任務分配
每週一封,只挑跟你工作有關的 AI 動態。免費訂閱電子報 →
原本的困擾
第一個困擾是新模型出得太快。我手上同時有 Haiku 5.5、Sonnet 5.5、Opus 5.5、Fable 5.1 四個 Claude 模型,外加 Gemini(透過 agy)、Codex,還有能在 Colab 上跑的開源模型。每次新模型發布,網路上都是官方跑分和別人的心得,但我真正想知道的只有一件事:它能不能接手我現在交給更貴模型的工作。
第二個困擾是思考檔位(effort)。同一個模型有 low、medium、high 好幾檔,我一直不知道自己的工作開到哪一檔才夠。後來請 AI 翻派工紀錄,14 天 446 次派工有 94% 沒設檔位,等於全部用預設值在跑。開太高浪費額度和時間,開太低又怕漏東西,但我沒有數據可以判斷。
第三個困擾是額度。我同時有 Claude、agy、Codex 三個訂閱額度,每個池子的計算方式都不一樣,Codex 還有五小時一個窗口的上限。我想把查核、摘要這類大批工作分給外部模型,Claude 的額度留給只有它能判斷的事。但哪類工作分給誰,我只能憑感覺。
這份考卷長什麼樣,一路怎麼長大的
考卷的題目全部來自我自己的工作。第一版是 10 月 8 日 Haiku 5.5 發布那天做的,那次的細節我寫在〈Haiku 5.5 能接 Sonnet 的活嗎?〉。簡單講,AI 翻了我 45 天、761 次的派工紀錄,挑出「次數多、而且現在交給貴模型」的工作,做成 8 題困難題和 5 題確認沒退步的題目。
現在最常拿來考的有十題,每一題對應我實際在做的一類工作:
- 長檔抽取:照規格從一份 62 分鐘的訪談逐字稿抽出整理好的資料,要逐字引句。
- 長文件摘要:讀一份長文件,回答指定問題。
- 事實核對:草稿裡有 13 條主張,逐條對照知識庫主檔判斷對錯。
- 對外文案紅隊:照公開規則找出不該出現的客戶名、內部代號和不一致的數字。
- 死連結掃描:找出文件裡指向不存在檔案或 skill 的引用。
- 程式找 bug:審一支驗證程式,找出埋好的錯誤。
- 金流對帳:算某個月的實收淨額,時區和金額單位都有陷阱。
- 待辦路由:讀一份工作摘要,照知識庫規則決定每件待辦該寫到哪裡、寫成什麼格式。
- 多重要求:一則訊息裡塞五個要求,有的藏在括號裡,有的是否定句。
- 多條規則同時守:給一份 40 條的規則檔,看它能不能同時守住其中 6 條。
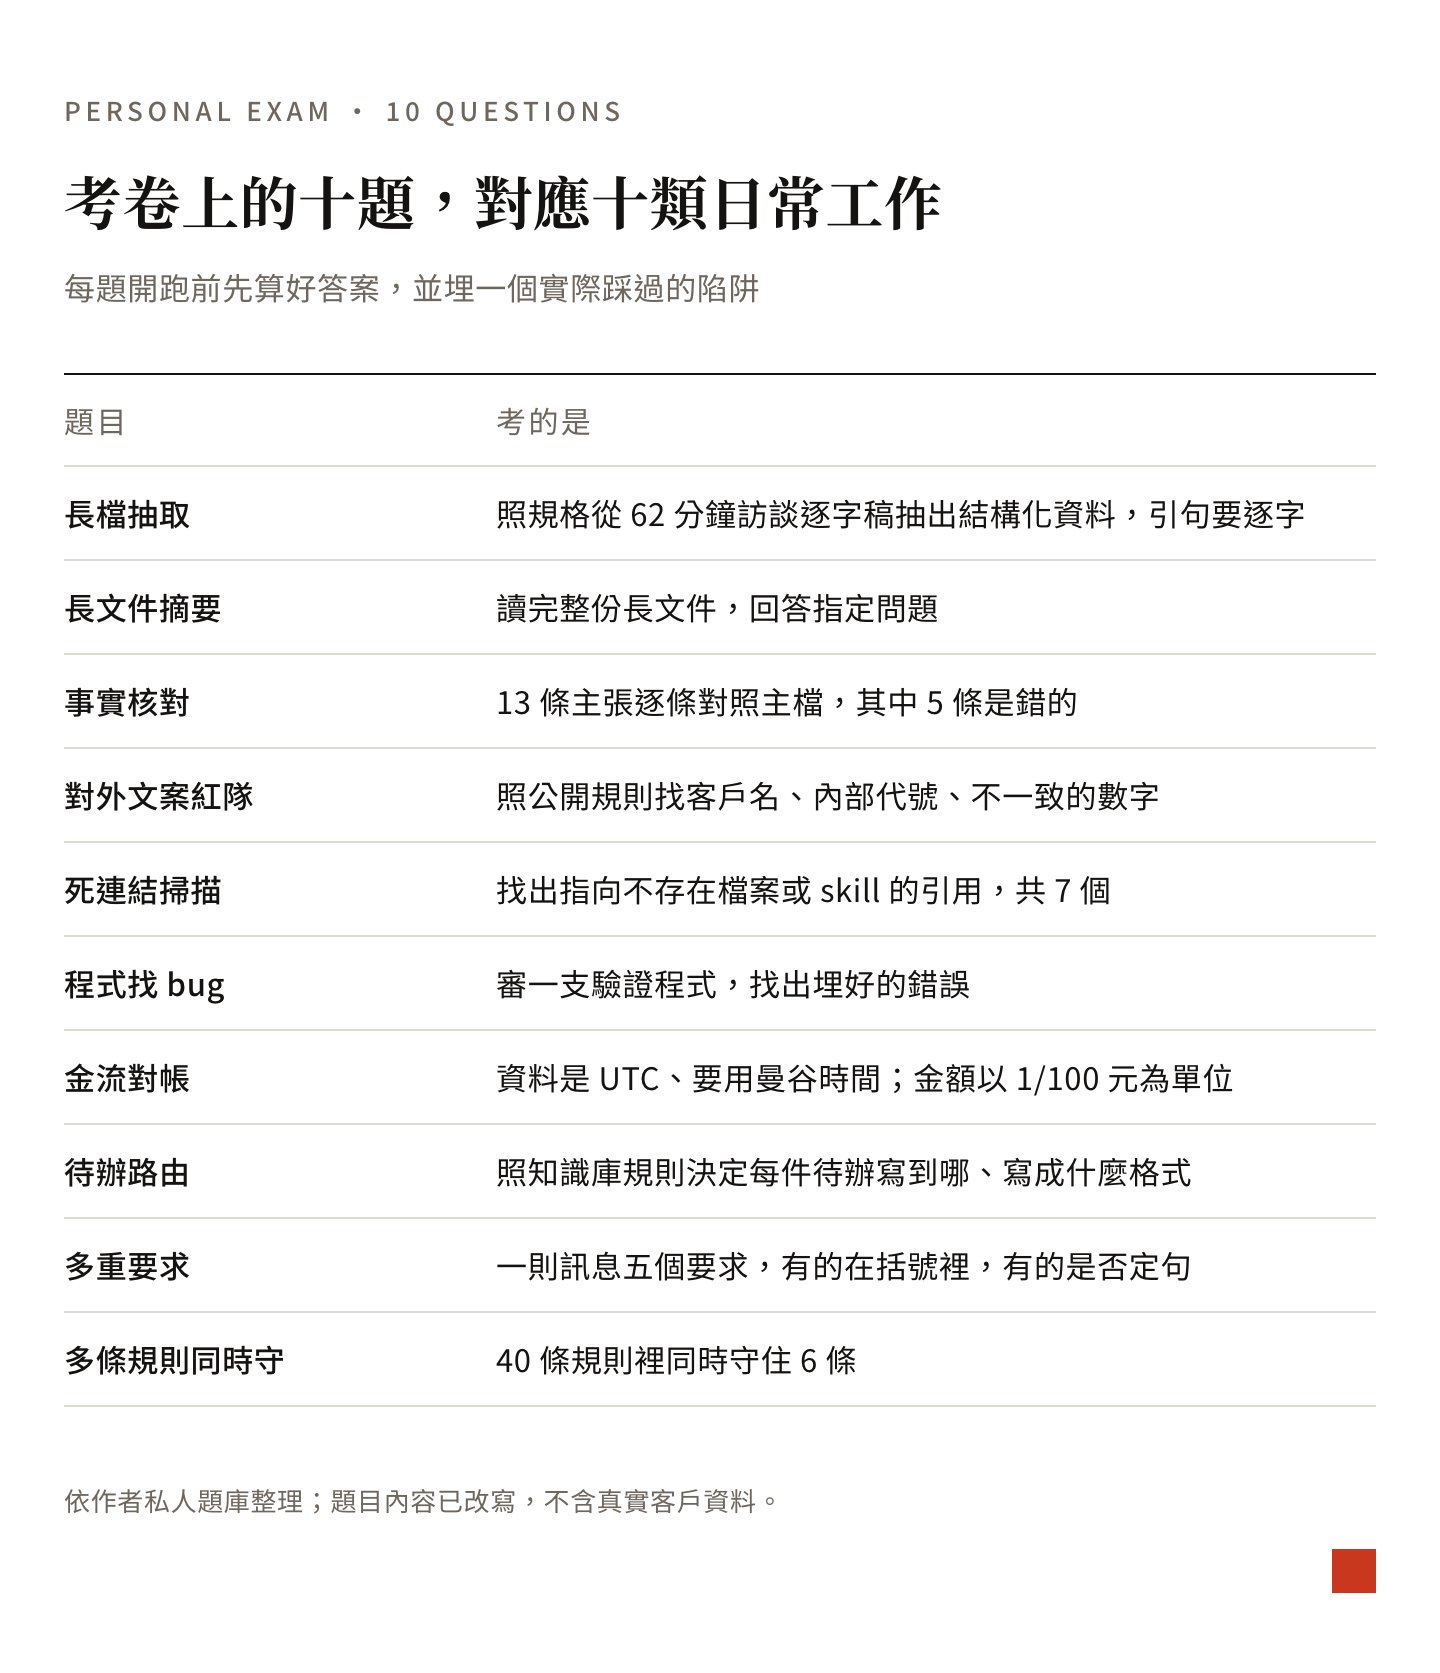
每一題都有三個共同點。第一,開跑前就算好標準答案。第二,每題都埋陷阱,評分程式知道掉進陷阱會得到什麼錯誤答案。第三,在空的資料夾裡、用唯讀權限跑,受測模型讀不到答案檔。
這份考卷三週內被拿來考了好幾輪:
- 10 月 8 日:Haiku 5.5 發布,做出第一版考卷,Haiku、Sonnet、Opus 一起考。
- 10 月 10 日:Opus 和 Fable 各開三個檔位,考同樣七題,看主力模型該開哪一檔。
- 10 月 16 日:Opus low 和 medium 各考三次。這次加了「多重要求」和「多條規則同時守」兩題,因為我實際用的時候最常看到它漏的就是這兩種。
- 10 月 20 日:同一份考卷拿去考外部模型:agy 裡的 Gemini Flash 和 Argon、Codex 的 Astra,還有放在 Colab 上的開源模型。
- 10 月 21 日:Codex 另外考三題真實的程式修補,用我自己產品的舊 bug 重播。
- 10 月 24 日:拿兩件真實工作給 Haiku 做,看它能不能接手收尾和離線計算。
每一輪考出了什麼
先講範圍。每一題、每一種設定至少跑兩次,Claude 的模型多數跑三次。結論看最低分,不看平均分,因為平均分會把「偶爾漏一半」藏起來。花費的部分,Claude 用 claude -p 回報的換算金額,agy 和 Codex 看每週額度用掉幾個百分點。
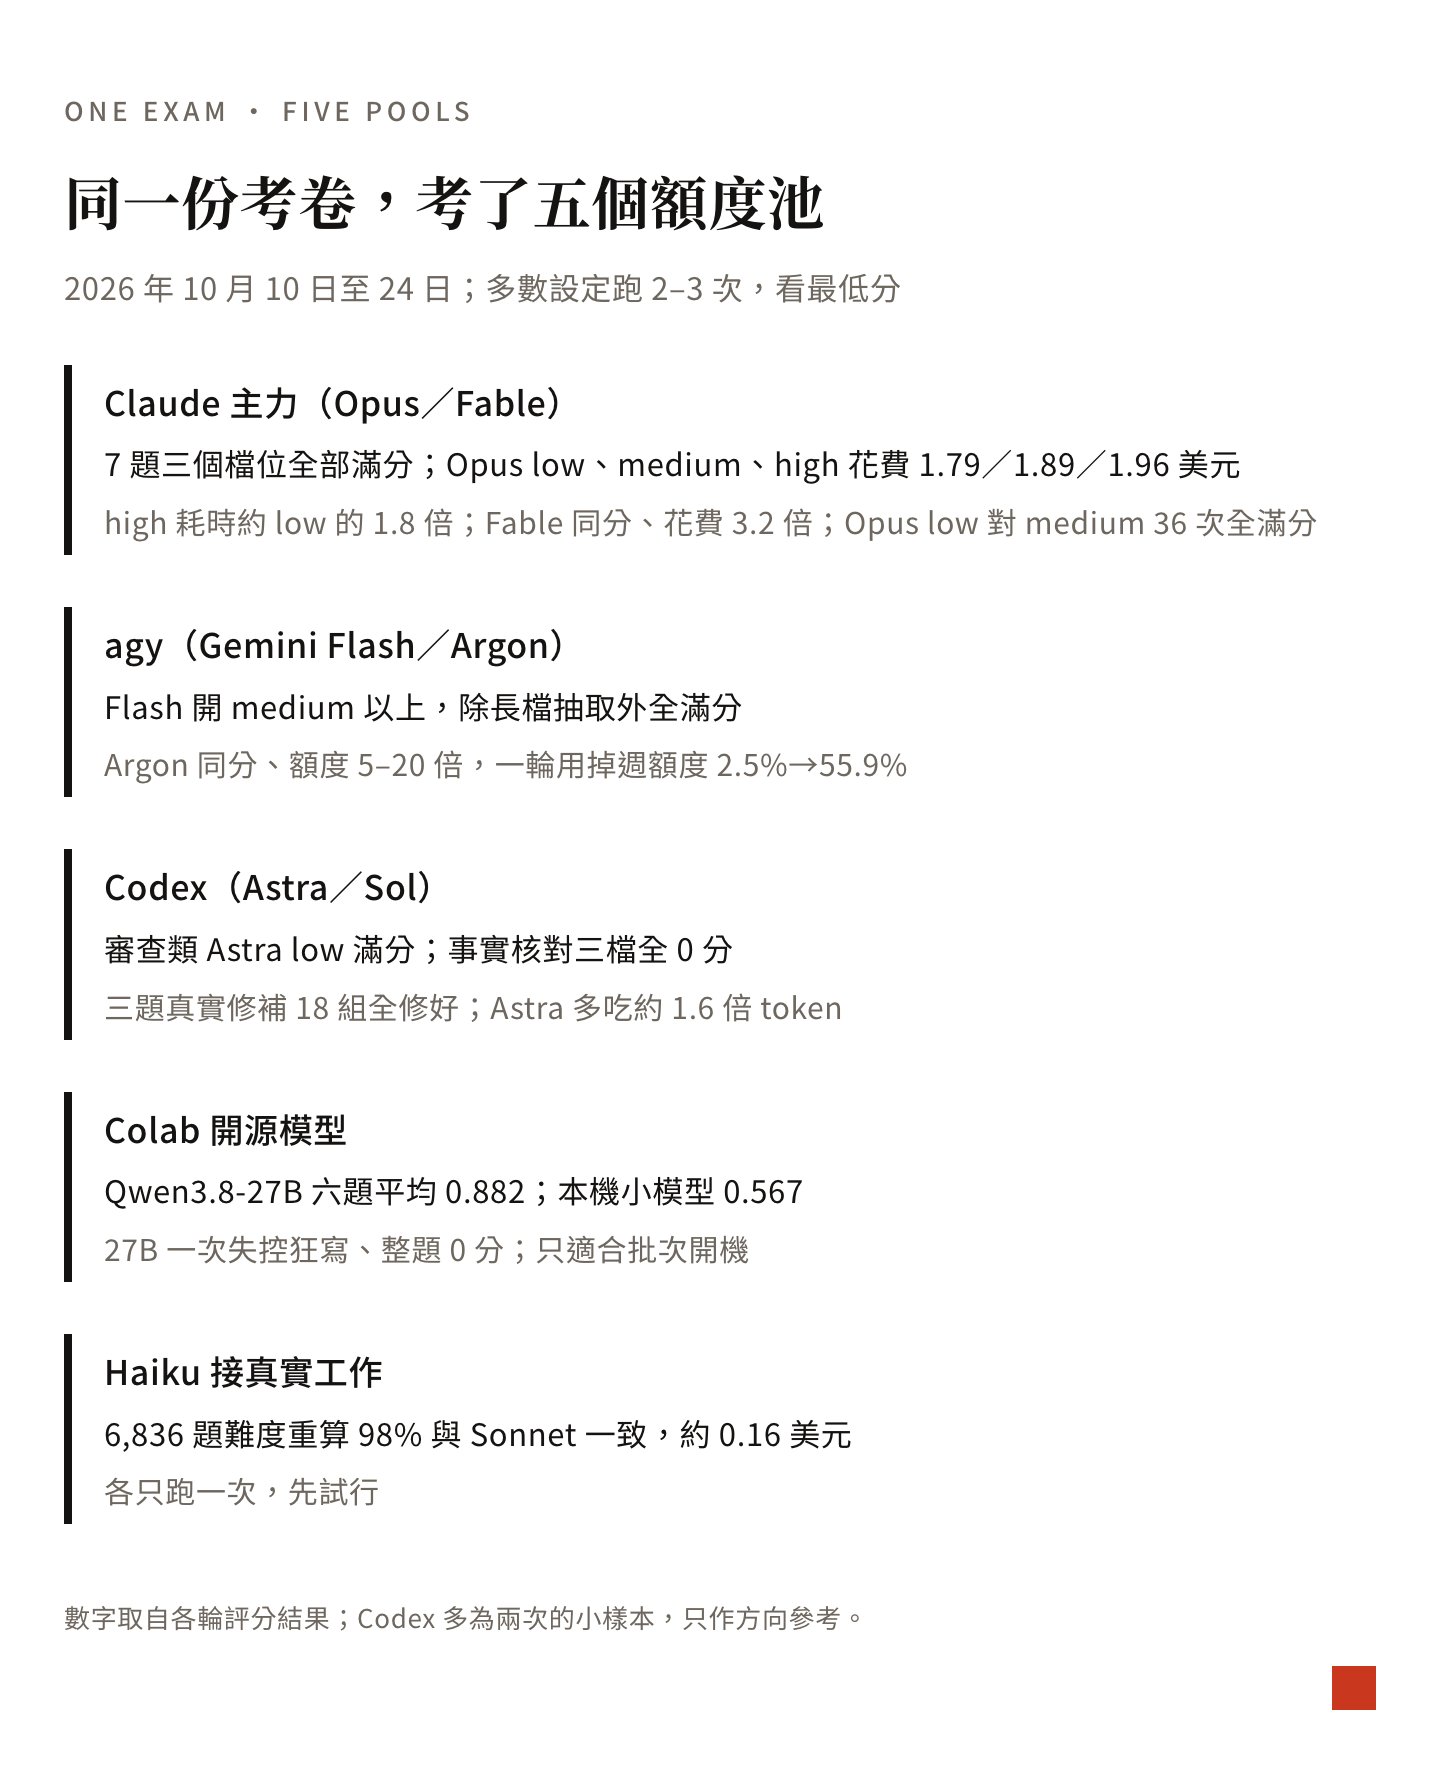
Claude 的主力模型,low 就夠了。 10 月 10 日那輪,七題 Opus 和 Fable 三個檔位全部滿分。Opus 七題的花費 low、medium、high 分別是 1.79、1.89、1.96 美元,high 的耗時約是 low 的 1.8 倍。Fable 雖然同分,但花費是 Opus 的 3.2 倍。10 月 16 日補測變異,Opus low 和 medium 各三次,36 次全部滿分。需要多次查檔的題目,low 快了 1.5 到 2.4 倍,例如程式找 bug 是 36 秒對 67 秒,待辦路由是 23 秒對 55 秒。medium 唯一多出來的是深度:程式找 bug 三次裡有兩次多報了不計分的額外問題。
agy 的 Flash 是主力,Argon 幾乎不值得。 6 組設定、6 題、各兩次,共 72 筆。Flash 開 medium 以上,除了長檔抽取都拿滿分;開 low 在找 bug 和待辦路由會掉分,待辦路由有一次整份沒有輸出。Argon 分數一樣,但吃掉的額度是 Flash 的 5 到 20 倍,這一輪 Argon 的週額度從 2.5% 用到 55.9%。長檔抽取是唯一拉開差距的題目:Argon medium 0.86,Flash high 0.80。另外抓到一個坑:Flash medium 在長檔抽取逾時,回了空字串,狀態卻顯示成功。
Codex 的 Astra 適合審查,不適合事實核對。 程式找 bug、紅隊、死連結掃描,Astra low 都是滿分。high 反而在找 bug 時掉分,耗時約是 low 的 1.6 倍(105 秒對 65 秒),輸出量約兩倍。事實核對這題,Astra 三個檔位全部 0 分,而且 6 次裡有 5 次答案一模一樣、錯在同一個地方。另外三題真實的程式修補,Sol low、Sol medium、Astra low 共 18 組全部修好,也都沒有動到測試檔。Astra 修補一樣全對,但多吃約 1.6 倍的 token。
這輪也發現額度才是真正的瓶頸。Codex 的五小時窗口,大約 14 筆 Astra 的審查題就用滿了。
開源模型能當批次工具,不能當常駐助手。 我把 Qwen3.8-27B 放上 Colab,接回本機的 Claude Code 當分工助手,六題平均 0.882,跟 agy Flash medium 的 0.897 差不多。但它有一次在長檔抽取失控狂寫,單次輸出超過上限,整題 0 分。本機跑的小模型平均只有 0.567,金流對帳兩次都掉進「金額以分為單位、要除以 100」的陷阱。Colab 開機要 3 到 5 分鐘,只適合累積一批工作、開機跑完再關掉。
有時候差距來自提示詞,跟模型無關。 10 月 21 日我想把一個本機例行檢查換成微調過的模型,用 61 筆資料考。原版模型配正式提示詞只有 0.458,微調版 0.602,看起來微調有用。但原版模型加上三行判斷標準,就到 0.856,比微調版加同樣三行的 0.835 還高。所以模型沒換,只補了那三行。
最後,拿真實工作確認。 10 月 24 日讓 Haiku 做一件離線計算,6,836 題的難度重算有 98% 跟 Sonnet 原本的結果一致,花費約 0.16 美元。另一件是收尾工作,寫日誌、更新主檔、清檔案都正確,只漏答一個小問題。
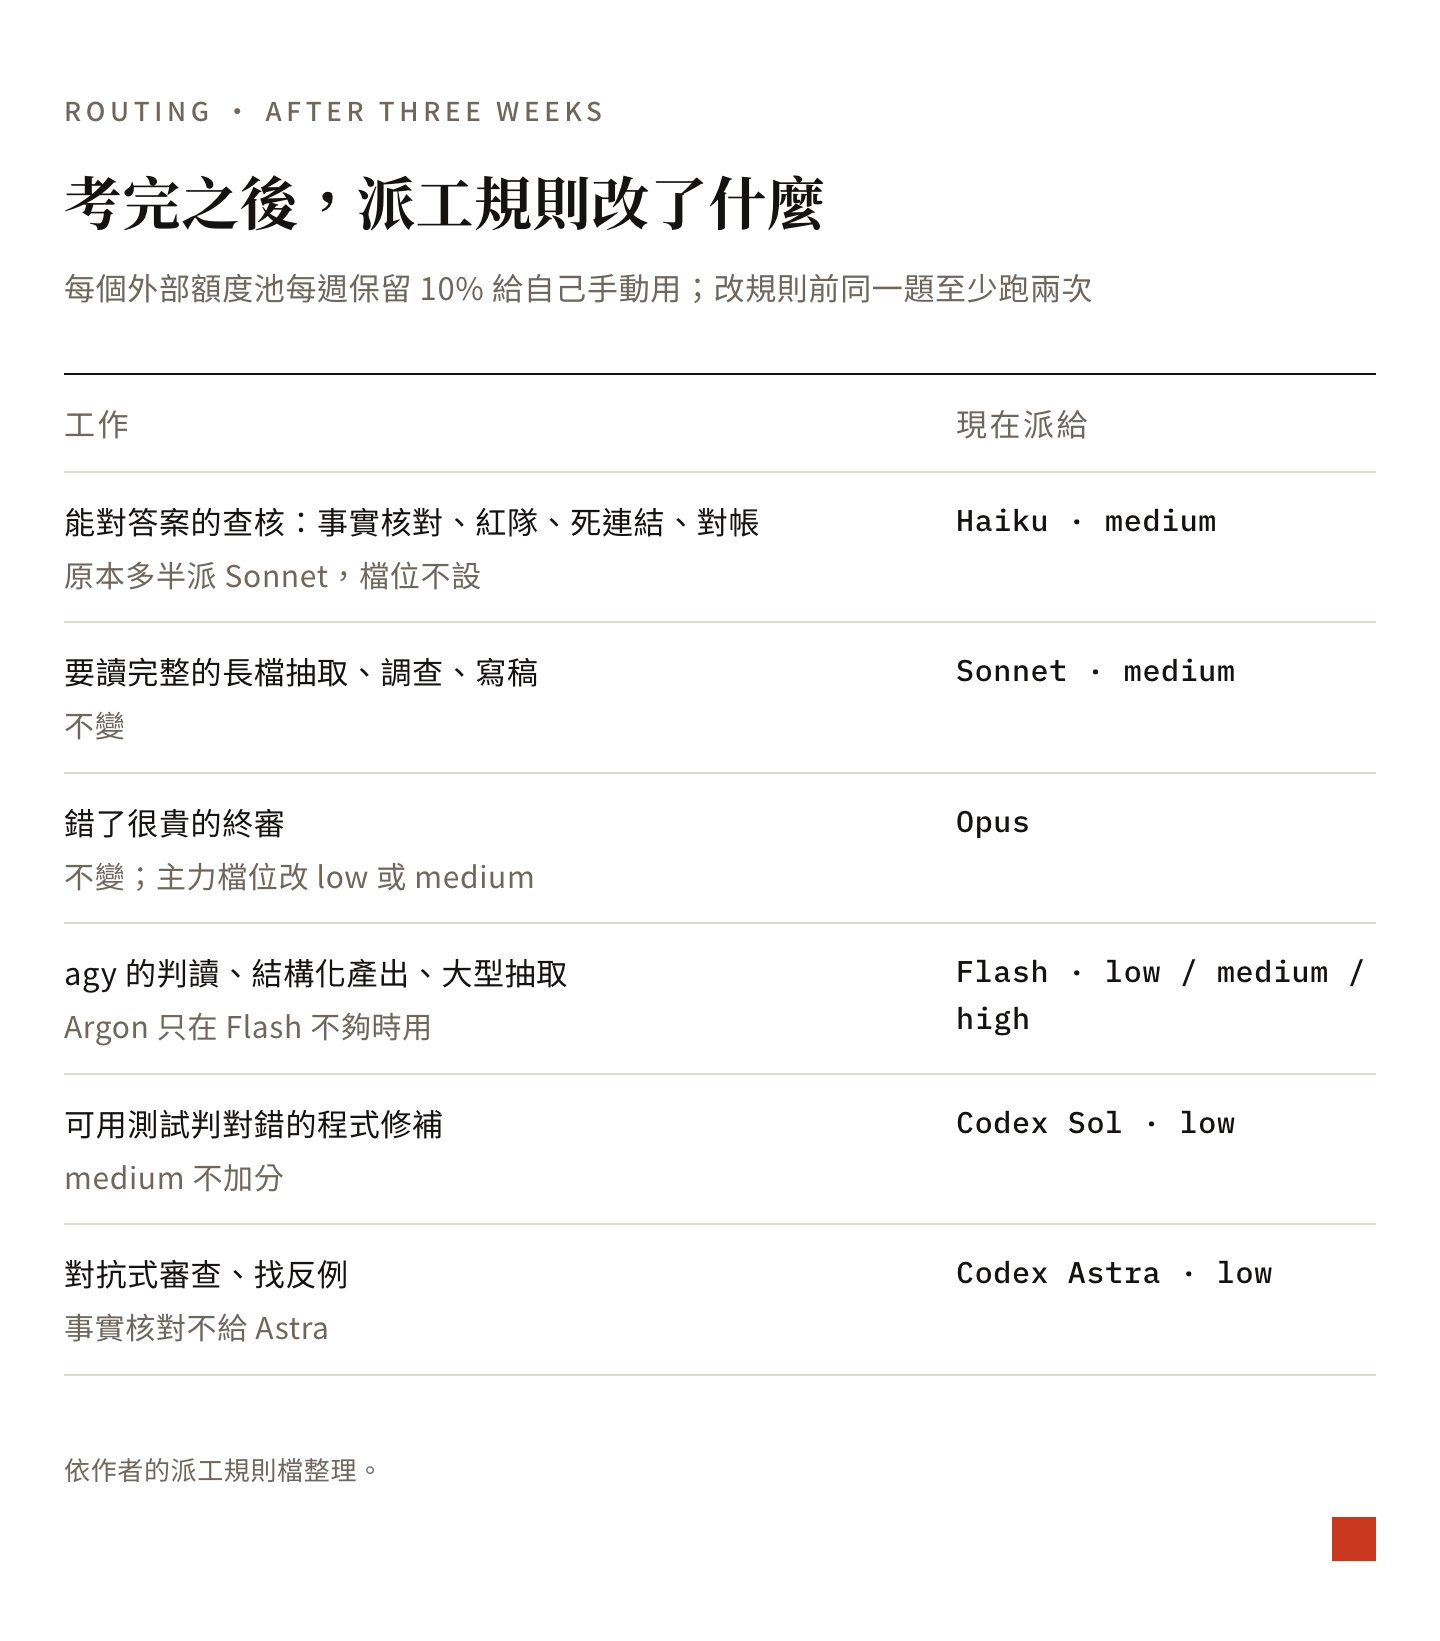
這幾輪考完,我的派工規則改成這樣:
- 能對答案的查核,先派 Haiku,檔位 medium,不升 high。
- 要讀得完整才做得好的長檔抽取、調查、寫稿,派 Sonnet medium。
- 錯了很貴的終審留給 Opus。
- agy 用 Flash,短的判讀開 low,要照規格產出結構的開 medium,大型抽取開 high。Argon 只在 Flash 做不好、那幾分值得的時候才用。
- Codex 的修補用 Sol low,對抗式審查用 Astra low,事實核對不給 Astra。
- 每個外部額度池每週保留 10% 給我自己手動用。
還有一條是考了幾輪才加的:要改派工規則,同一題至少跑兩次。只跑一次的結論標成「未測變異」,不拿來改規則。
開發時我下的提示詞
以下是我在這幾輪實際打的字,逐字引用。
新模型出來的第一句話
這個是新出的模型。我要你來用之前我們的實際任務級測benchmark了。注意,是要看他能不能往上挑戰,接管某些我們原本給更貴模型的任務,這樣才能讓我們省成本。然後你也可以設計一些較有挑戰性的實際任務擴充我們的測驗集 (用history find看我們的過去對話來設計任務)我給你充分的自主性完成這項任務,中間不用過問我,最後我想看到新的子代理派工原則。
換成你的情境:重點是講清楚目的(往上接管、省成本)和最後要交什麼(新的派工原則),而且要它從你的對話紀錄出題,不要用它自己想像的題目。
考完要接回規則
我們的派工規則是不是要加上我們之前研究過的Bench Mark測出來的effort
換成你的情境:分數放在報告裡沒有用,要明確要求它寫回你平常派工會讀的那份規則。
問清楚題目跟工作的關係
所以我現在的benchmark題目有啥?跟我日常工作的關聯是什麼?測試的方式是什麼?
換成你的情境:考卷是 AI 出的,你要能用自己的話說出每一題在考你的哪一類工作,不然分數再好看也不知道該信多少。
檢查平常的檔位用得對不對
你用我的History Find這個Skill去看我電腦裡的CloudCode的對話,去看我分別每一種模型都用過什麼樣的這個Effort檔位,然後來評估這些檔位造成錯誤的情況,或者是造成浪費的情況有多少,不要只是主代理,子代理也要去評估。
(刪節自較長的訊息。)換成你的情境:除了考新模型,也可以反過來,讓它從紀錄裡找出你平常開太高或太低的檔位,再拿考卷驗證。
外部模型也用同一份考卷
你讓astra sol多試著跑一些任務看看他們各自適合什麼 什麼檔位最划算 再決定怎麼寫規則
你也去讓agy裡的3.8 flash跟argon試著跑一些任務看看他們各自適合什麼 什麼檔位最划算 再決定怎麼寫規則 然後要留10%周額度給我做緩衝使用
換成你的情境:先考再寫規則,順序不要反過來。也記得替自己留一點額度。
開源模型問的是角色
如果是 qwen 3.8 27b 或者是3.8 flash next的量化版放上去colab跑,接本地claude code節點作為subagent,速度是否可行?表現比較適合做何種角色?幫我往這個方向評測跟研究。
換成你的情境:面對便宜的模型,不用急著問「能不能取代」。問它「適合當什麼角色」,得到的答案會實際很多。
額度緊的時候,只考有機會的
如果要開實測,就是要想我們現在真實在處理的任務到底有哪些Haiku是有機會勝任的?因為我們的額度不多了,我不想要浪費太多在實測上。
換成你的情境:考試本身也花額度。先挑出那個模型最可能接得住的工作,其他的不用考。
起手提示詞範本
1. 讀我過去(時間範圍)的對話紀錄,列出我最常交代給 AI 的工作類型,標出哪些現在是交給(目前較貴的模型)。
2. 每一類挑(數量)題做成考卷:題目用我的真實工作改寫,開跑前先算好標準答案,每題埋一個我實際踩過的陷阱,並寫下掉進陷阱會得到的錯誤答案。
3. 在空的暫存資料夾、用唯讀權限跑,受測模型不能讀到答案檔。
4. (新模型名稱)和(現有模型名稱)在(low/medium/high)各跑至少兩次,記下分數、耗時和花費或額度用量。
5. 看最低分,不看平均分;每一筆沒拿滿分的都打開來讀,確認是模型錯還是評分程式錯。
6. 依結果改寫我的派工規則,只跑過一次的結論標「未測變異」,不要據以改規則。
附錄:技術做法
這一節給想自己做一份的人。方法我整理成一個公開的套件 model-bench-kit,裡面附三題合成資料的範例。
整體架構
考卷由三樣東西組成:題目(一份提示詞加上要讀的資料)、標準答案、評分程式。每一輪考試是一份工作清單,一行一筆,寫「題號、模型、檔位、第幾次」。執行器照清單一筆一筆跑,每筆的完整輸出存成一個 JSON 檔,評分程式再讀這些 JSON 打分。
換新模型的時候,題目、答案、評分程式都不動,只在工作清單加幾行。這是整套能重複用的關鍵。
一筆考試的流程
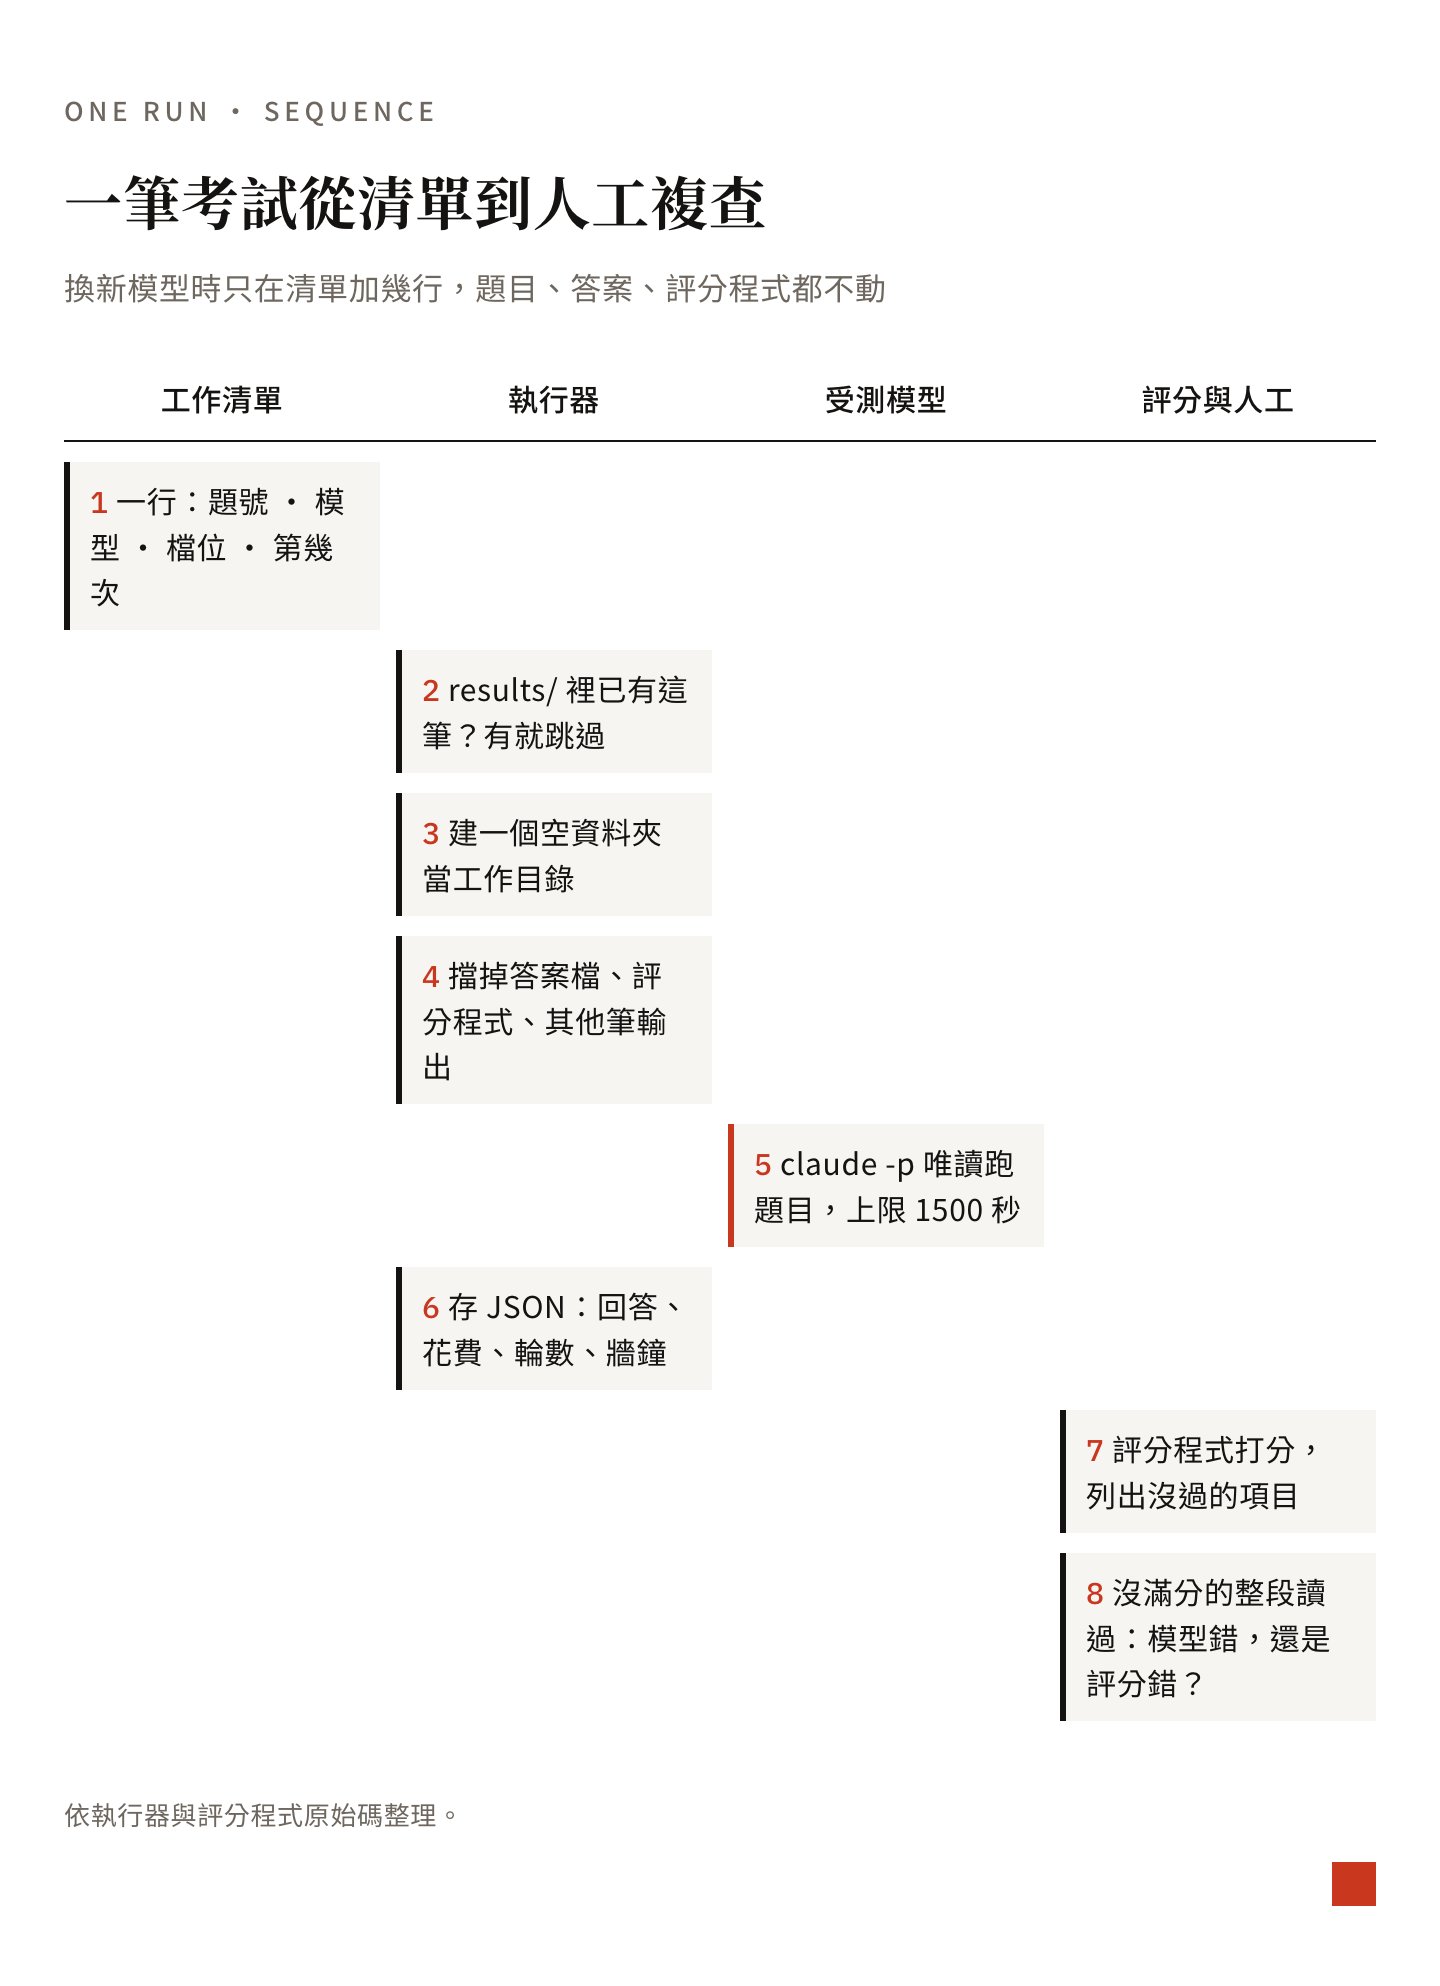
Claude 的部分用 headless 模式。執行器的核心是這一行:
cmd = ["claude", "-p", "--model", model, "--effort", effort,
       "--output-format", "json", "--permission-mode", "dontAsk",
       "--max-budget-usd", "4",
       "--allowedTools", "Read", "Glob", "Grep",
       f"--disallowedTools={','.join(deny)}", "--", prompt]
deny 裡放的是答案檔、評分程式和其他筆的輸出,模型就算想找也讀不到。工作目錄設成一個空的暫存資料夾,避免專案裡的設定影響受測模型。--output-format json 會回傳花費、輪數和完整回答,執行器另外記下牆鐘時間。每筆設 1500 秒逾時。
agy 和 Codex 沒有同樣的權限參數,所以改在暫存副本上跑。Colab 上的開源模型,是把 ANTHROPIC_BASE_URL 指到透過 SSH 通道轉出來的伺服器,讓本機的 claude -p 直接呼叫它,題目和評分程式完全共用。
評分怎麼寫
評分程式盡量只用規則判斷,不用另一個模型當裁判。以「多重要求」那題為例,五個要求各寫一條檢查:
r2 = "391" in t                                   # 乘法算對
r3 = "坎培拉" in t or "Canberra" in t              # 首都答對
r4 = not BULLET.search(t) and "|" not in t        # 否定句:不准用條列或表格
r5 = last_line == "Cheers"                        # 最後一行指定文字
score = sum([r1, r2, r3, r4, r5]) / 5
每題回傳分數和沒過的項目,例如 fail=no_list,cheers,方便一眼看出錯在哪。
評分程式自己也會錯。第一輪我的評分器出包三次,三次都是模型答對、評分器判錯。所以每一筆沒拿滿分的,都要打開整段回答讀過。
結果放在哪裡
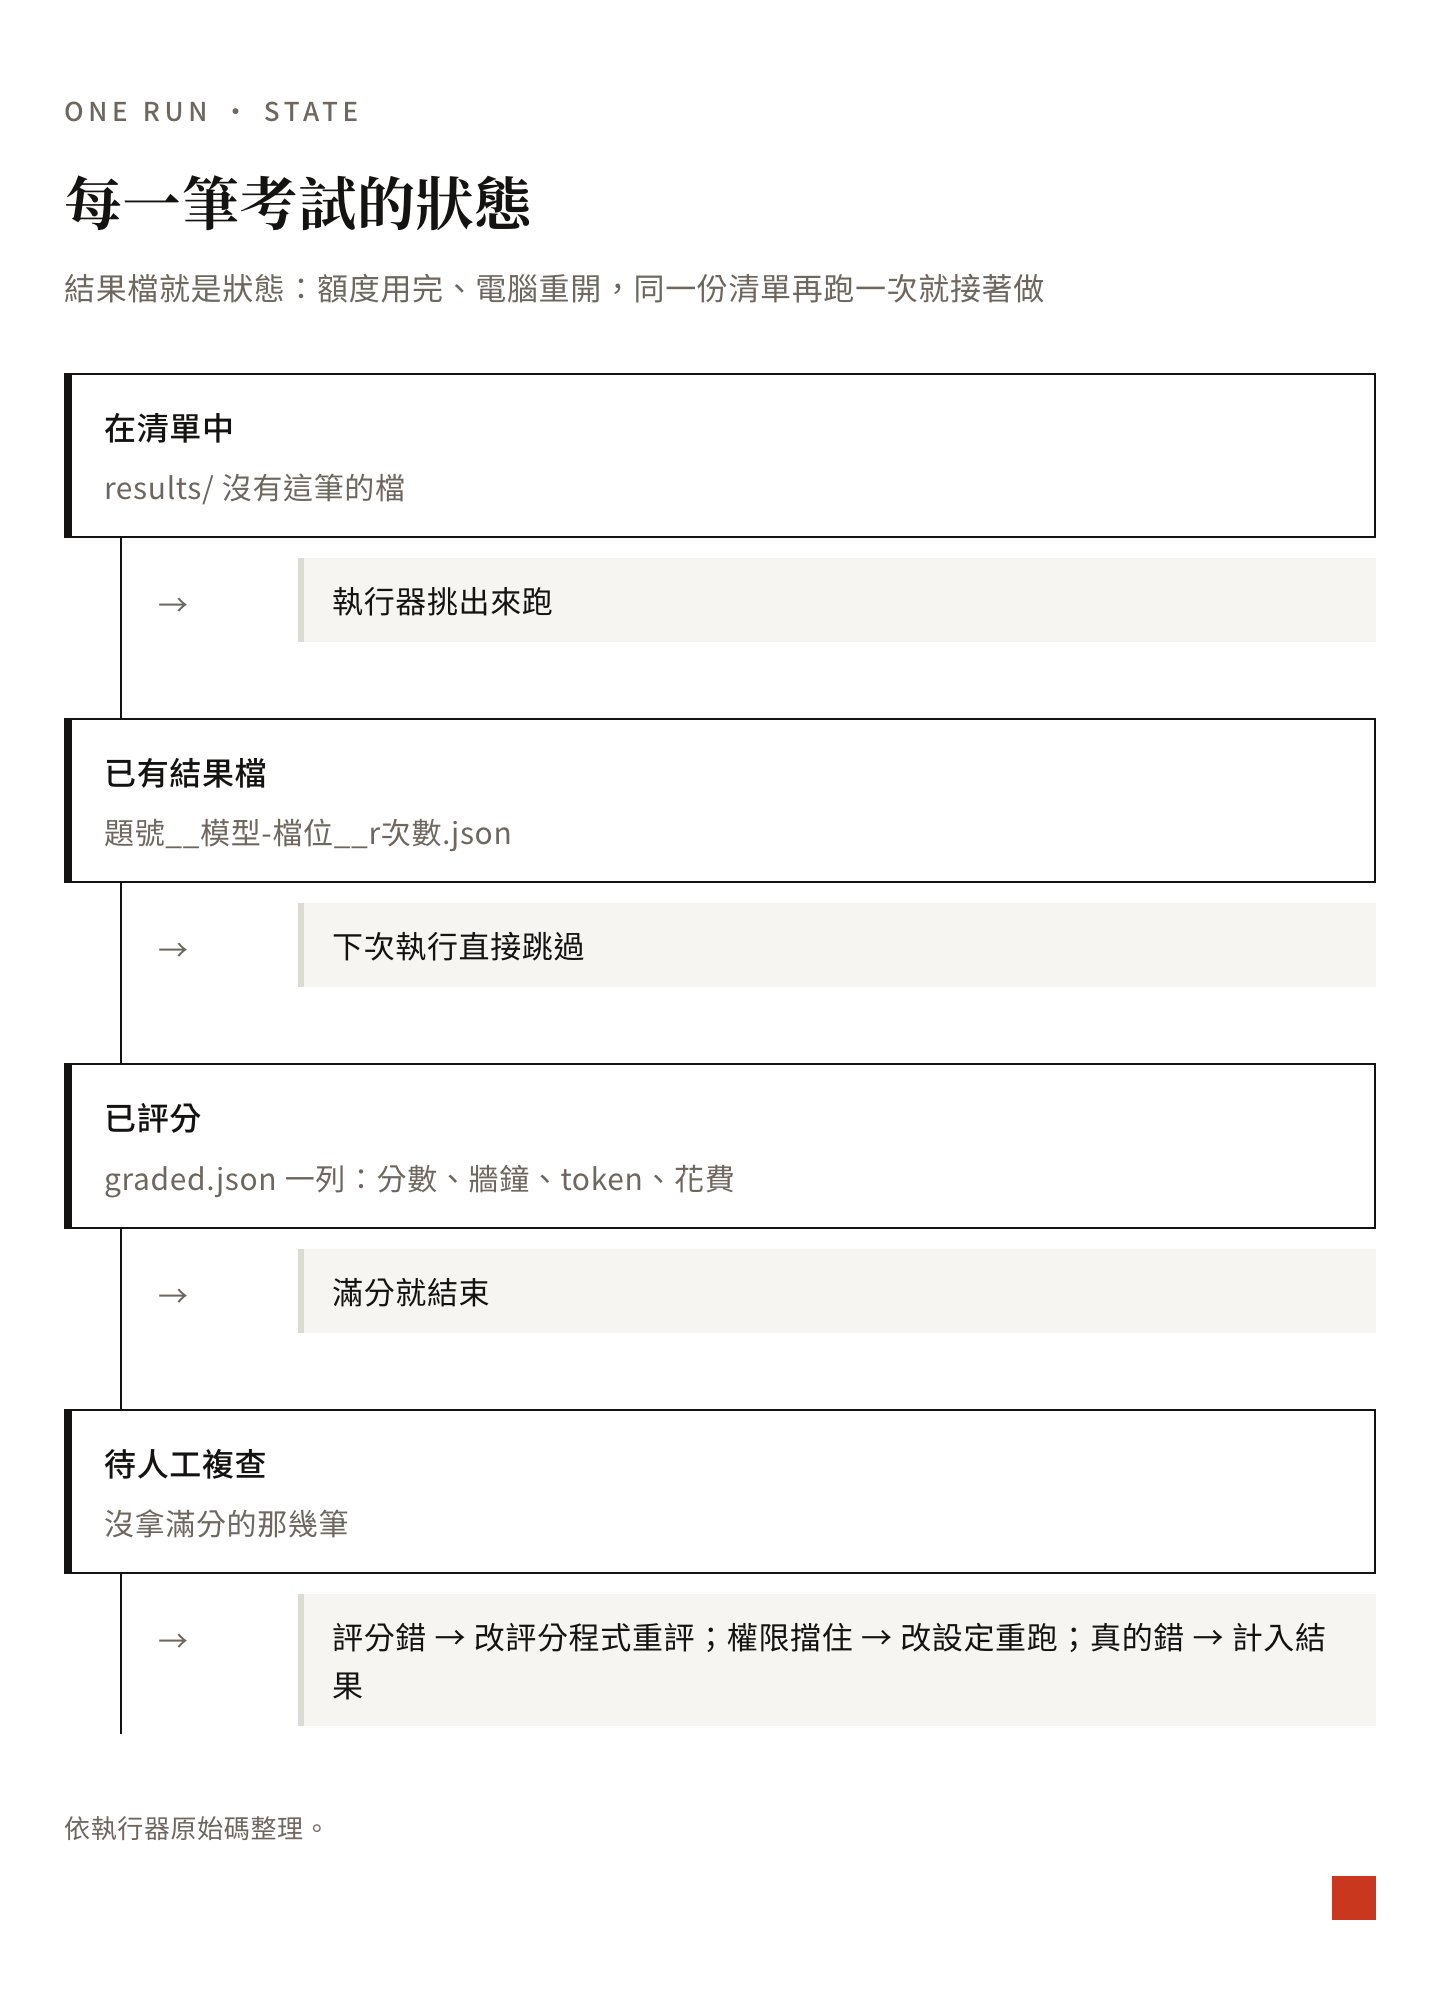
每筆結果存成 results/<題號>__<模型>-<檔位>__r<次數>.json。執行器開跑前先看這個檔在不在,在就跳過。所以額度用完、電腦重開都沒關係,下次同一份清單再跑一次就會接著做。這點對 Codex 特別重要,它的五小時窗口常常在一輪中間就滿了。
評分結果另外寫成一份 graded.json,每筆一列:題號、檔位、第幾次、分數、牆鐘時間、輸出 token、花費、輪數、沒過的項目。比較不同輪的時候,直接讀這幾份檔案就好。
什麼時候改規則
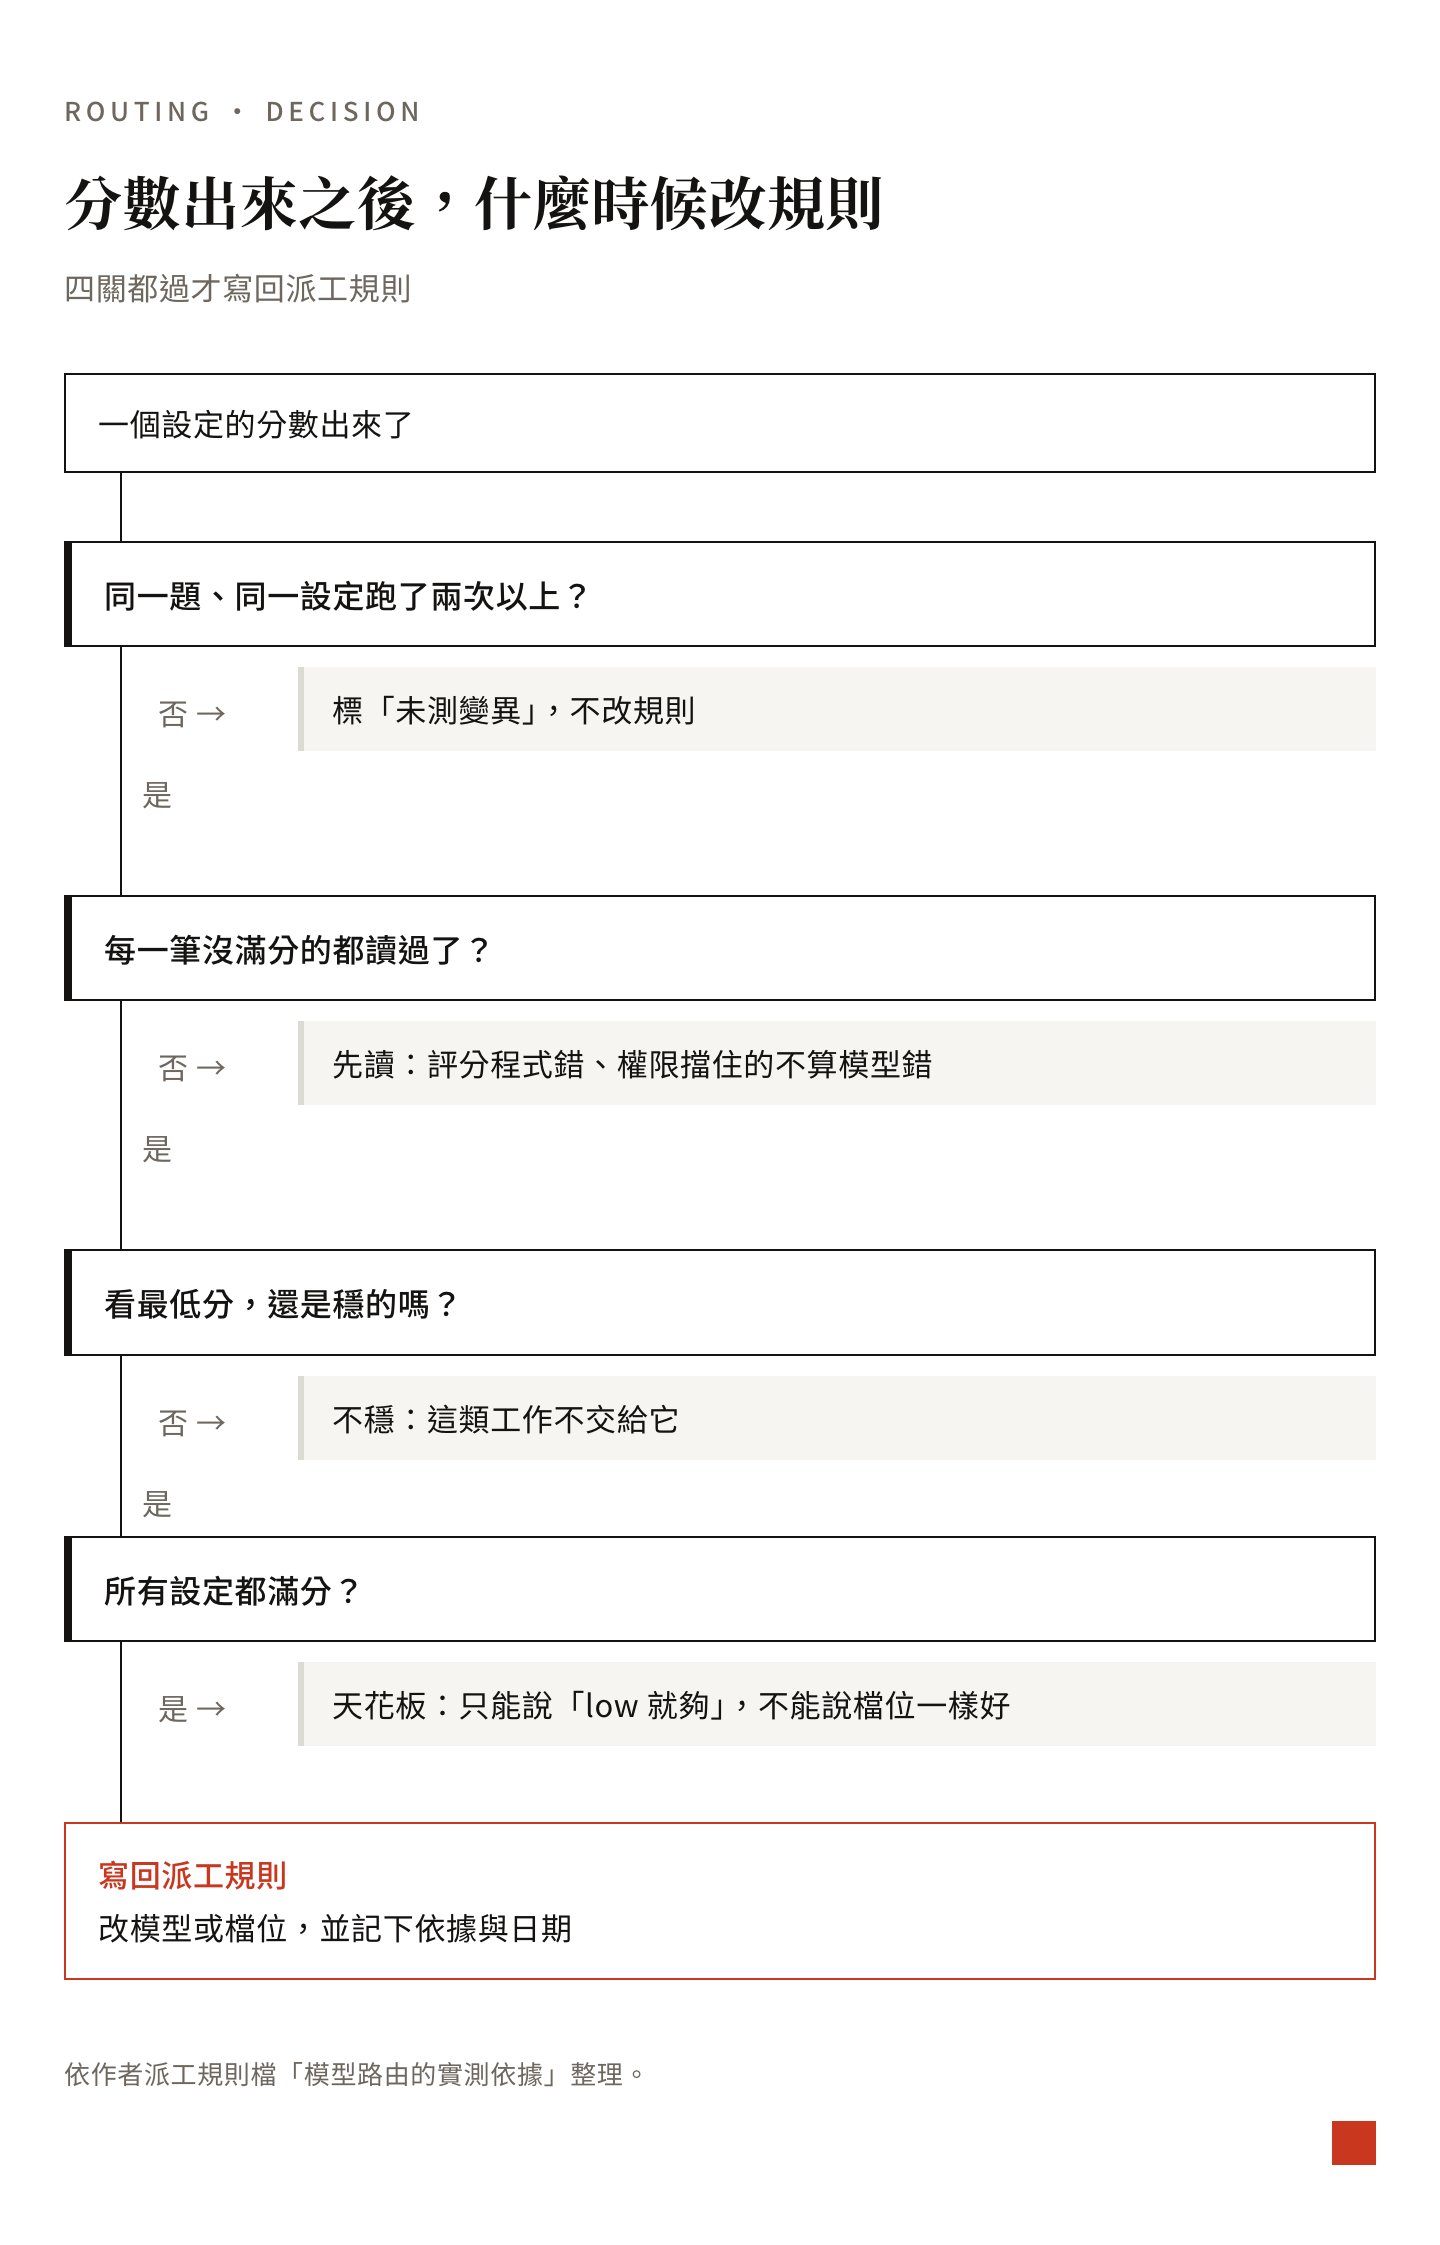
分數出來之後,要過四關才寫回派工規則:
- 同一題、同一個設定至少跑兩次。
- 看最低分。平均分漂亮但有一次掉到一半,那就是不穩。
- 每一筆沒滿分的都讀過,排除評分程式的錯和權限設定擋住的情況。我第一輪就有一筆是 Haiku 被權限擋下、交了白卷,那是設定問題,跟能力無關。
- 所有設定都滿分的時候,代表題目太簡單,只能說「這類工作 low 就夠」,不能說「low 跟 medium 一樣好」。
想自己做的最小版本
不用一開始就做十題。挑你最常交代的三類工作,每類一題,答案先算好,再寫一支只有幾行的評分程式。下次新模型出來,在工作清單加一行模型名稱就能重考。考了兩三輪之後,再照你實際看到的失誤加題,像我後來補的「多重要求」和「多條規則同時守」。