之前寫《最需要 CLI 的電腦,主人最不可能學會 CLI》的時候,裡面寫了一句期待:希望 27B 開放權重後可以有人出量化版,也希望之後能夠有 MOE 版本的小模型。這篇就是那個期待的後續。
上週我在碎念裡就先講了該關注什麼:
其實我們普通人應該要關注的是下週開放權重的 Qwen 3.8 27b。那個做量化才是真的能塞進我們電腦,速度智力也足夠的本地模型。坐等 unsloth。
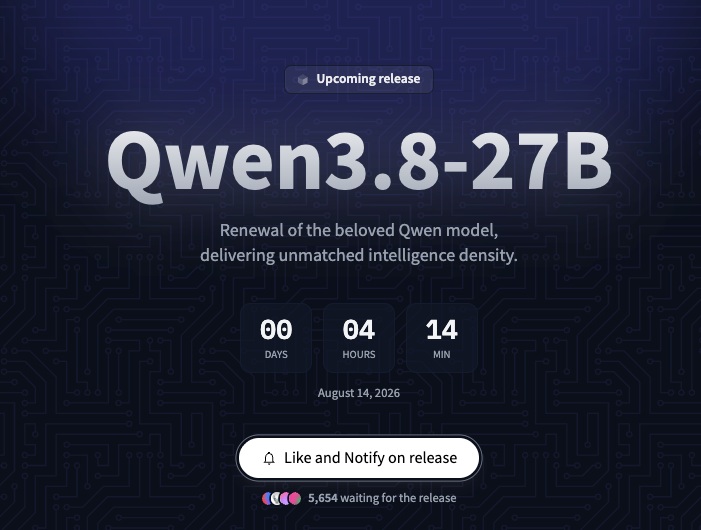
8 月 14 日晚上,今晚最讓人興奮的事情:Qwen 3.8 27B 要開放權重了。
前情提要是這樣的:兩代前的 3.6 27B 跟 35B A3B 是我覺得消費級硬體上,本地端最堪用的小型 LLM,到現在還是。而 Hugging Face 的模型卡已經放出來,有開原生視覺能力(圖片/一小時影片),可以切換思考模式跟 effort,上下文長度 262K,但是可以擴展到 1M!!!
隔天早上跑過一輪,個人體感是這樣:贏了 Sonnet 5,也贏了 Opus 4.7、4.8(這兩個本來就是倒退版),跟 Opus 4.6 差不多(但官方說並沒有全面超越)。果然本地小參數模型這一側,只有 Qwen 能超越自己,其他模型都是跑分沒輸過實戰沒贏過。
唯一的缺點是速度慢,但我知道,這是我的問題不是他的問題。有人來問實測感想,我也是同一句:目前實測下來,除了跑得慢之外沒啥缺點,能力大幅增強,但跑得慢是我的問題不是他的問題……我是 M4 Pro。
所以希望他們也能推出 A3B,MOE 版本感覺速度上會更實用。
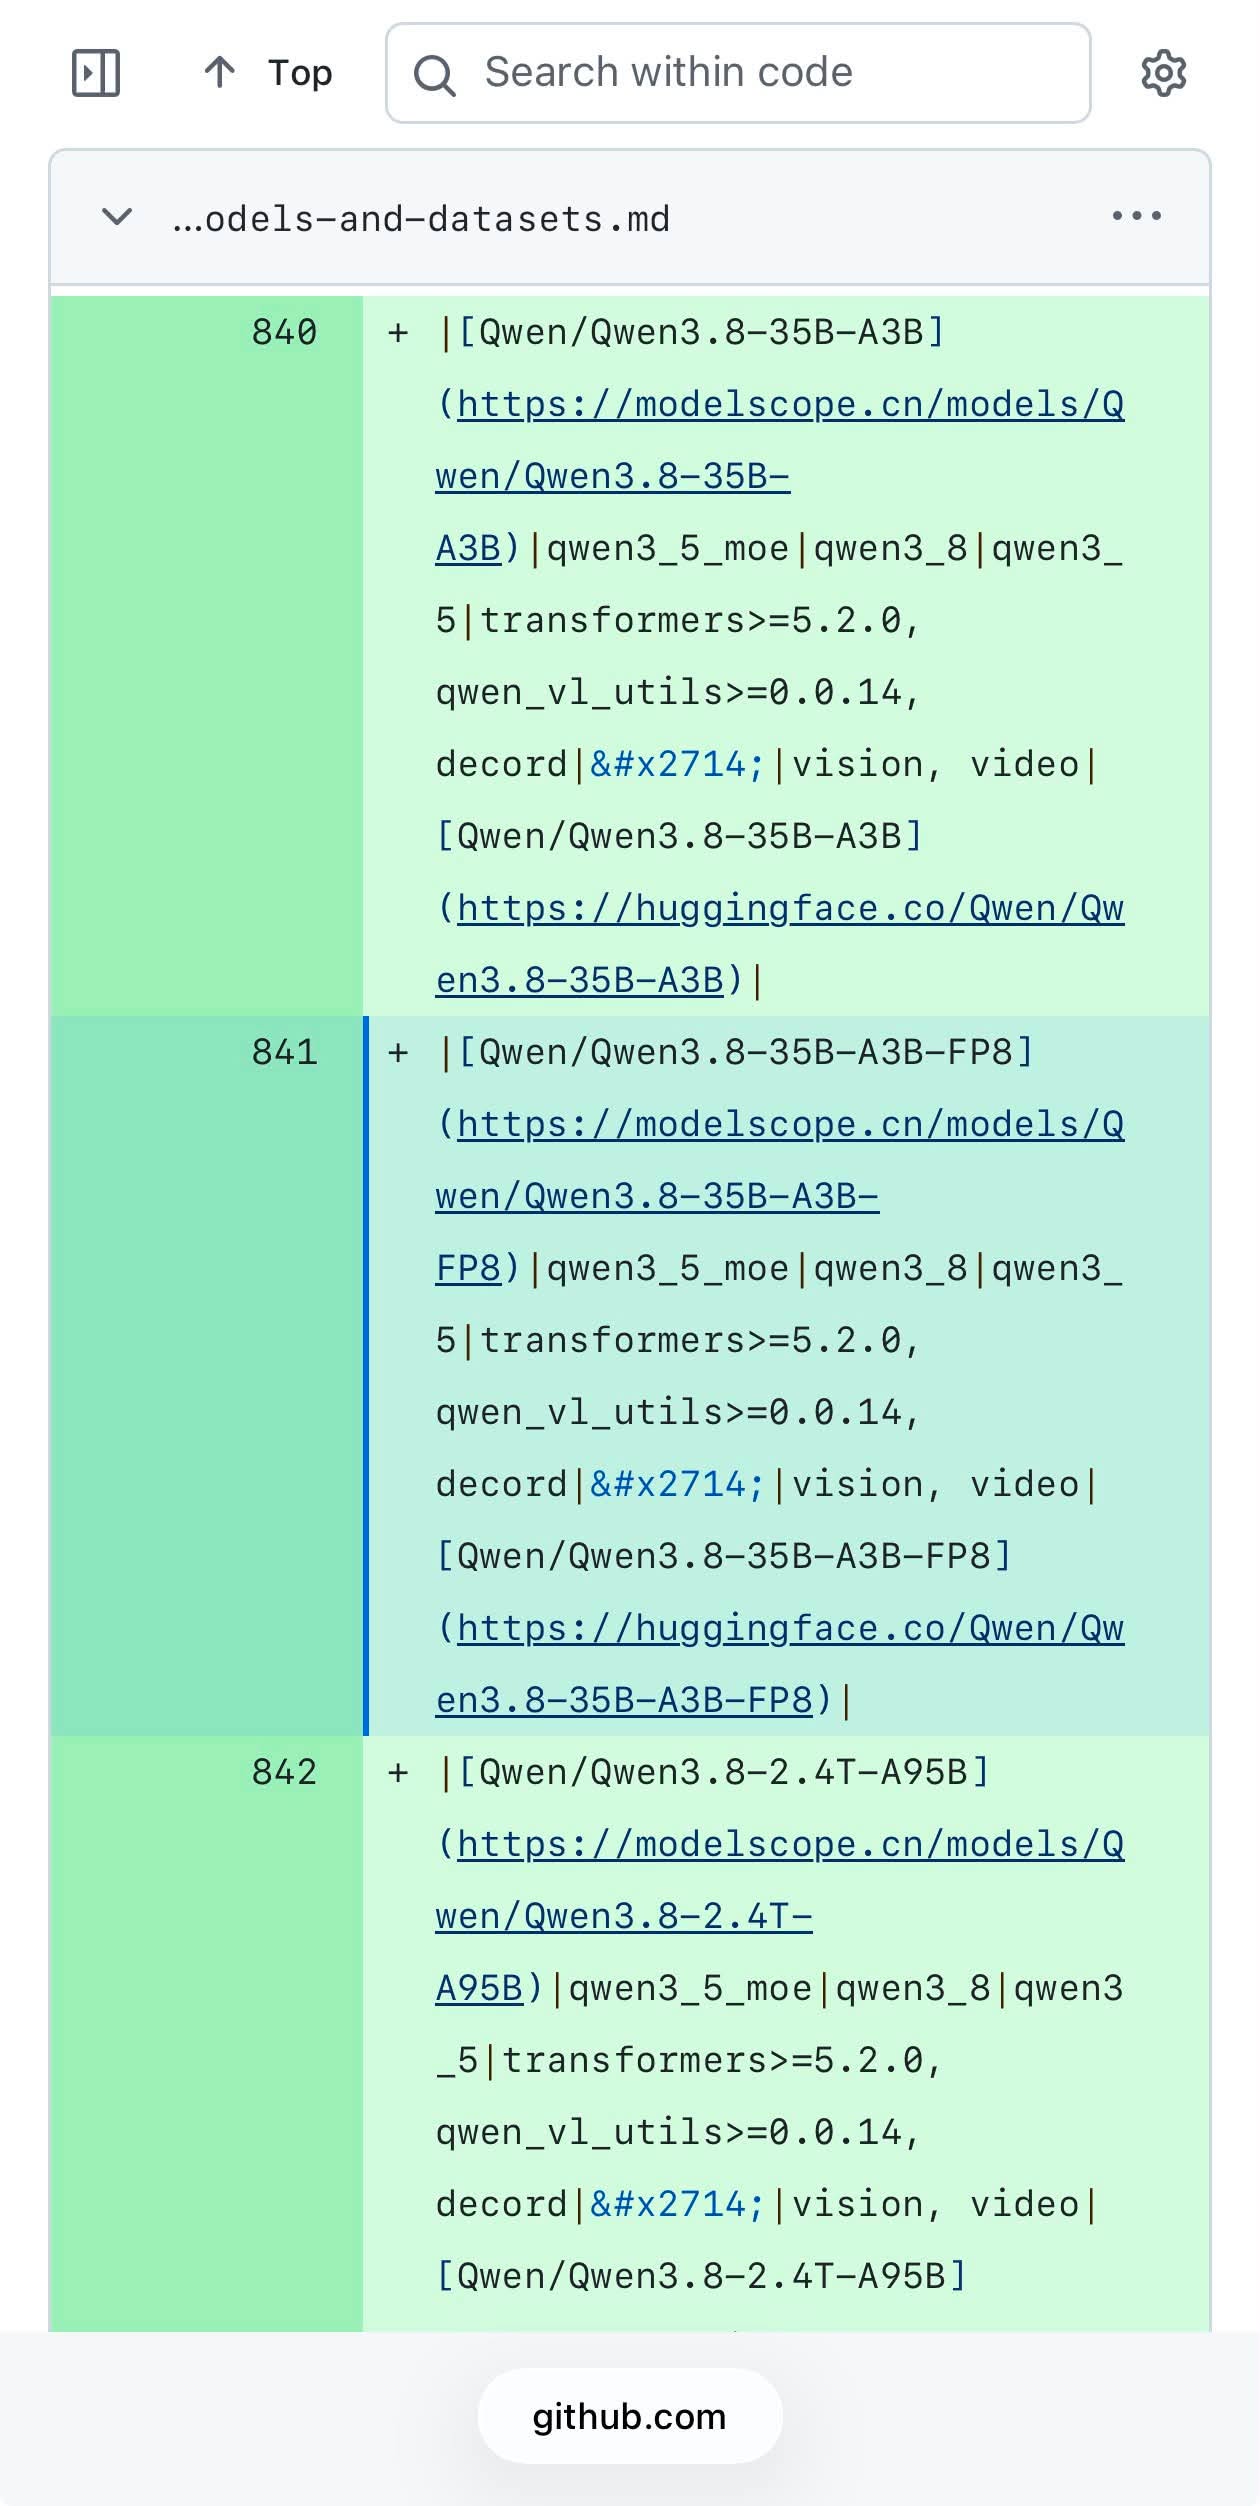
然後同一天中午就有進展了:Qwen 3.8 35B A3B 真的有譜了,Modelscope 上面已經註冊了。期待期待期待。
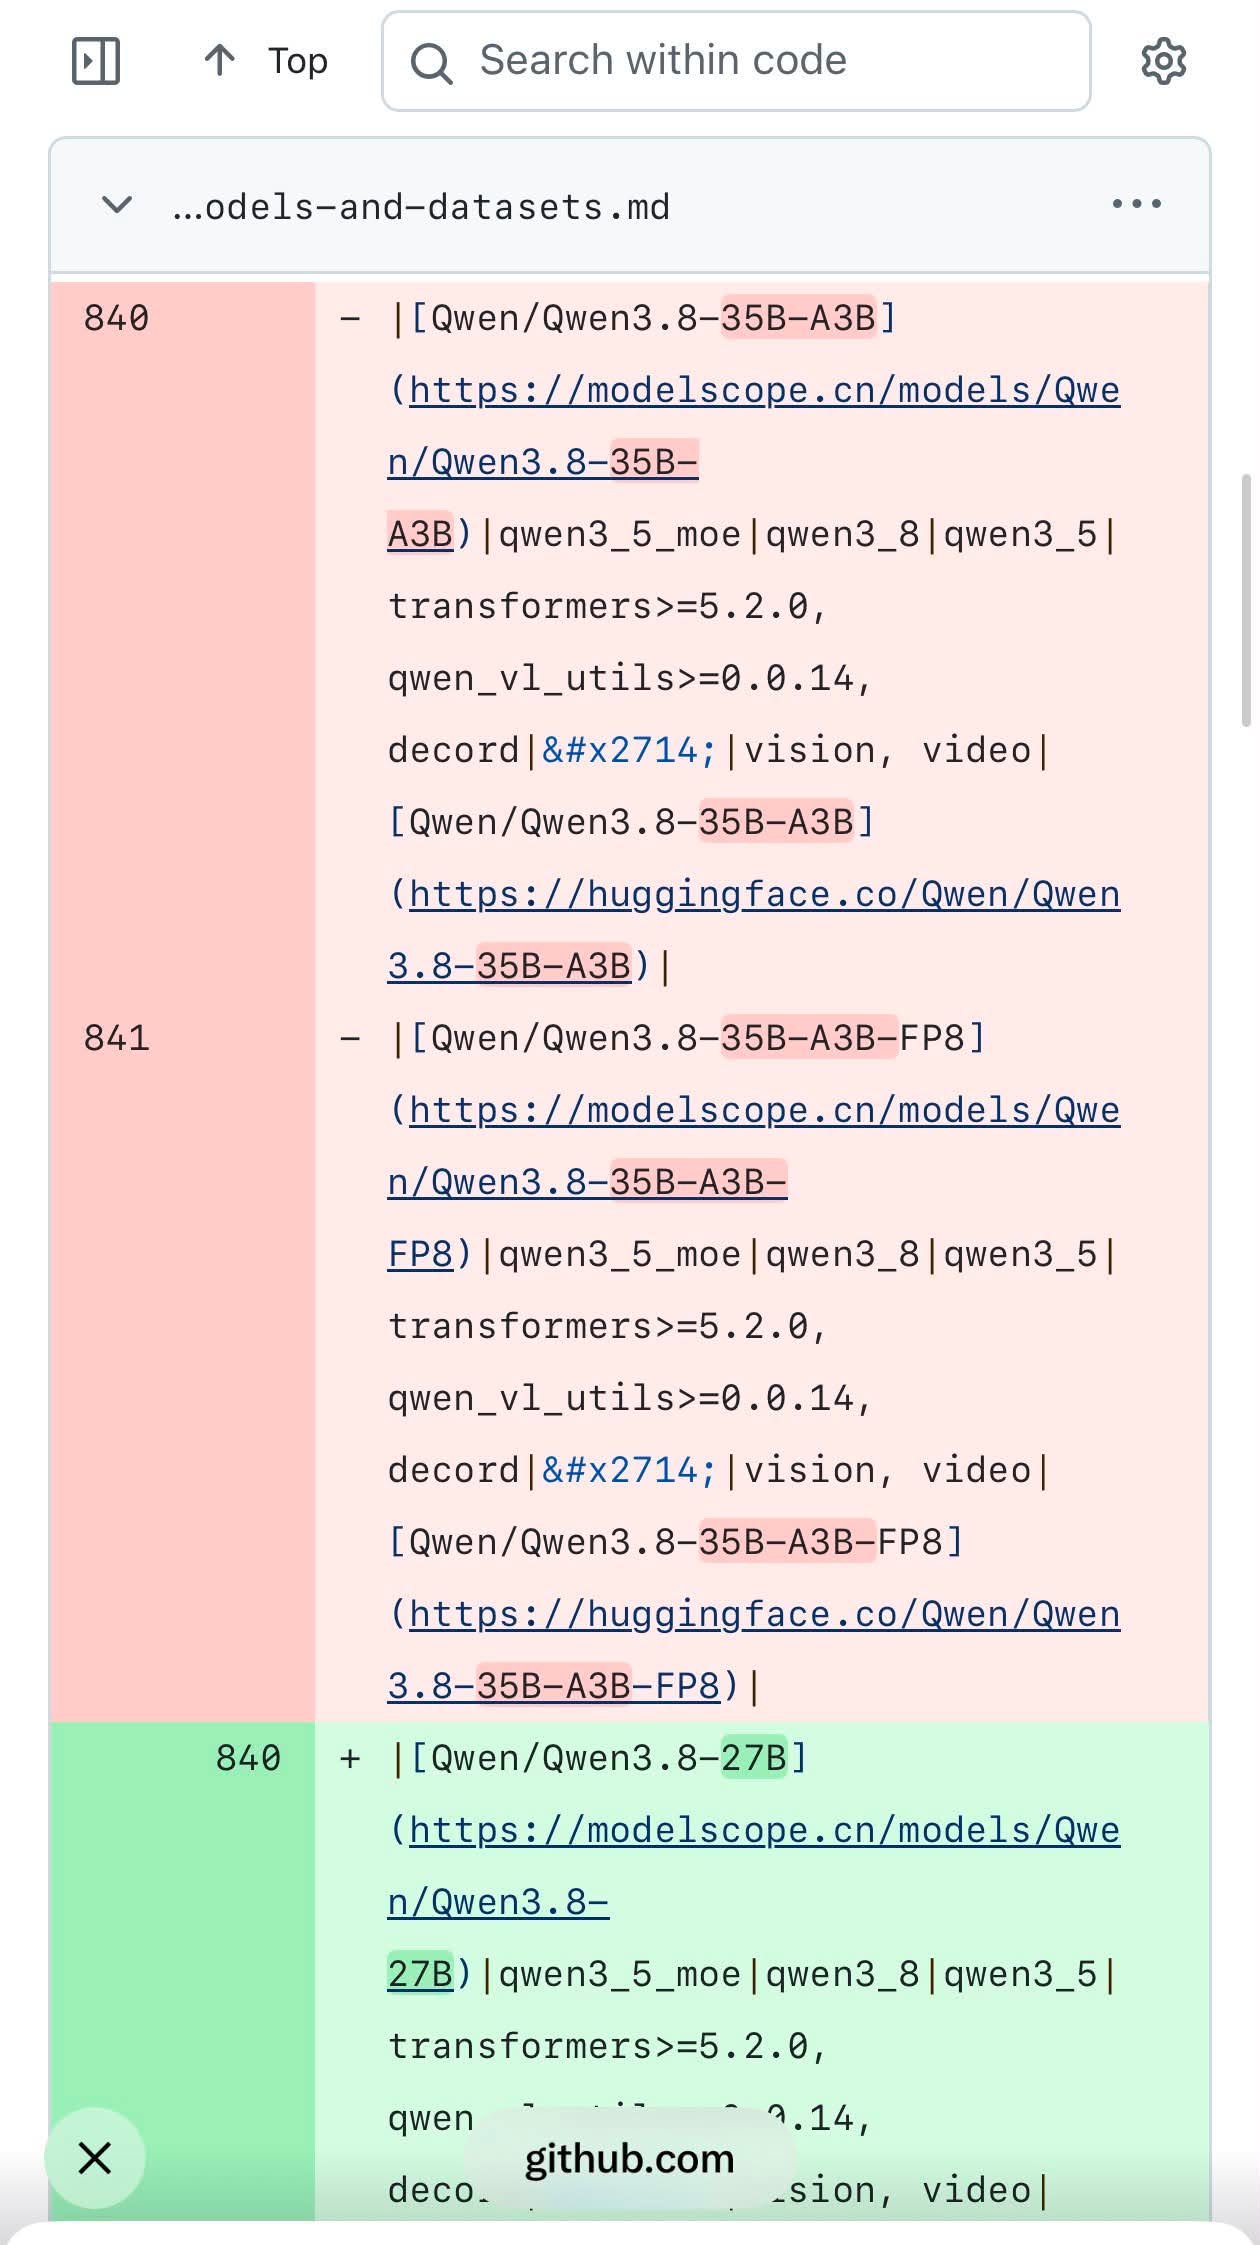
下午國外網友也做了比較,貼在 r/LocalLLaMA:architecture 一樣,weights 不一樣。
隔天早上,8 月 16 日:Qwen 3.8 35B A3B 被刪了,大家可以散會啦~
需要 a3b 這種 moe。
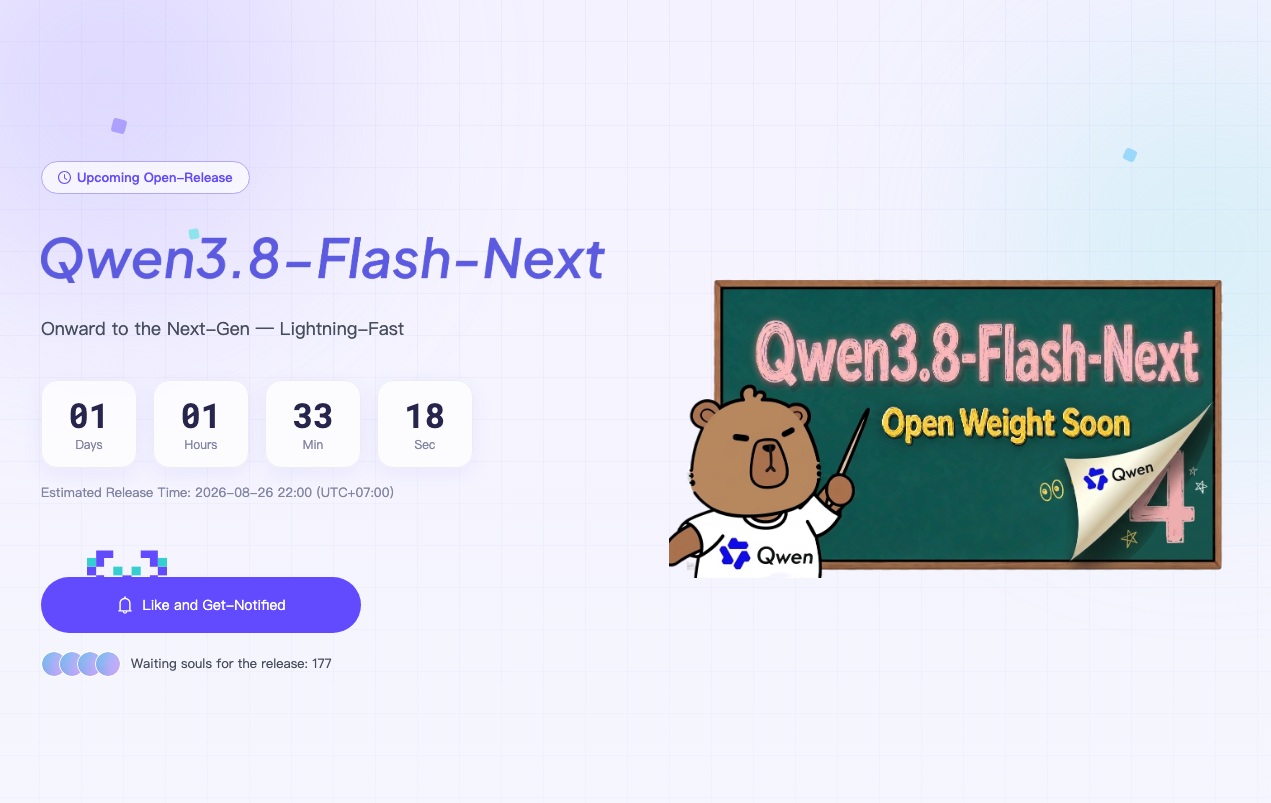
補記:Qwen 3.8 Flash Next
八月二十五日晚上,續集來了。
太好了,終於要有 MoE 的 Qwen 3.8 開放權重了!而且是用下一代 Qwen4 的全新架構。這一顆據說是 125B A6B。
看看能不能正式成為取代 3.6 35B A3B 的模型呢?