目錄
聰明模型寫管線,笨模型照做
我有一個很直觀的例子,來跟我的 AI 學員說明模型之間的智力差距跟效率。
像是下圖的任務,就是一個非常單純的「從 google drive 上面拉散落在各處的諮詢影片,轉錄成文字歸檔」。
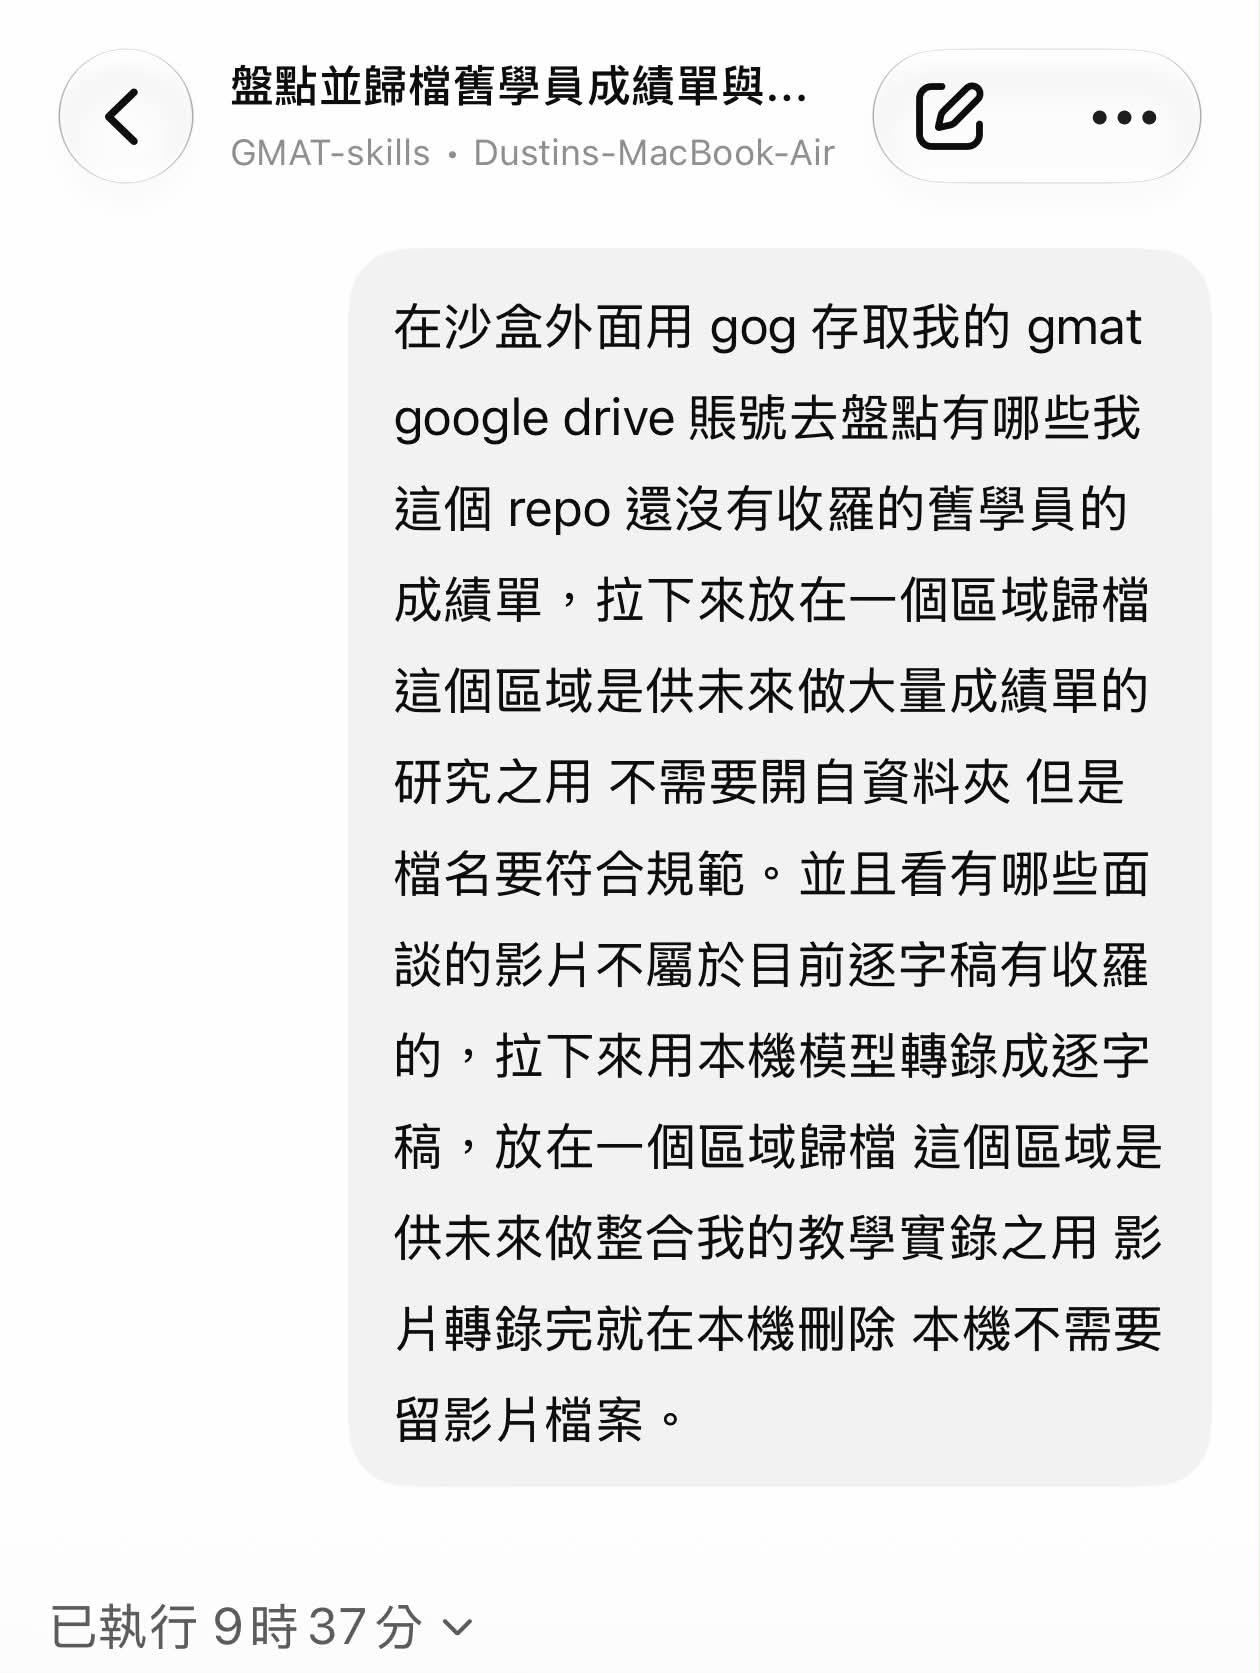
如果是聰明的模型如 Opus,他會是直接先去盤點到底哪些是面談影片、散落在哪些路徑,然後後面的用 gog CLI 下載、送本機模型轉錄、失敗偵測斷點續行等等都全部搭成一套管線腳本,他只在最後讀取語義做完整性驗證跟檔名格式統一,耗的 token 非常少做的又快。
但是如果是笨模型,他就會是一直自己參與每一個步驟,中間還會加各種花式自我檢查比如 SHA-256,又慢又耗 token。
所以最好的搭配是讓聰明的模型規劃「該怎麼做」,該寫的腳本寫好、哪裡需要 LLM 參與、出錯了怎麼排解都寫清楚,然後交個笨模型,告訴他「就照這樣做,你只需要在裡面寫的情景參與跟除錯」就好。
但有些模型真的笨到你就算寫清楚了交給他,他還是會漏掉跟加戲。
對!GPT LUNA 6,我就是在說你!!!
請 Opus 5.5 讀 Codex 的對話並接手
我這幾天越來越常用 /history-find 這個指令,因為 Codex 不管是 6 Luna 還是 6 Sol 都真的倒退到有剩,不僅智力下降,且過度防禦的性格惡化到淋漓盡致(自己轉自己的雲端影片要比個屁雜湊?),導致做得又慢又卡。Astra 才算正常人,但是正常人吃額度似乎有點快。
於是我不得不請 Opus 5.5 去讀我的 codex 對話,判斷我的原始意圖並且直接接手。
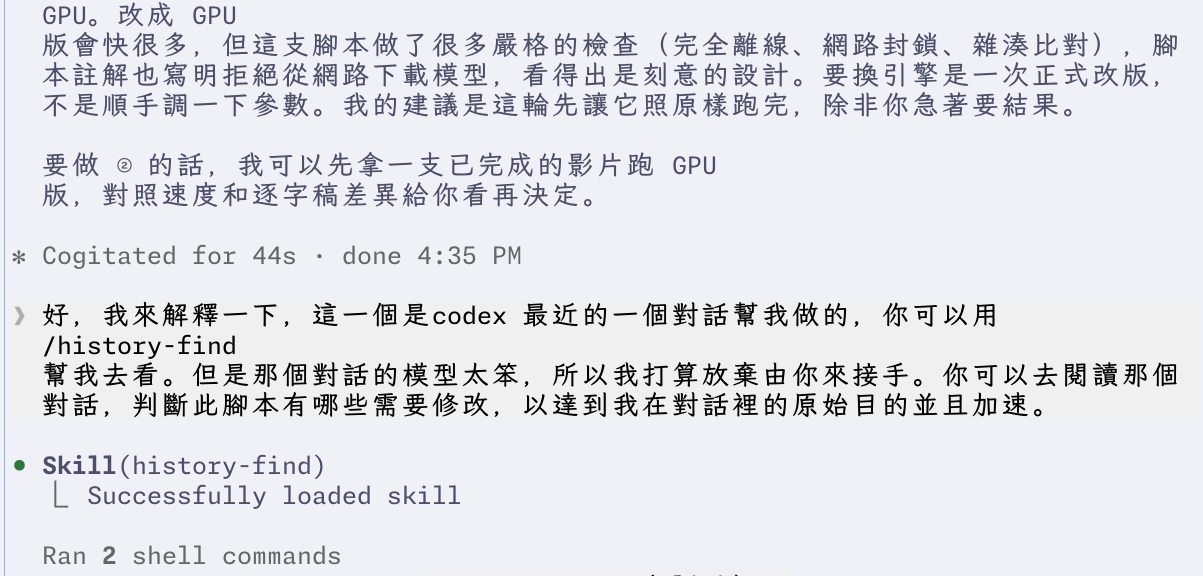
但是要怎樣讀對話紀錄才能又有效率又不吃 token 呢?我把我在圖中用的 SKILL 放在這裡:
https://github.com/danyuchn/history-find
Opus 解剖出的四個失敗模式
接續剛剛分享的,讓 Opus 5.5 接手 6 Sol / Luna 的爛攤子。我是真的想知道到底為什麼那麼蠢,就請 Opus 去分析到底是蠢在什麼地方,得出來的分析結果蠻有價值的,跟大家分享:
1. 力氣一直花在盯進度,從來沒有反思。 他每分鐘盯一次進度,可是從來沒有想過為什麼同一件任務速度落差會從 4 分鐘到 14 分鐘,看到異常 timeout 只會等,明明一行 ps 指令就查得到原因,他就是不去查,用自己的想像直接繞路。
2. 選工具時沒有檢查自己手上有什麼。 明明在我自己機器上就有較好的語音轉錄模型,他也沒有先查我原本機器有什麼,硬要去拉一顆來裝,拉完也沒有比較實測,等於超級土法煉鋼。
3. 忘了我整個任務的原始意圖。 我的任務的意圖講得很清楚,轉錄教學影片是為了「供未來整合我的教學思路之用」,6 Sol / Luna 不會去想後面的含義,教學思路分析最需要就是分開學生跟老師誰跟誰在說話,GPT 只讀字面知道要轉錄,但不會進一步解讀意圖脈絡。
4. 安全做過頭,效率做不夠。 兩千多行腳本大半是網路封鎖沙盒、層層 SHA-256 比對、防符號連結攻擊,我就只是處理自己帳號的自己的影片,這種防賊有必要嗎?
在 Codex 裡說話是另一個人
ChatGPT 的聊天模式跟 Codex(Agent 模式),說話根本一個天一個地……
GPT 在 Codex 裡面說話防禦到銅牆鐵壁了:
我會A,不會B,我也會C,接下來D,不會把E當作F,也不會把G當成唯一的H。
6.1 Sol 的感受
GPT 6.1 Sol 的感受:
- 是真的很省額度(僅僅代表現在,過幾天就不一定了)
- 能力大約跟 5.6 Sol 相近或略強一點
- 但真的跑的 好 慢 啊
所以現在我個人傾向相信 Reddit 上的一種說法:
6 Sol 實際上是 Terra,話術是降價實際上是降等。現在這個被迫緊急拿出來救火的 6.1 Sol,才是 6 Sol 真正合格的訓練存檔點。
好了,那 Luna 呢,什麼時候還給我真正的 Luna⋯
Cost per Task 要多一個變數
在 6.1 Sol 出來後,我終於明白一件事。
以前看模型划不划算,我們會算 Cost per Task,用兩個變數,金錢跟任務量。
現在肯定需要多一個變數了:耗費時間。
6.1 表面上看起來很省,但⋯懂的地方就懂,不再細說了。
codex 現在在我心裡面,就剩電腦操作跟生圖的功用而已。