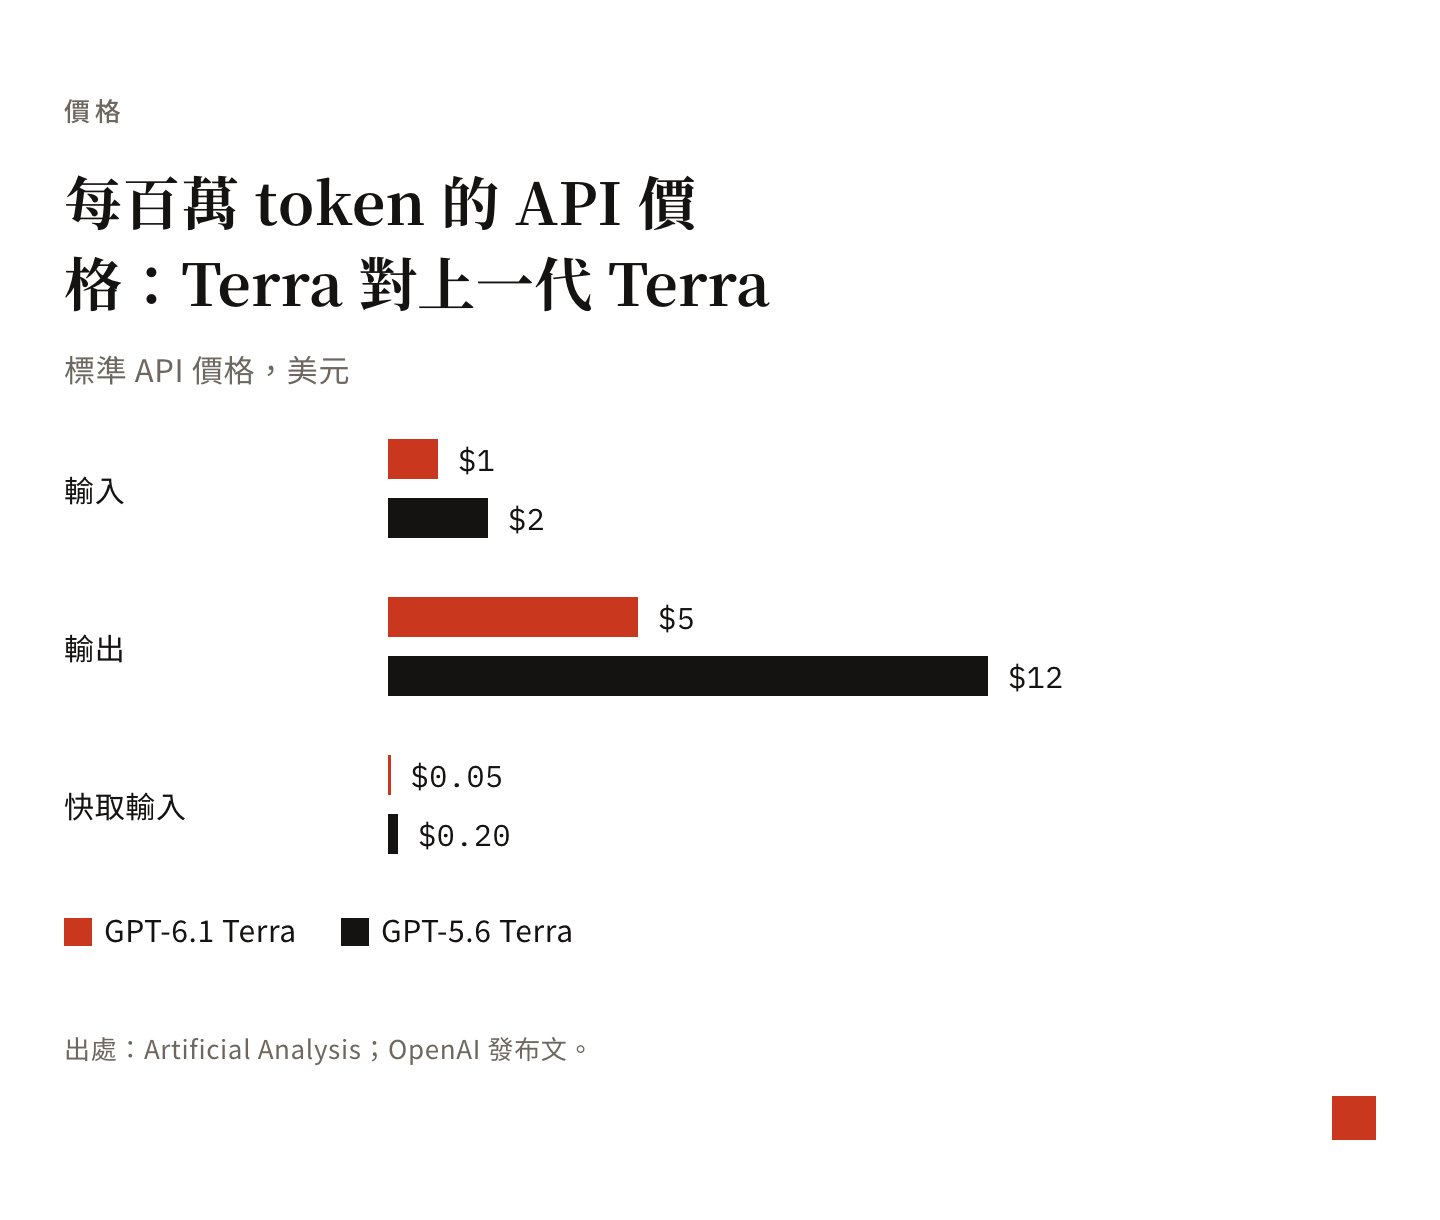
OpenAI 在 2026 年 10 月 26 日發布 GPT-6.1 Terra。標準 API 每百萬 token 輸入 $1、輸出 $5,比上一代 Terra 和同代的 Sol 都便宜一半,主打快速、高效的視覺推理與電腦操作。
我的結論:low effort(低推理強度)的 Terra 可以接手我原本派給 Sol 的程式修補和派給 Astra 的對抗式審查,速度更快,也更省額度。但抓畫面上的簡繁錯字、判斷對話脈絡,還是要交給 Claude Sonnet。
每週一封,只挑跟你工作有關的 AI 動態。免費訂閱電子報 →
官方怎麼介紹
OpenAI 的發布文把 Terra 定位成大幅進步的快速模型,適合讀發票、把明細輸入會計軟體這類大量工作。Plus、Pro、Enterprise、Edu 用戶即日起都能用;在 ChatGPT Work 和 Codex 裡,同樣的額度能做的事比上一代 Terra、Sol、Astra 都多。
以下是官方自己的測試,以及第三方 Artificial Analysis 的評估:
| 比較對象 | 說法 |
|---|---|
| GPT-5.6 Terra | 電腦操作高 15 個百分點,成本約三分之一 |
| GPT-6 Astra | 電腦操作持平,單價只有十分之一,完成任務快三倍以上 |
| GPT-6.1 Sol | 成本較低、速度快三倍以上;官方寫明最複雜的程式工作仍是 Sol 和 Astra 較好 |
| Claude Opus 5.5 | 每個任務成本低約 9 倍;官方沒有拿 Sonnet 和 Haiku 比 |
| 第三方 Artificial Analysis | 比上一代 Terra 更聰明,每任務成本不到三分之一 |
各項基準的名稱與分數看附錄。
我怎麼測、測到什麼
題目全是我自己做的合成資料,每題 Terra 跑 1 到 3 次,Haiku、Sonnet、Opus 多半跑 1 到 2 次。Codex 內建的 computer_use 和 100 行以上的大型修補沒測。
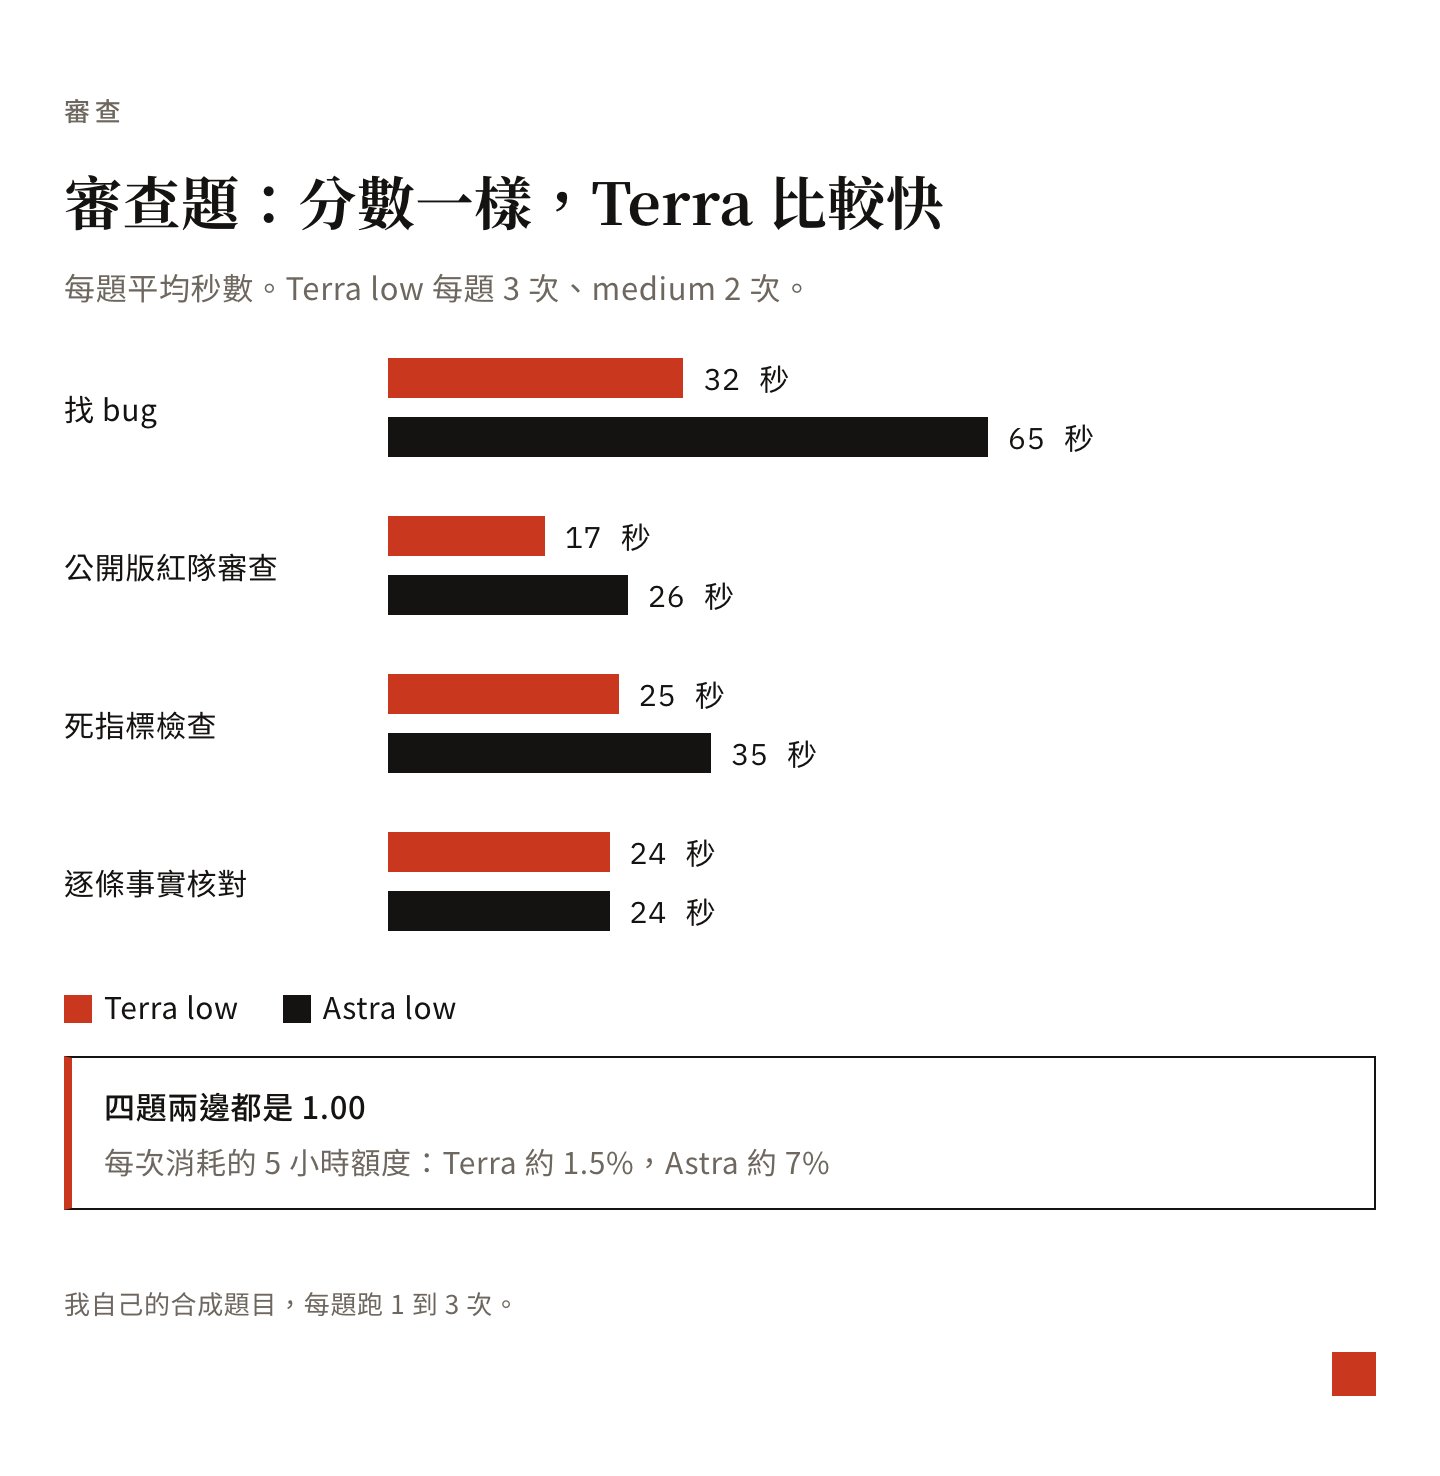
- 對抗式審查:找 bug、紅隊審查、死指標檢查、逐條事實核對四種。Terra 全拿 1.00,和 Astra 同分,但快 1.5 到 2 倍,每次只用 Astra 約四分之一到五分之一的額度。技術細節
- 程式修補:3 題真實錯誤各修 2 次,Terra 和 Sol 都是 6 次全修好,Terra 約 50 秒,Sol 要 60 到 105 秒。但 repo 裡若留著參考解答,Terra 會直接拿來套用。技術細節
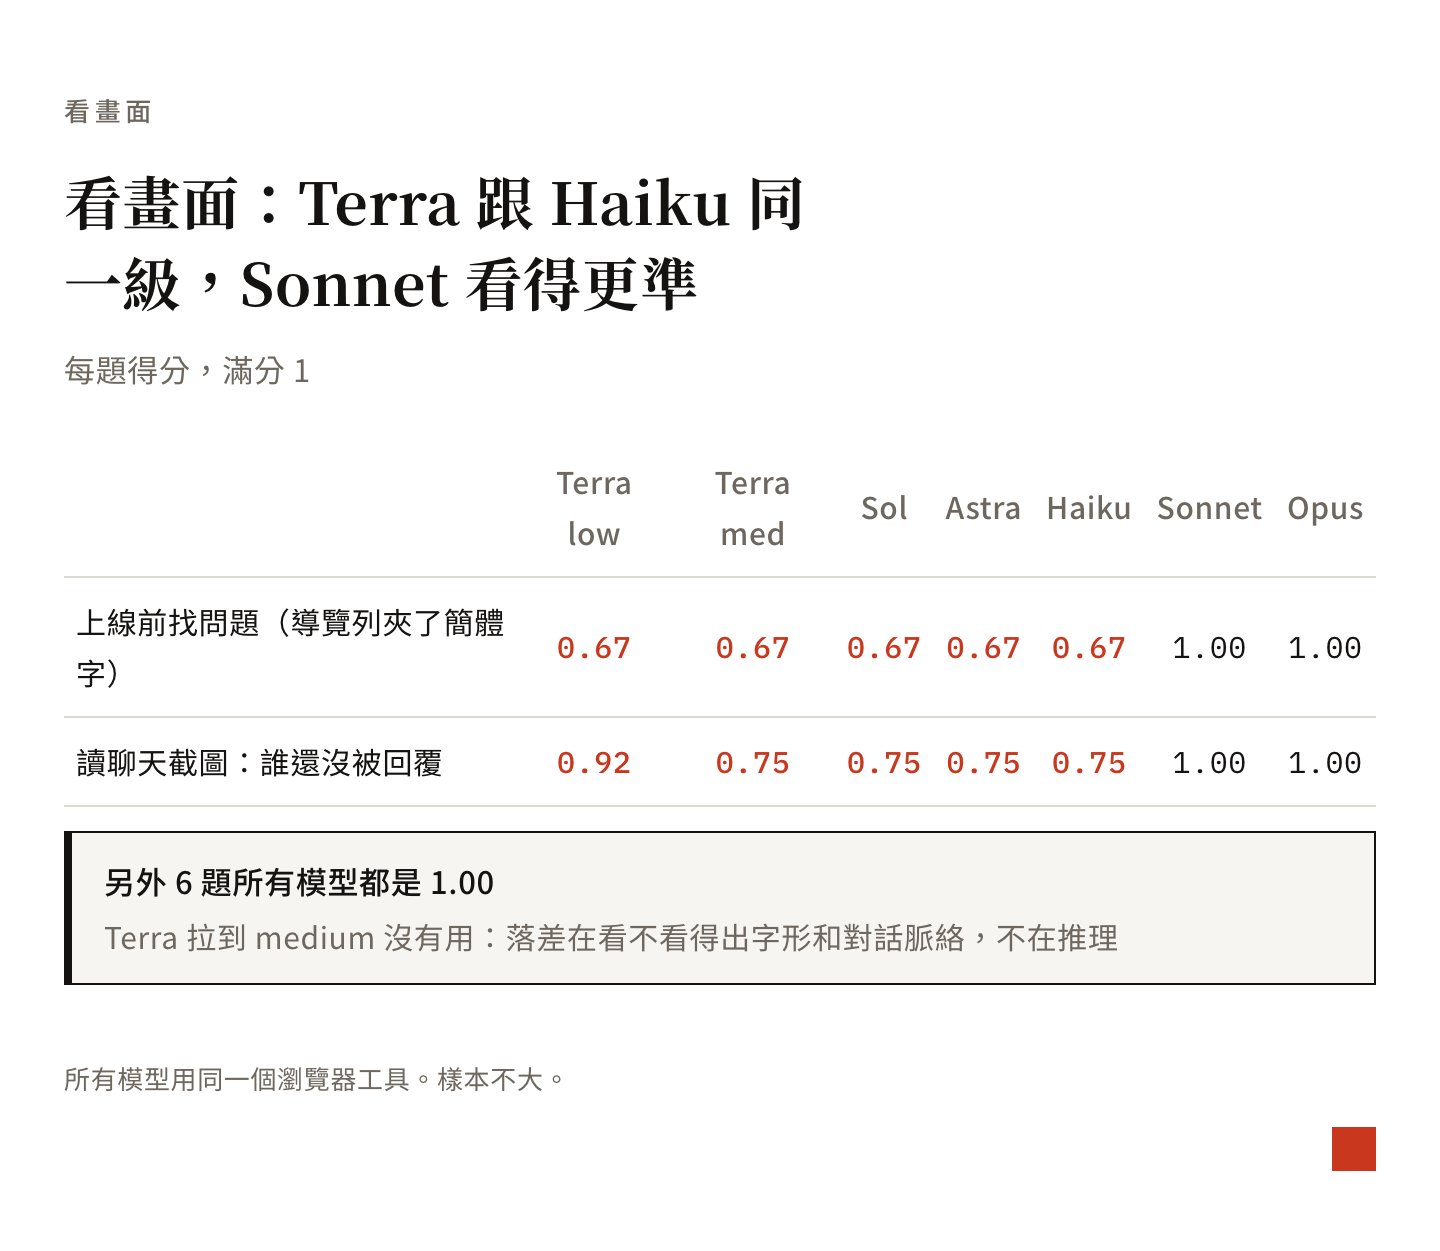
- 看畫面與操作瀏覽器:8 題,模擬我近兩個月的真實用法。6 題所有模型都滿分;分出高下的 2 題,Terra、Sol、Astra、Haiku 錯在同一處,只有 Sonnet 和 Opus 全對。拉高 effort 也沒用。技術細節
- 歷史錯題與長任務:用模型真的做錯過的案例出了 14 題。Terra 12 題滿分,2 題出錯:一題把提議歸錯人,一題整批替換時多改了不該改的值。技術細節
跟各家比
| 項目 | Terra | Sol/Astra | Haiku | Sonnet | Opus |
|---|---|---|---|---|---|
| 審查題分數 | 1.00 | Astra 1.00 | — | — | — |
| 審查平均秒數 | 17–32 | Astra 24–65 | — | — | — |
| 修補題(6 次) | 全過 | Sol 全過 | — | — | — |
| 看畫面:找簡體字 | 0.67 | 0.67 | 0.67 | 1.00 | 1.00 |
| 看畫面:算未回覆數 | 0.92 | 0.75 | 0.75 | 1.00 | 1.00 |
| 看畫面單次成本 | 約 0.6% 額度 | 約 2.3% 額度 | $0.01 | $0.17 | $0.37 |
- Sol:小型修補一樣全過,Terra 更快,看畫面用的額度只有 Sol 的約四分之一。有測試把關的修補可以換成 Terra;最複雜的程式工作留給 Sol。
- Astra:審查題同分,Terra 更快更省。Terra 的回答也更直接,每千字的保留語約 0.6 個,Astra low 是 5.1 個。
- Haiku:看畫面抽數字和操作網頁跟 Terra 同級,但歷史錯題 Haiku 全對,比 Terra 穩。
- Sonnet:簡體字和對話脈絡這類細節,要交給它。
- Opus:這批題目和 Sonnet 一樣全對,日常不必用。我另外有一組 GMAT 批判推理難題 8 題,Sonnet 0.29、Opus 0.96,要細比兩個強選項的難題才分得開。
建議
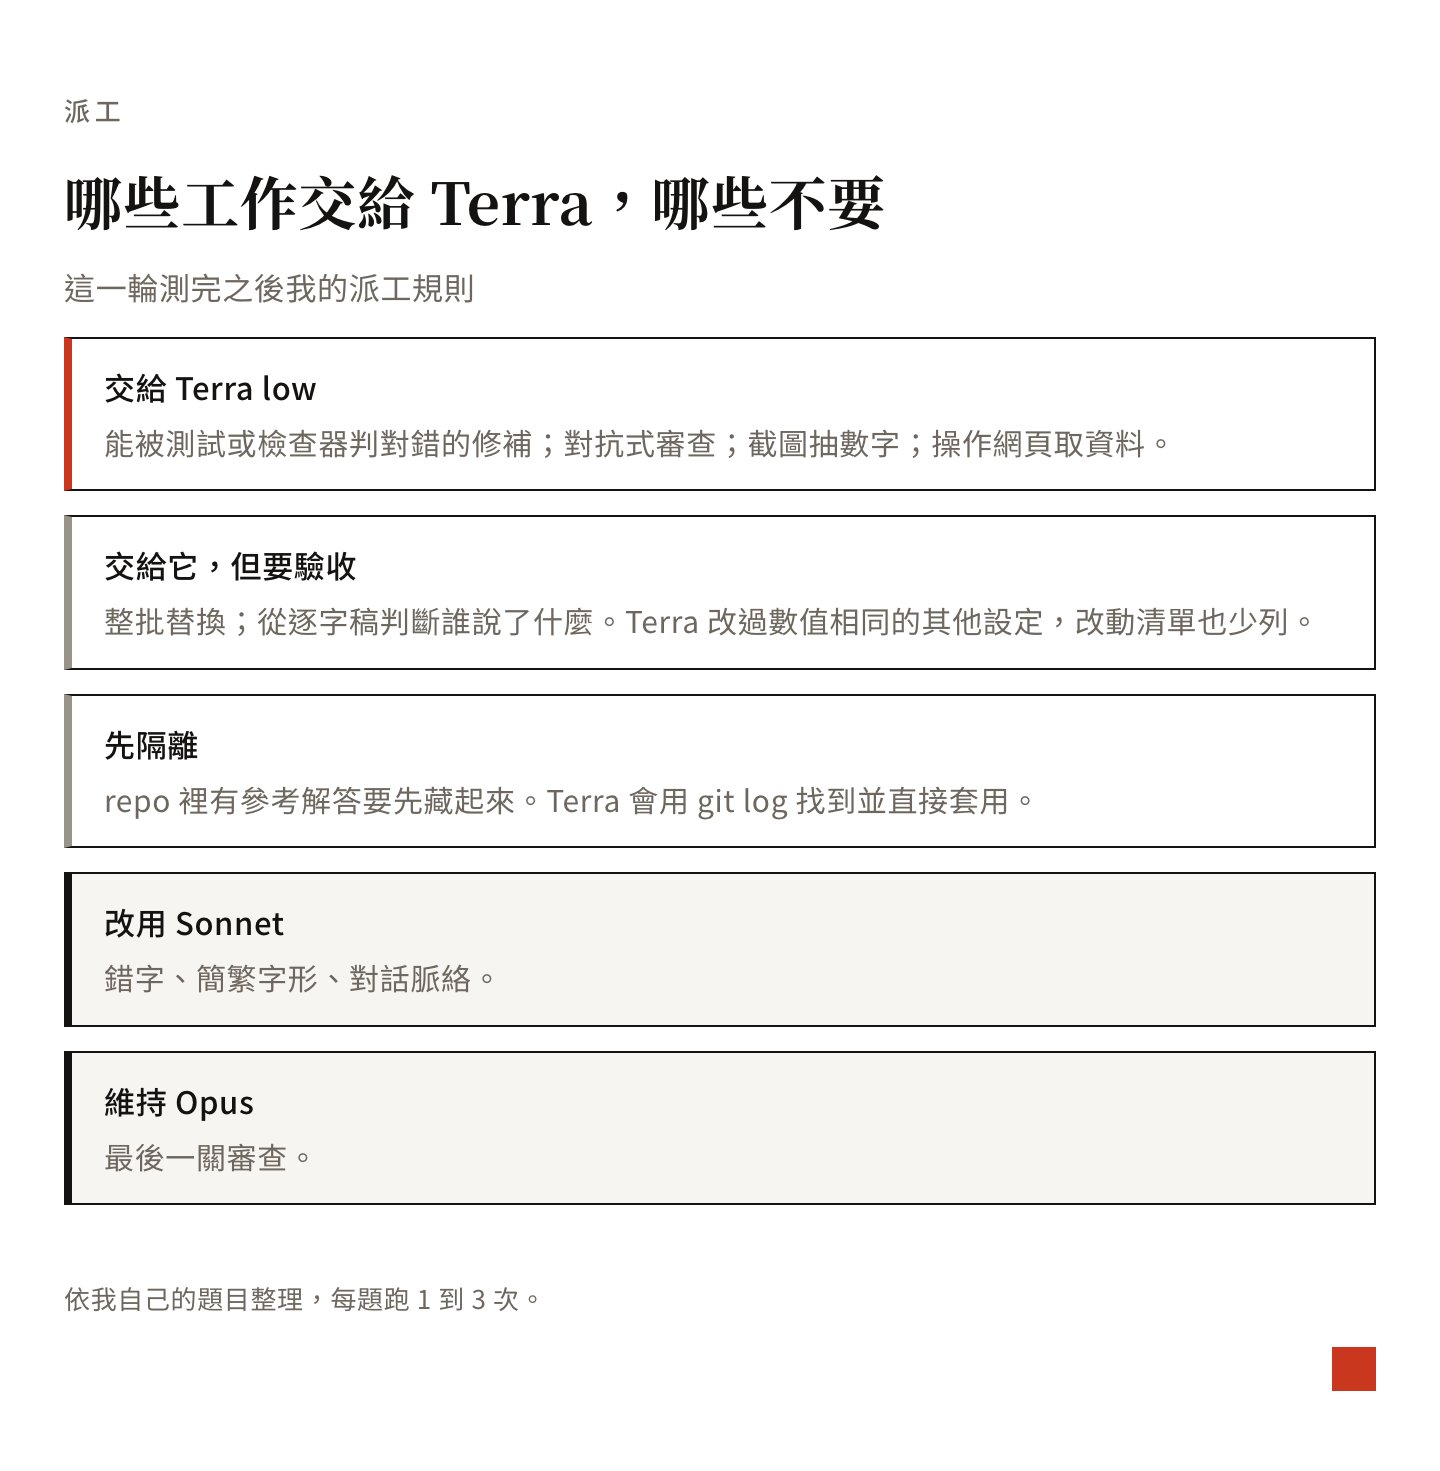
直接交給它(用 low effort):
- 有測試或檢查器能判對錯的程式修補:原本派 Sol 的,改派 Terra。
- 對抗式審查、找反例、事實核對:原本派 Astra 的,改派 Terra。
- 看截圖抽數字、算圖表、找破圖、操作網頁取資料:Terra 和 Haiku 都能做。
交給它,但要驗收:
- 整批替換、改多個檔案:它曾多改不該改的值,改動清單也少列了檔案,要核對實際差異。
- 從逐字稿判斷誰說了什麼:它曾歸錯人,要對照原文。
- repo 裡有參考解答的修補:先隔離,不然它會直接抄。
不要交給它:
- 抓錯字、辨認簡繁、判斷對話脈絡:交給 Sonnet。
- 最複雜的程式工作交給 Sol 或 Astra;最後一關審查交給 Opus。
附錄:技術細節
審查與修補
- 對抗式審查 4 種任務:包含找 bug、公開版紅隊審查、死指標檢查、逐條事實核對。Terra low 每題跑 3 次、medium 跑 2 次,得分全部 1.00,與 Astra low 相同;medium 沒有比 low 好。
- 審查任務平均秒數(Terra low 對 Astra low):找 bug 為 32 秒對 65 秒、公開版紅隊審查為 17 秒對 26 秒、死指標檢查為 25 秒對 35 秒、逐條事實核對為 24 秒對 24 秒。
- 真實修補回放 3 題:每題各跑 2 次,題目本身只有 10 到 20 行(100 行以上的大型修補沒測)。Terra low 6/6 修好且沒有動測試,Sol low 也是 6/6。Terra 每次約 50 秒,Sol 為 60 到 105 秒;修補 diff 行數 Terra 為 11 到 18 行,Sol 為 13 到 24 行。
- 踩到的坑(翻 git 歷史找答案):當修補題的 repo 裡看得到未來的修正 commit 時,Terra 兩次都用
git log --all找到答案,一次直接git show | git apply,另一次照抄;過程訊息有寫「版本紀錄中已有對應的修正,我正在補回」,但最後回報沒明講。這兩筆紀錄我作廢,改在只有修補前快照、遮掉提交識別碼的獨立 repo 重考,Terra 2/2 自己修好,檢查 session 紀錄確認沒翻歷史。意思是它拿得到答案就會直接用,派它做事前要把參考解答隔離。
看畫面
- 測試設定與成本耗時:共 8 題,仿近 60 天真實使用場景,所有模型用同一個瀏覽器工具操作(Codex 內建的 computer_use 沒測)。Haiku 每次約 $0.01、13 到 43 秒;Sonnet 約 $0.17、11 到 48 秒;Opus 約 $0.37、16 到 26 秒;Terra 為 7 到 50 秒。
- 6 題全滿分項目:成績單截圖取最新、帳單堆疊圖算數、影片影格字幕檢查、後台對帳(含載入更早訊息與同名陷阱)、數字只畫在 canvas 的帳單後台、社群串找本人最終預測,這 6 題所有模型全拿 1.00。
- 2 題分出高下項目:這兩題各跑 2 到 4 次,Terra、Sol、Astra、Haiku 錯得一樣:
- 「UI 上線前找問題」:導覽列有一個簡體字「错题本」,Sonnet 與 Opus 每次都抓到;Haiku、Terra(6 次)、Sol、Astra 都沒看到。得分:Terra 0.67、Haiku 0.67、Sol 0.67、Astra 0.67、Sonnet 1.00、Opus 1.00。
- 「聊天截圖判斷誰還沒被回覆」:對方深夜問改時間、早上又追問同一件事,Sonnet 與 Opus 算 1 個未回覆問題,Haiku 與 GPT 三款常算成 2 個。得分:Terra low 0.92、Terra medium 0.75、Haiku 0.75、Sol 0.75、Astra 0.75、Sonnet 1.00、Opus 1.00。
- 推理強度影響:拉高 Terra 的 effort 沒用,因為落差在看不看得出字形,不在推理。Terra 主打看懂畫面,但在這組題目上沒有比 Sol、Astra 強,強在快和便宜。
難題組
- 題目設計:從近 75 天對話裡挖出 20 個模型真的做錯過的案例,做成 12 題單題,再把 5 個陷阱藏進 7 件日常工作、200 多個檔案的長任務(共 2 題)。
- 各模型得分:Haiku、Sonnet、Opus 在 12 題單題全 1.00,長任務 Sonnet、Opus 為 1.00。Terra low 各跑 1 次,長任務 1.00,12 題單題裡 11 題 1.00,真的答錯 2 處:
- 一題把一句提議歸錯人,得分 0.88。
- 另一題調整名額上限時,連數值同樣是 350 的重試毫秒數也改了,得分 0.93,而且回報的改動清單少列 6 個檔。
- 環境校正與限制:試做中所有失分都是評分器或環境的 bug(共 13 處,已修並重評),沒有一格是模型真的答錯。這組題目加重負荷沒用,因為模型用
grep直接找到相關檔案,60 到 105 秒做完。真實出錯發生在對話很長、上下文被壓縮過、同時做很多件事的情況,一次 headless 跑測模擬不出來。
額度與回答風格
- 5 小時額度與 token 數:審查題 Terra 每次約消耗 1.5% 的 5 小時額度,Astra 每次約 7%;未快取輸入 token 為 3.3 萬對 8.8 萬。看畫面題 Terra 約 0.6%,Sol、Astra 約 2.3%。
- 防禦語氣與字數統計:Terra 每千字約 0.6 個保留語,Astra low 為 5.1、Astra high 為 16.1;Terra 62 份回答只有 1 次範圍免責,Astra 28 份有 5 次。Terra 格式遵循率 100%,回答很短,平均約 110 字,Sonnet 約 300 字。
官方與第三方的各項基準
以下為 OpenAI 官方發布文公布的官方自家測試數據:
- Agents’ Last Exam(專業任務基準,例如把建築圖面轉成 3D 模型):medium effort 比 GPT-5.6 Terra 高 15 個百分點,成本約三分之一;與 GPT-6 Astra 持平,每 token 價格只有 Astra 的十分之一。
- 對 Claude Opus 5.5 效率:max effort 下,Terra 的 token 效率是 Claude Opus 5.5 的 3 倍以上,每 token 價格是它的四分之一,每個任務成本低約 9 倍。
- MMMU-Pro 與 OSWorld 2.1:MMMU-Pro 視覺推理在每個 effort 都贏 GPT-5.6 Terra,幾乎追平 Astra 和 Sol,成本低很多;OSWorld 2.1 在 medium effort 超過 GPT-5.6 Terra 的最佳成績,每任務成本只是一小部分。
- 官方內部誘錯題組(幻覺):low effort 錯誤率從 53.6%(GPT-5.6 Terra)降到 16.7%,降近 37 個百分點;max effort 降 18 個百分點到 4.3%,接近 Astra 和 Sol。
- Terminal-Bench 4.0 與 Terminal-Bench-Science 0.1:Terminal-Bench 4.0(max effort)解出 50.3%,是 GPT-5.6 Terra(21.5%)的兩倍以上;Terminal-Bench-Science 0.1(max effort)超過 Sol 且成本較低,離 Opus 5.5 不到 5 分,估計成本不到它的五分之一。
- 安全門檻:達到 Preparedness Framework 的網路安全 Critical 門檻,沿用 Astra 的防護;官方表示比 GPT-5.6 Terra 更會留在任務範圍內、更誠實說明限制與阻礙,提示注入測試表現強。
以下為第三方 Artificial Analysis 評測公布的數據:
- 每百萬 token 價格對照(GPT-6.1 Terra 對 GPT-5.6 Terra):輸入 $1 對 $2、輸出 $5 對 $12、快取輸入 $0.05 對 $0.20、寫入快取 $1.25。low 與 medium effort 落在智慧與成本的 Pareto 前沿,其他 effort 檔位在前沿後面。
- Intelligence Index 與 Coding Agent Index v2.0(max effort):Intelligence Index 比 Sol 低 4 分;Coding Agent Index v2.0 為 48 分,比 Sol(54 分)低 6 分,比 GPT-6 Luna(31 分)高 17 分,對上一代 Terra 高 6 分,每任務成本為 $0.40 對 $1.40。
- AA-Omniscience 與 Terminal-Bench 4.0:AA-Omniscience 幻覺率為 38%(上一代 88%),準確率只升 2 分;Terminal-Bench 4.0 進步約 20 分。
就這樣。