我平常有一對一的家教課。最近我請 AI 把我實際上怎麼上課整理成一份規則,以後備課或寫課後筆記就照著它走,我自己叫它教學規格。這份規格是直接從上課逐字稿抓出來的:一個 AI 回頭讀逐字稿、還原課堂上實際發生的事來起草,另一個 AI 專門抓毛病挑錯,我只負責在一張網頁清單上逐條做決定。定下來之後也不是就定案了,下一堂課遇到狀況,隨時可能推翻重寫。
這篇整理了我原本卡在哪、這份規格是怎麼改出來的、量到的數字,還有我平常對 AI 說的原話,文末也附了一段可以直接貼給 AI 的起手提示詞。想看流程圖和技術細節的話,可以直接跳到附錄:技術做法。
每週一封,只挑跟你工作有關的 AI 動態。免費訂閱電子報 →
原本的困擾
最明顯的問題是上課超時。我把 15 堂一對一課的逐字稿拉出來對時間:排定 1,320 分鐘,實際約 1,990 分鐘,多出 51%,約 11 小時沒有收費。回頭查原因,才發現上課的時間完全沒有被保護好:課前沒先確認學生準備好了沒、原本說好這堂要做的事被擠到一邊、我自己一示範就把時間塞滿、學生到底學會了沒有也沒人檢查,兩堂課之間我和學生更是完全沒有任何聯繫。
再來是規格寫了,課照舊在上。規格定下來一陣子之後,我發現自己實際的做法跟條文愈差愈遠。當時我是這樣跟 AI 說的(這裡說的 spec 就是這份規格):
自從定了 spec 以來飄移蠻多
拿出來一對照才發現,規格裡有些條文從來沒在課堂上發生過,但我真正一直在做的事,規格裡反倒沒寫。
如果直接叫 AI 寫規格,它寫出來的往往是一堂「理想中的課」,跟我實際上課完全對不上。只要少了「先回頭讀原始紀錄,看實際發生什麼」和「找另一個 AI 獨立挑錯」這兩步,AI 的初稿就會出問題。像有一次 AI 在整理附錄時,就悄悄漏掉了真實的步驟,甚至還編出一個根本不存在的指令。
最後是我自己的時間問題。我的時間該花在做決定,不該花在親手寫條文。AI 會把要我決定的事列成一張網頁清單,一列一件事,下面叫它審閱頁。但這張審閱頁常常愈長愈長,我好幾次嫌它太多、太長;上面列了幾項,就是我要花多少時間。
我希望的樣子,跟一路怎麼改的
我想要的分工其實很單純:從逐字稿抓重點、起草條文、挑錯抓毛病,全部交給 AI,而且要拆給不同的 AI 分頭做,不讓同一個 AI 自己寫自己審。我只出現在做決定那一步,打開一張網頁清單,一列做一個決定。
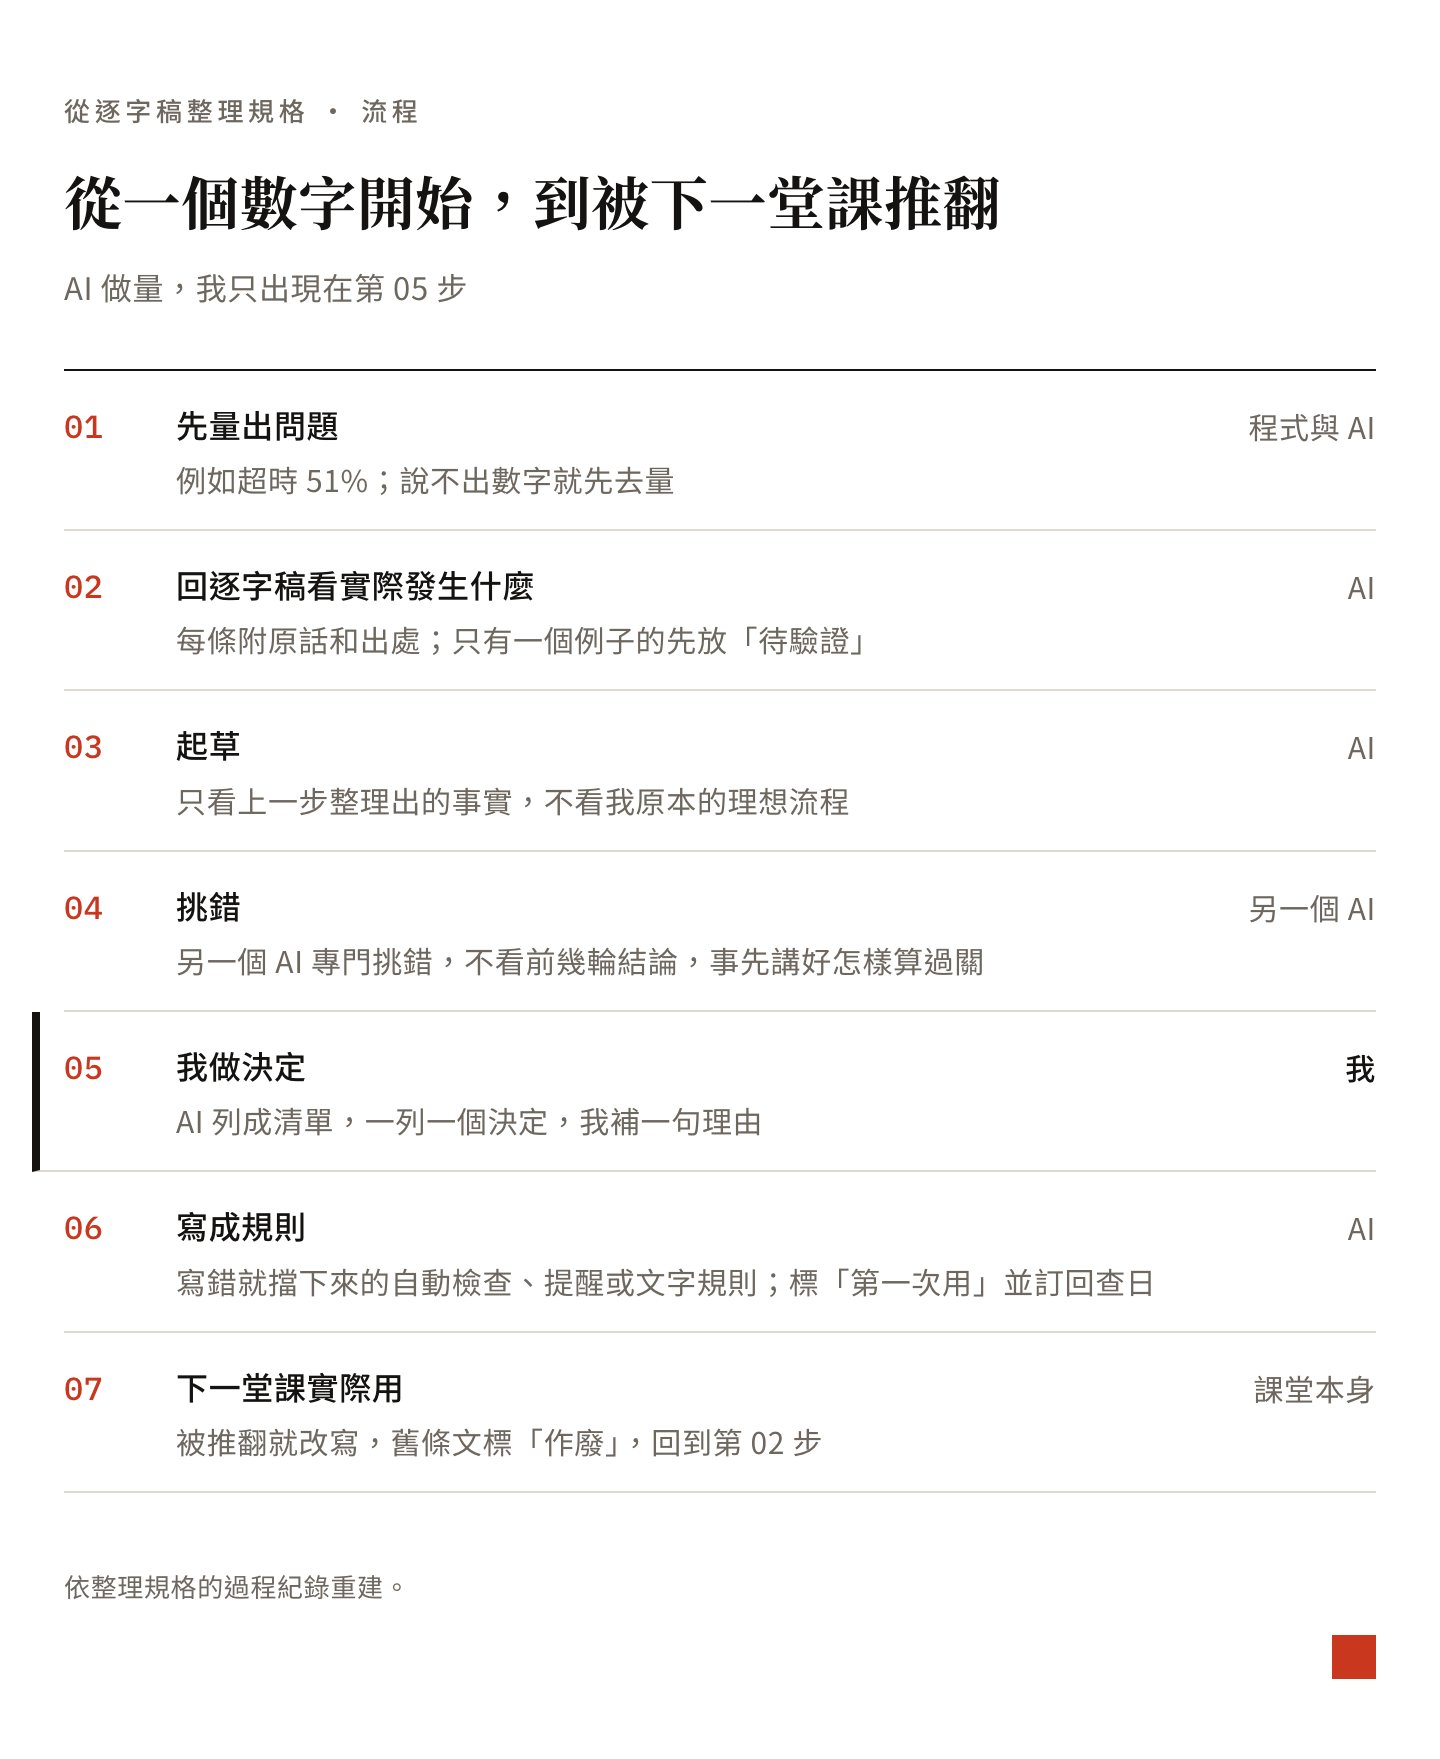
幾個關鍵轉折,按日期是這樣:
8/29,先量。 我把 15 堂一對一課的逐字稿查了一遍,量出上面那個多出 51%。那時規格改到第三版,這一版就直接從這個數字開始寫,不從「理想的一堂課應該長怎樣」開始。
9/25,量測推翻了自己。 我拿 8 堂課的逐字稿,重算課堂時間花在哪裡。第一次算出「我自己把話題延伸出去」的時間占 34%,換了一個新的判斷標準重算,只剩 15.6%。第一次的結果被自己推翻,我就把新數字記進備課資料裡。
9/26,課後改一輪。 那天 AI 幫我寫課堂筆記,我動手改了六個地方,改完直接叫它回頭檢討:
回顧這次我改了哪裡、規格有沒有涵蓋、你會怎麼修
AI 列出一張修改建議表,我確認之後,它直接去改規格,也改了它平常寫筆記時照著走的那份操作說明。
10/8,改到第五版。 我覺得實際教法跟規格又差太多,乾脆同時開了 4 個 AI 分頭讀,每個人各自讀完一整份 11 到 16 萬字的逐字稿。負責統整的那個 AI 把每條結論對應的時間點挑出來,回原文逐句核對過才採用,還順手抓到其中一份課後檢討紀錄用的根本是放寬之前的舊標準。最後 AI 把要改的地方分成三類:直接拿掉的、用意對但寫法錯要改說法的、我一直在做但規格沒寫的。我一則訊息回「三類都同意」。
實測
這裡量的是規格長出來的過程。我自己有兩種一對一課:一種教人用 AI,一種教 GMAT(申請商學院要考的考試),兩邊各維護一份規格。在兩個月內,規格從第三版改到第五版,GMAT 課那份扎實做了兩輪決定。對齊的基準,全都是逐字稿裡實際發生的事。
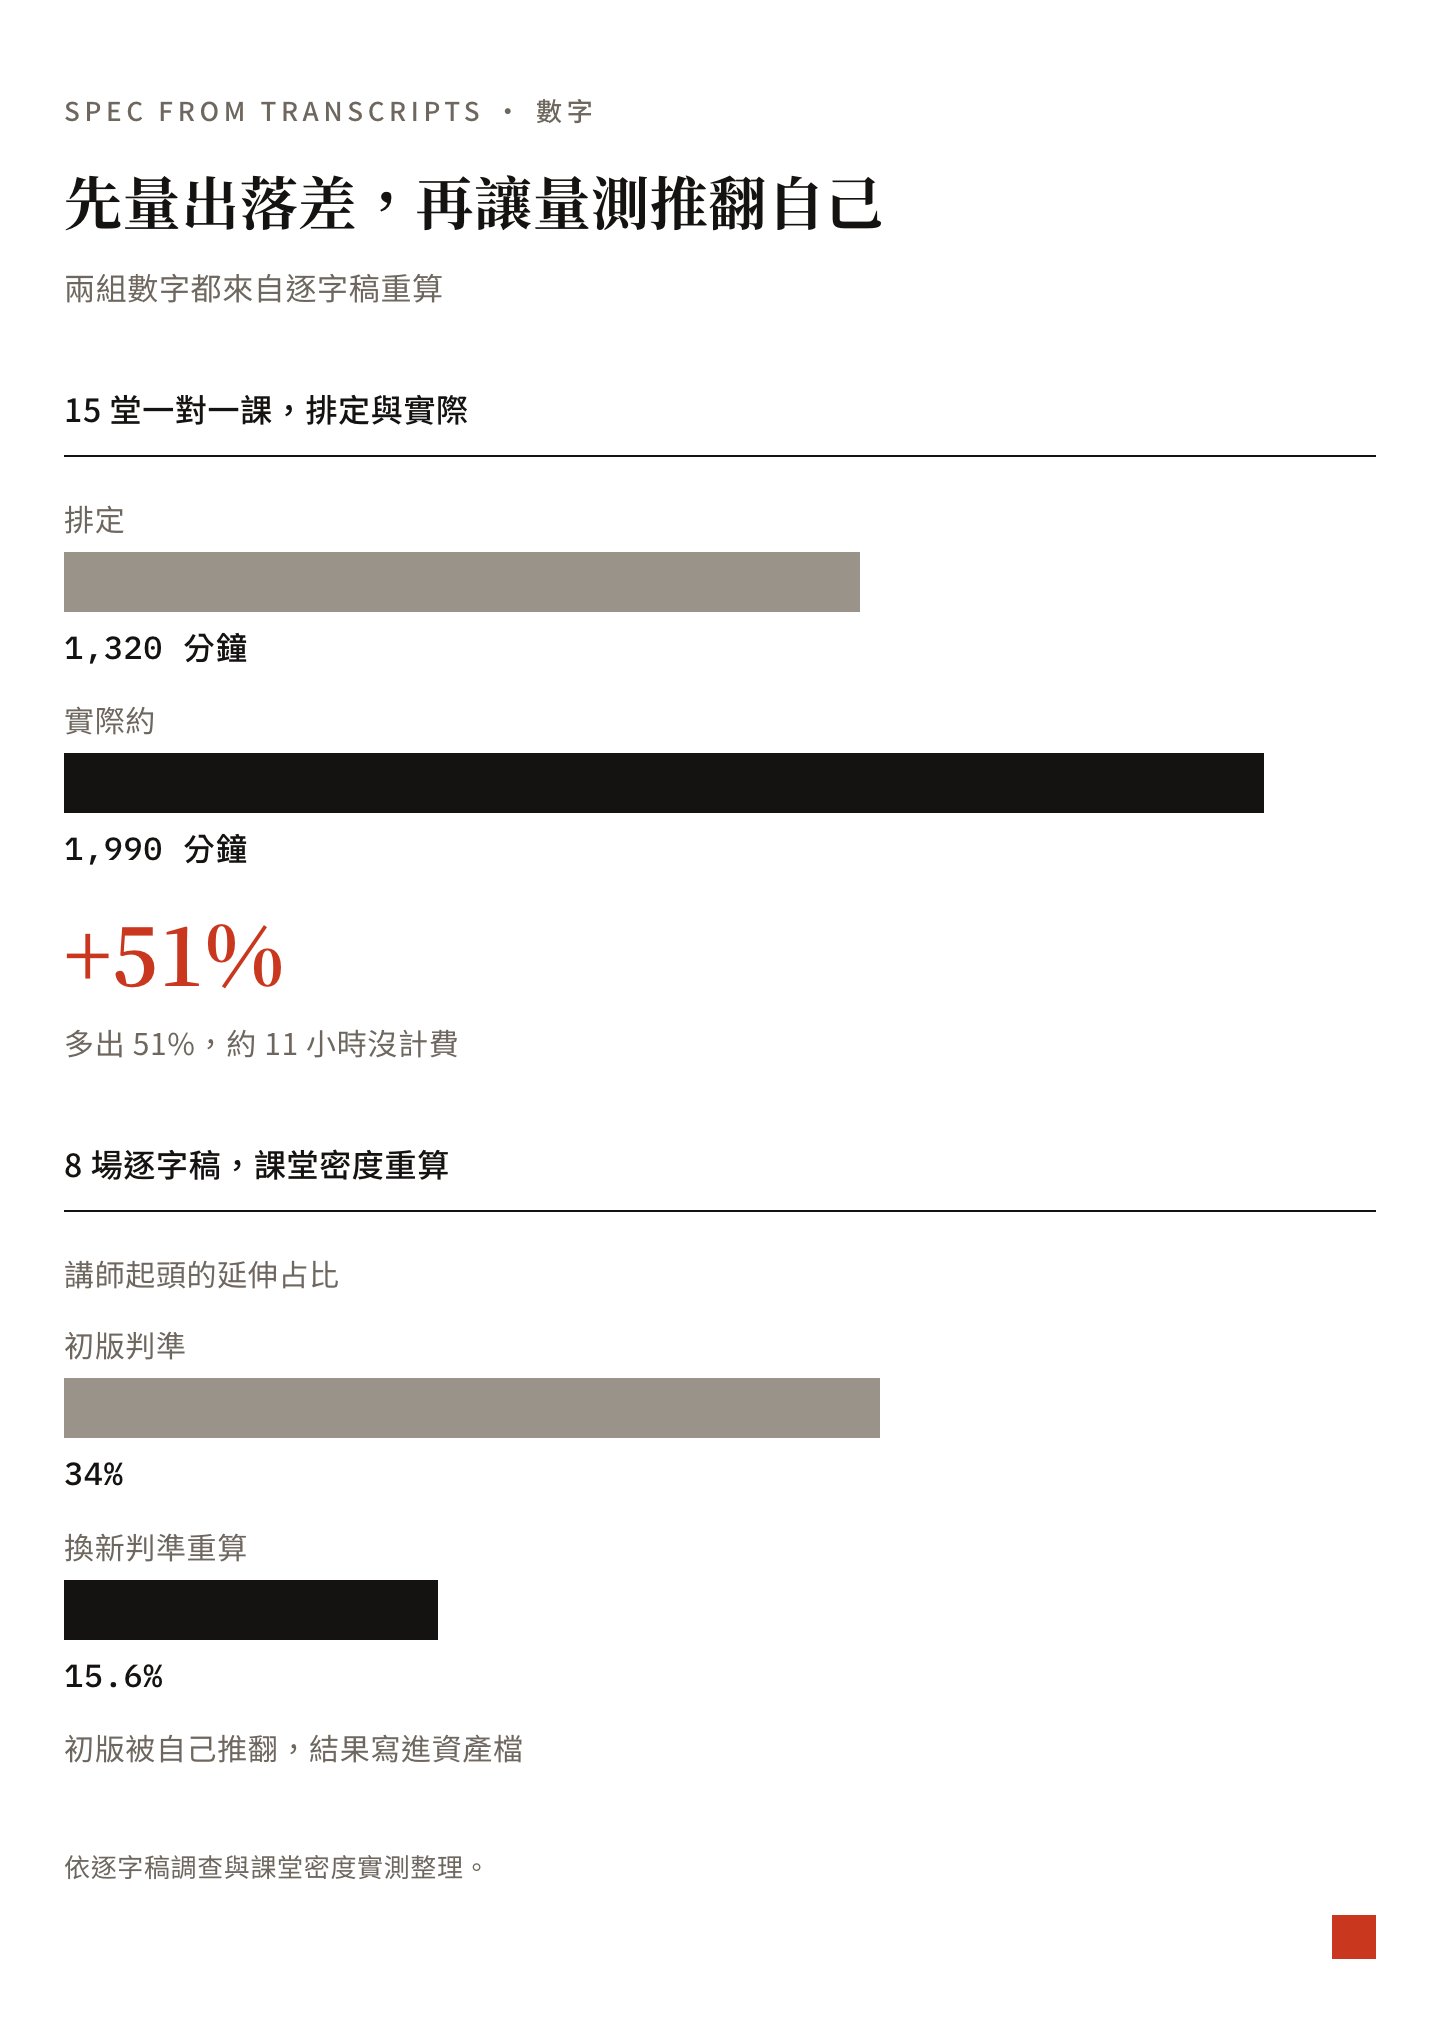
量測會推翻自己。 課堂時間那組數字,第一次算出 34%,換了新標準重算,只剩 15.6%。要是當初沒有回逐字稿重算,那個 34% 就直接寫進規格了。
獨立挑錯真的抓到錯。 GMAT 課那份規格的草稿,交給目前最強的 AI 模型審,一口氣挑出 17 條,最後 15 條採納、2 條部分採納,每一條怎麼處理、背後的原因是什麼,全部寫在規格的附錄裡。給學生看的說明文件那邊,我請 AI 每一輪扮演一位完全不懂技術的學生,從頭照著走一遍:光是第一輪就找出 25 個卡卡的地方,其中 7 個會讓學生完全做不下去。
多審幾輪不會變好,要改結構。 學生文件這樣審,每一輪都再冒出約 6 個新的卡死點,一路測到第五輪還是這樣。往深處查才發現有三個結構上的原因:同一件事分散在 5 份文件、2 種語言、12 處互相引用;負責審的 AI 每一輪都不記得上一輪;「新手會不會看不懂」這種問題本來就沒有盡頭。後來的解法是只留一份範本當正本,其他文件都從它自動產生,再加一道寫錯就擋下來的自動檢查;把約 100 條審查發現整理成一張每次都要重跑的檢查清單;同時定好明確的過關標準:卡死點為零就過,小問題不擋。結果到第七輪就收斂了。另一個例子是課後檢討紀錄:原本靠檔名分類,自動檢查漏掃了一些;改成看內容分類之後,檢查範圍從 11 份擴大到 21 份,當場發現這 21 份全都缺了三個必填項目。
我的時間花在做決定。 GMAT 課那份規格做了兩輪決定,審閱頁分別是 17 項和 11 項。第二輪沒有事先排,是從第一輪我補的意見延伸出來的:那些意見裡有四個問題要先查資料才能定,查完才變成第二輪的 11 項。其中一項是「課程開通延遲」,查完發現全是學生自己指定的開通日,當場直接結案。到了第五版那次,我只回了一則訊息就改完了。審閱頁第一版用了太多術語,我質問之後,AI 照白話的要求重寫了一次。
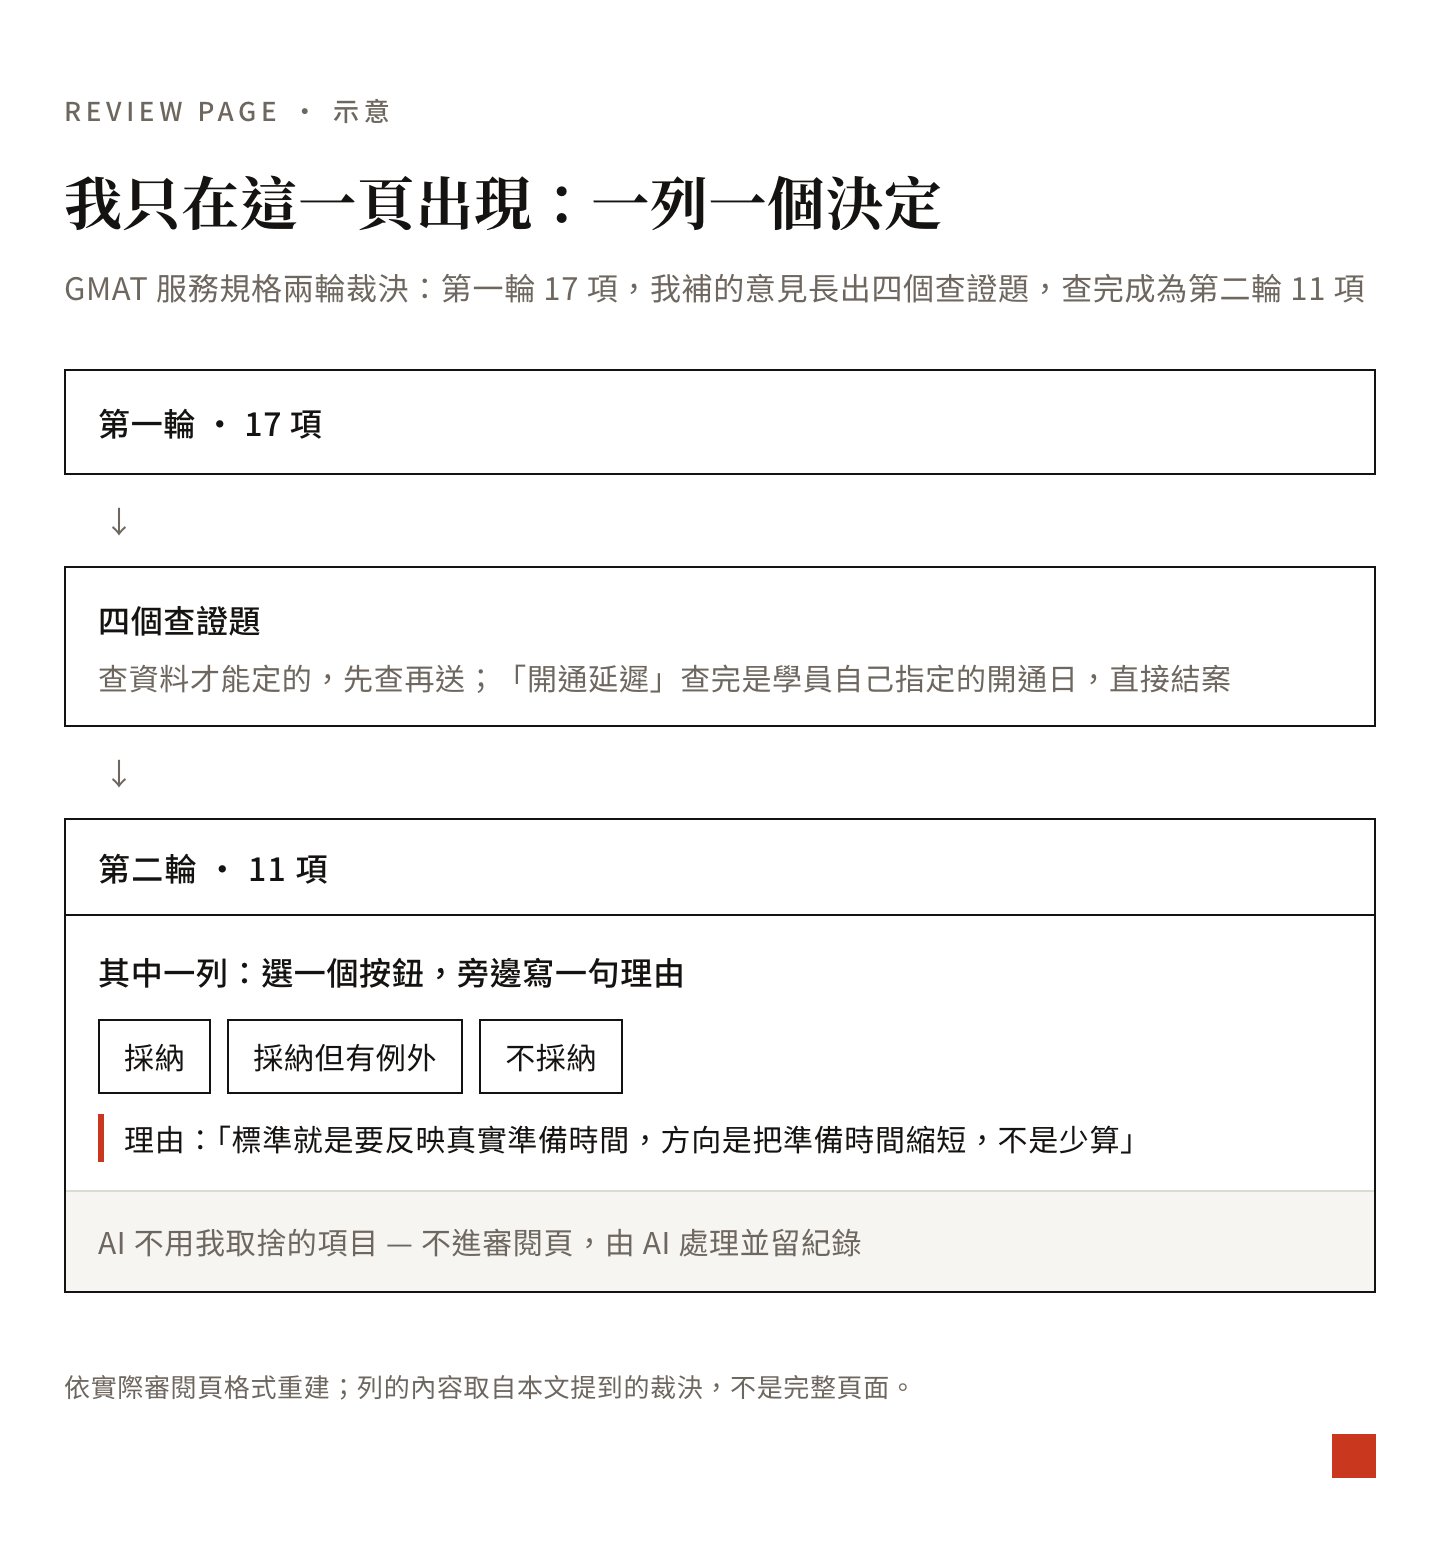
上圖依實際審閱頁格式重建。
自動檢查也要反過來測。 有一道檢查專門擋下「用了沒解釋過的內部代號」的內容,上線前我用七個例子反過來驗它:四種該擋的都擋了,三種該放的都放了。
規格上線之後,課有沒有比較準時、學生有沒有進步,老實說這兩件我都還沒開始量。目前真正量過的,純粹是規格跟我實際的做法對不對得上。
過程中我對 AI 說過的話
下面整理了幾句我在這個過程中對 AI 說過的原話。每段後面附一句,說明可以怎麼換成你的情境。
1. 不要在對話裡決定,改到頁面上
AI 原本在對話裡一次丟一長串選擇題給我,我直接回它(裁決頁就是上面說的審閱頁):
改裁決頁,我在裁決頁裡決定
換成你的情境:AI 丟給你一長串選擇題要你在對話裡回的時候,叫它改成一張頁面,一列一個決定,你在頁面上點。
2. 嫌太長就直接問
審閱頁又變長的時候,我這樣問:
要我裁的你確定要寫那麼多嗎
換成你的情境:審閱頁超過你願意看的長度,就這樣問。送上來的項目要先過濾,只留需要你判斷的。
3. 整批決定
就是上面 10/8 那次,AI 把改動分成三類,我回:
三類都同意
換成你的情境:請 AI 把改動分成幾類,每一類講清楚目的與理由。分得好,你一則訊息就能回完。
4. 順口補一句為什麼
有一項在討論我的備課時數該怎麼記,我做決定時順口補了一句:
標準就是要反映真實準備時間,方向是把準備時間縮短,不是少算
換成你的情境:做決定時多補一句理由。這句話後來決定了好幾條「備課時數怎麼記」的條文怎麼寫,理由比「選哪個」更能搬到下一個情境。
5. 改完之後叫它回顧
每次手動改完 AI 給的東西,我就直接丟這句:
回顧這次我改了哪裡、規格有沒有涵蓋、你會怎麼修
換成你的情境:你改完 AI 的成品,叫它把你改的地方對照現有規格,沒涵蓋的補進去。
6. 對自己的做法沒把握時直接問
拿不準做法的時候,我直接丟這句問它:
我的教學方法是不是還沒成形?
換成你的情境:把這個問題丟給 AI,請它對照你的紀錄回答。我得到的答案是教法本身穩定,變的是規格、課程方案和學生類型;真正還沒定的是「有沒有效」和「答應學生的事有沒有做到」,於是當場多了一份清單,專門記我答應學生什麼、做到了沒。
起手提示詞範本
想從自己的課堂紀錄長出規格,可以從這段開始。把括號換成你的情況,直接貼給讀得到你電腦檔案的 AI:
我想把我的課堂逐字稿整理成一份教學規格,也就是一份寫給 AI 看的上課規則,以後備課和寫課後筆記都要照著做。逐字稿放在(資料夾位置),請你先讀(幾場)逐字稿,幫我算出(我想改善的症狀,例如超時多少分鐘、說好的事沒做幾次),並從逐字稿還原我現在實際怎麼上課,起草一份規則。不確定的先標出來,需要我判斷的項目整理成一張清單。先給我一份計畫,我看過再開始。附錄:技術做法
這一段是給想自己動手做一套的人看的,技術名詞、檔案格式和規則都放在這裡。
正文白話對應的技術名詞
- 「一份寫給 AI 看的上課規則」:教學規格,AI 備課、寫筆記前先讀的那份規則檔。
- 「它平常寫筆記時照著走的操作說明」:Claude Code 的 skill。
- 「同時開 4 個 AI 分頭讀」:4 個平行的子代理(subagent)。
- 「負責統整的那個 AI」:主線,也就是你正在跟它對話的那個 session。
- 「另一個 AI 專門挑錯」:下面說的攻擊者,另開一個不帶前面結論的 session。
- 「目前最強的 AI 模型」:起草與攻擊用高階模型,抽取可以用便宜的模型。
- 「寫錯就擋下來的自動檢查」:寫入前觸發的 hook 和 lint 檢查。
- 「備課資料」:記錄量測結果的資產檔。
整體流程:誰把什麼交給誰
一輪規格生成有六個角色:唯讀的逐字稿、抽取者(可以用便宜的模型)、起草者與攻擊者(各是高階模型)、主線(你的對話)、以及我。三個 AI 角色分三次派,不合併成「寫完順便自己檢查」。
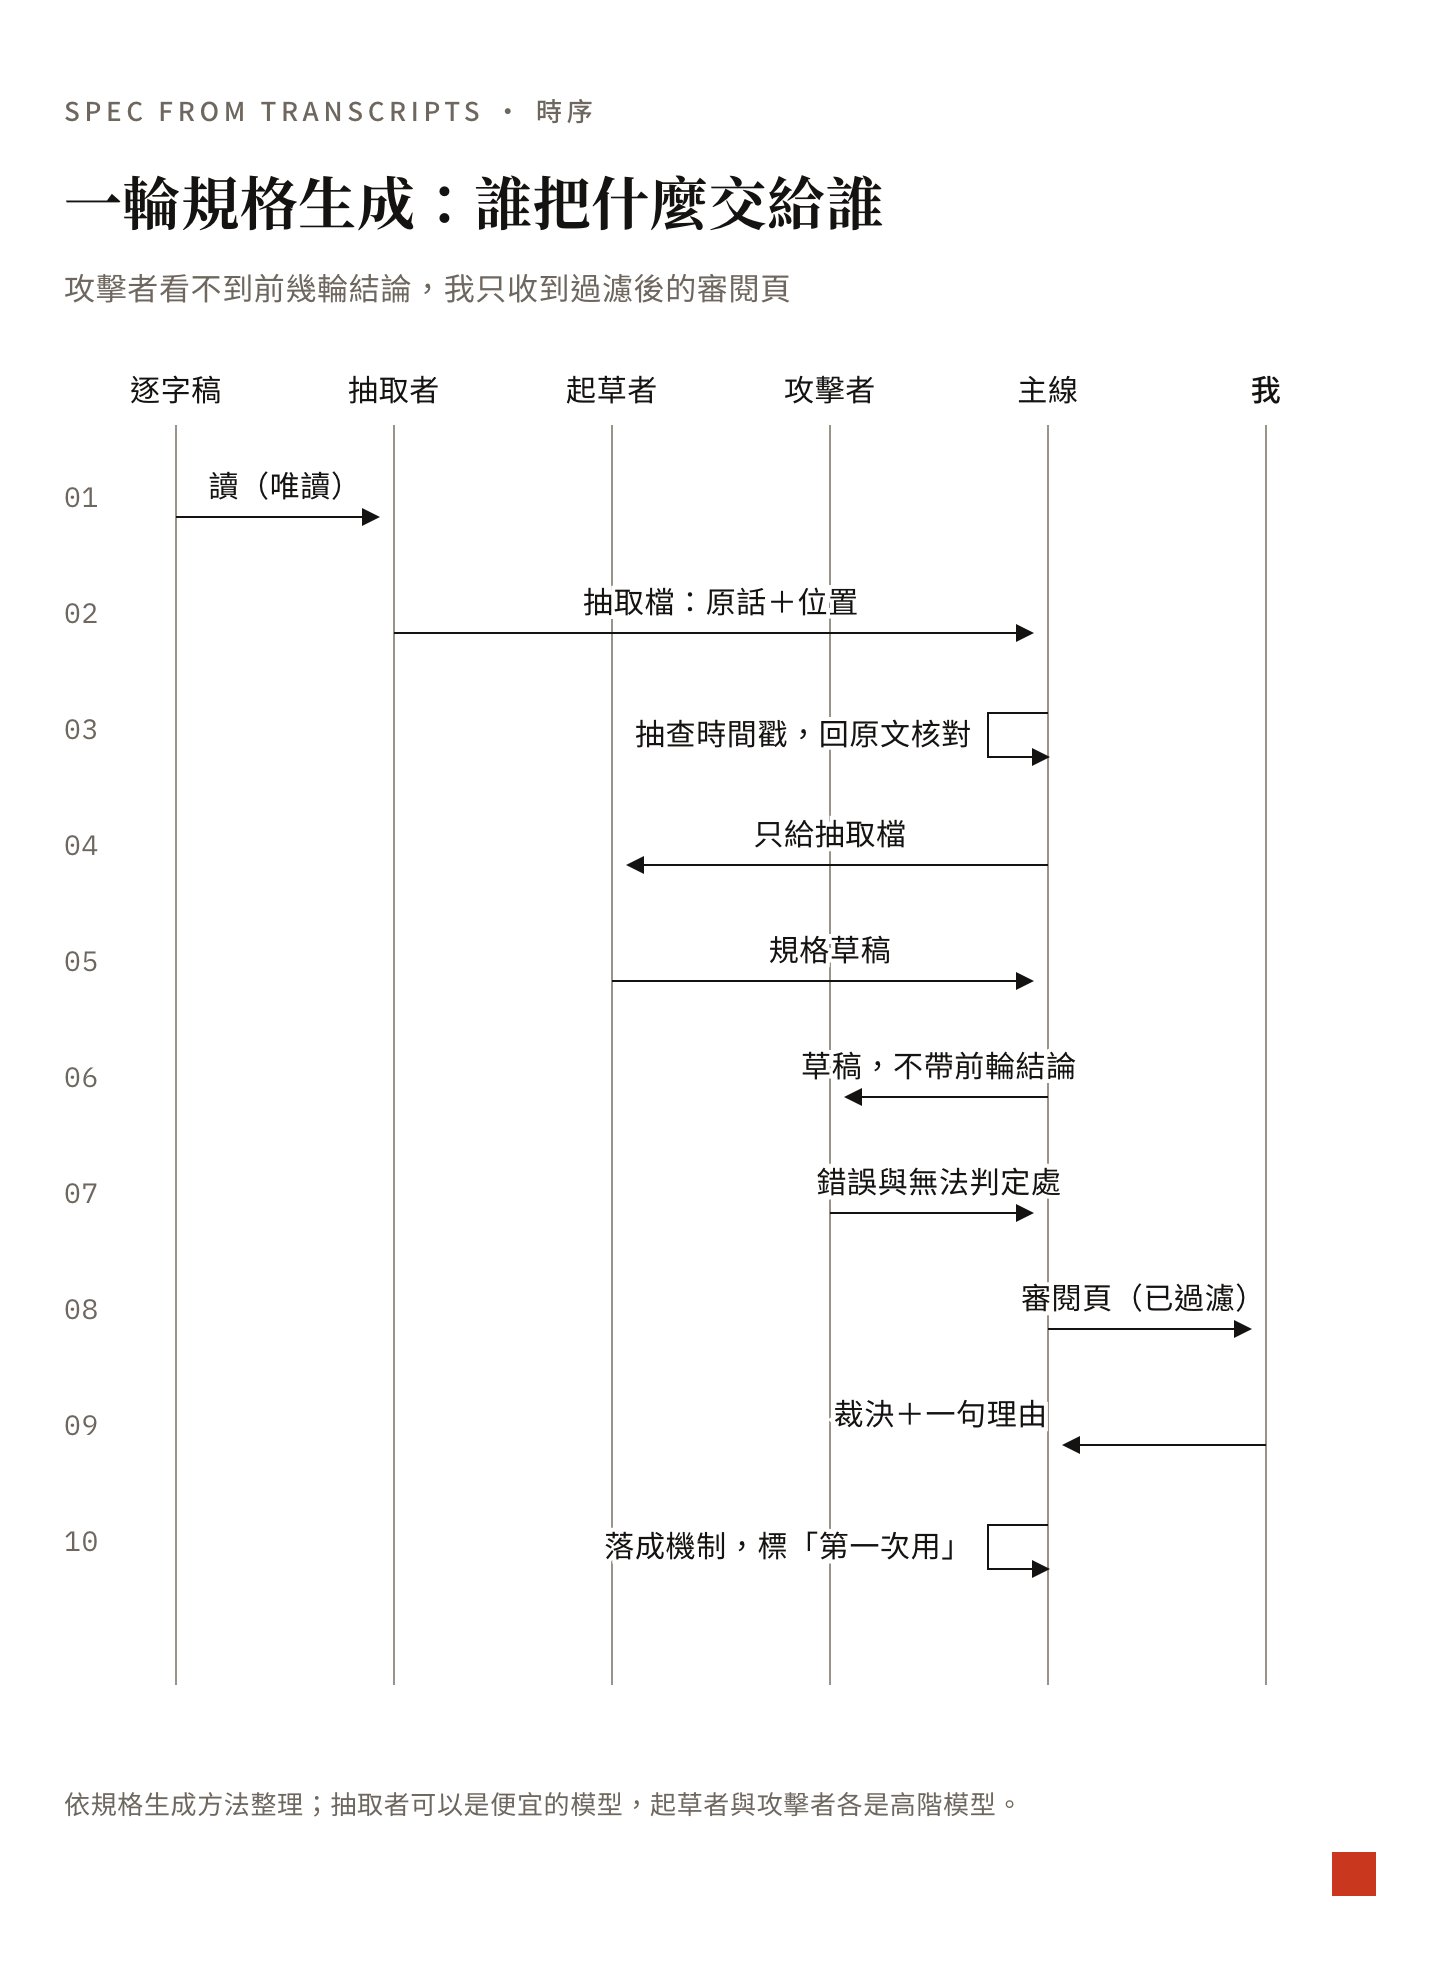
起草者只讀抽取結果,攻擊者另開,不帶前幾輪的結論。
逐字稿抽取
抽取用統一的問題集,每一項都要附逐字原話與位置。GMAT 課那份規格是請便宜的模型分 11 批,讀 47 位學員和 14 位諮詢對象的紀錄,產出 61 份抽取檔,再由高階模型只讀這些抽取檔寫規格。
抽取規格第一條這樣寫:每筆附 quote(20 到 120 字、逐字)與 pos(時間戳或行號)。主線收件後,用程式確認 quote 真的是原文的子字串。引句對不上的整筆作廢。最小版本如下:
import json, sys

def norm(s):
    return "".join(s.split())

def check(extract_path, transcript_path):
    transcript = norm(open(transcript_path, encoding="utf-8").read())
    items = json.load(open(extract_path, encoding="utf-8"))
    bad = [i for i in items if norm(i["quote"]) not in transcript]
    print(f"{len(items) - len(bad)} / {len(items)} quotes found in the transcript")
    for i in bad:
        print("NOT FOUND:", i["quote"][:40])

if __name__ == "__main__":
    check(sys.argv[1], sys.argv[2])
執行 python3 -I verify_quotes.py extract.json transcript.txt。這支腳本只驗引句在不在,驗不到「這句話有沒有被誤解」,所以主線還要抽時間戳回原文看上下文。第五版改版時就是這樣做,才抓到有份覆盤用的是放寬前的舊標準。
每一條規則至少要有兩個個案撐腰,所以規則表要多一欄「佐證個案數」,小於 2 的整列移到「待驗證」。
起草與攻擊
起草者只讀抽取檔。攻擊者另開,不帶前幾輪結論,也不看起草者的推理。攻擊者的指令要寫明不得假設結果正確、只回報錯誤與無法判定處、以及過關條件,否則它永遠找得到新問題。範例如下,括號留給你填:
你是攻擊者。以下是規格草稿和對應的逐字稿。
不得假設草稿是正確的。逐條回逐字稿核對。
只回報兩類:錯誤,以及你無法判定的地方。
過關條件:(例如:卡死點為零)。達到就停,次要問題不列。
另外,攻擊的角色可以換成讀者:請高階模型每輪扮演一位非技術學員,逐步走一遍學員文件。
審閱頁與裁決紀錄
不是每個項目都該送到我面前。送上來之前先過濾:
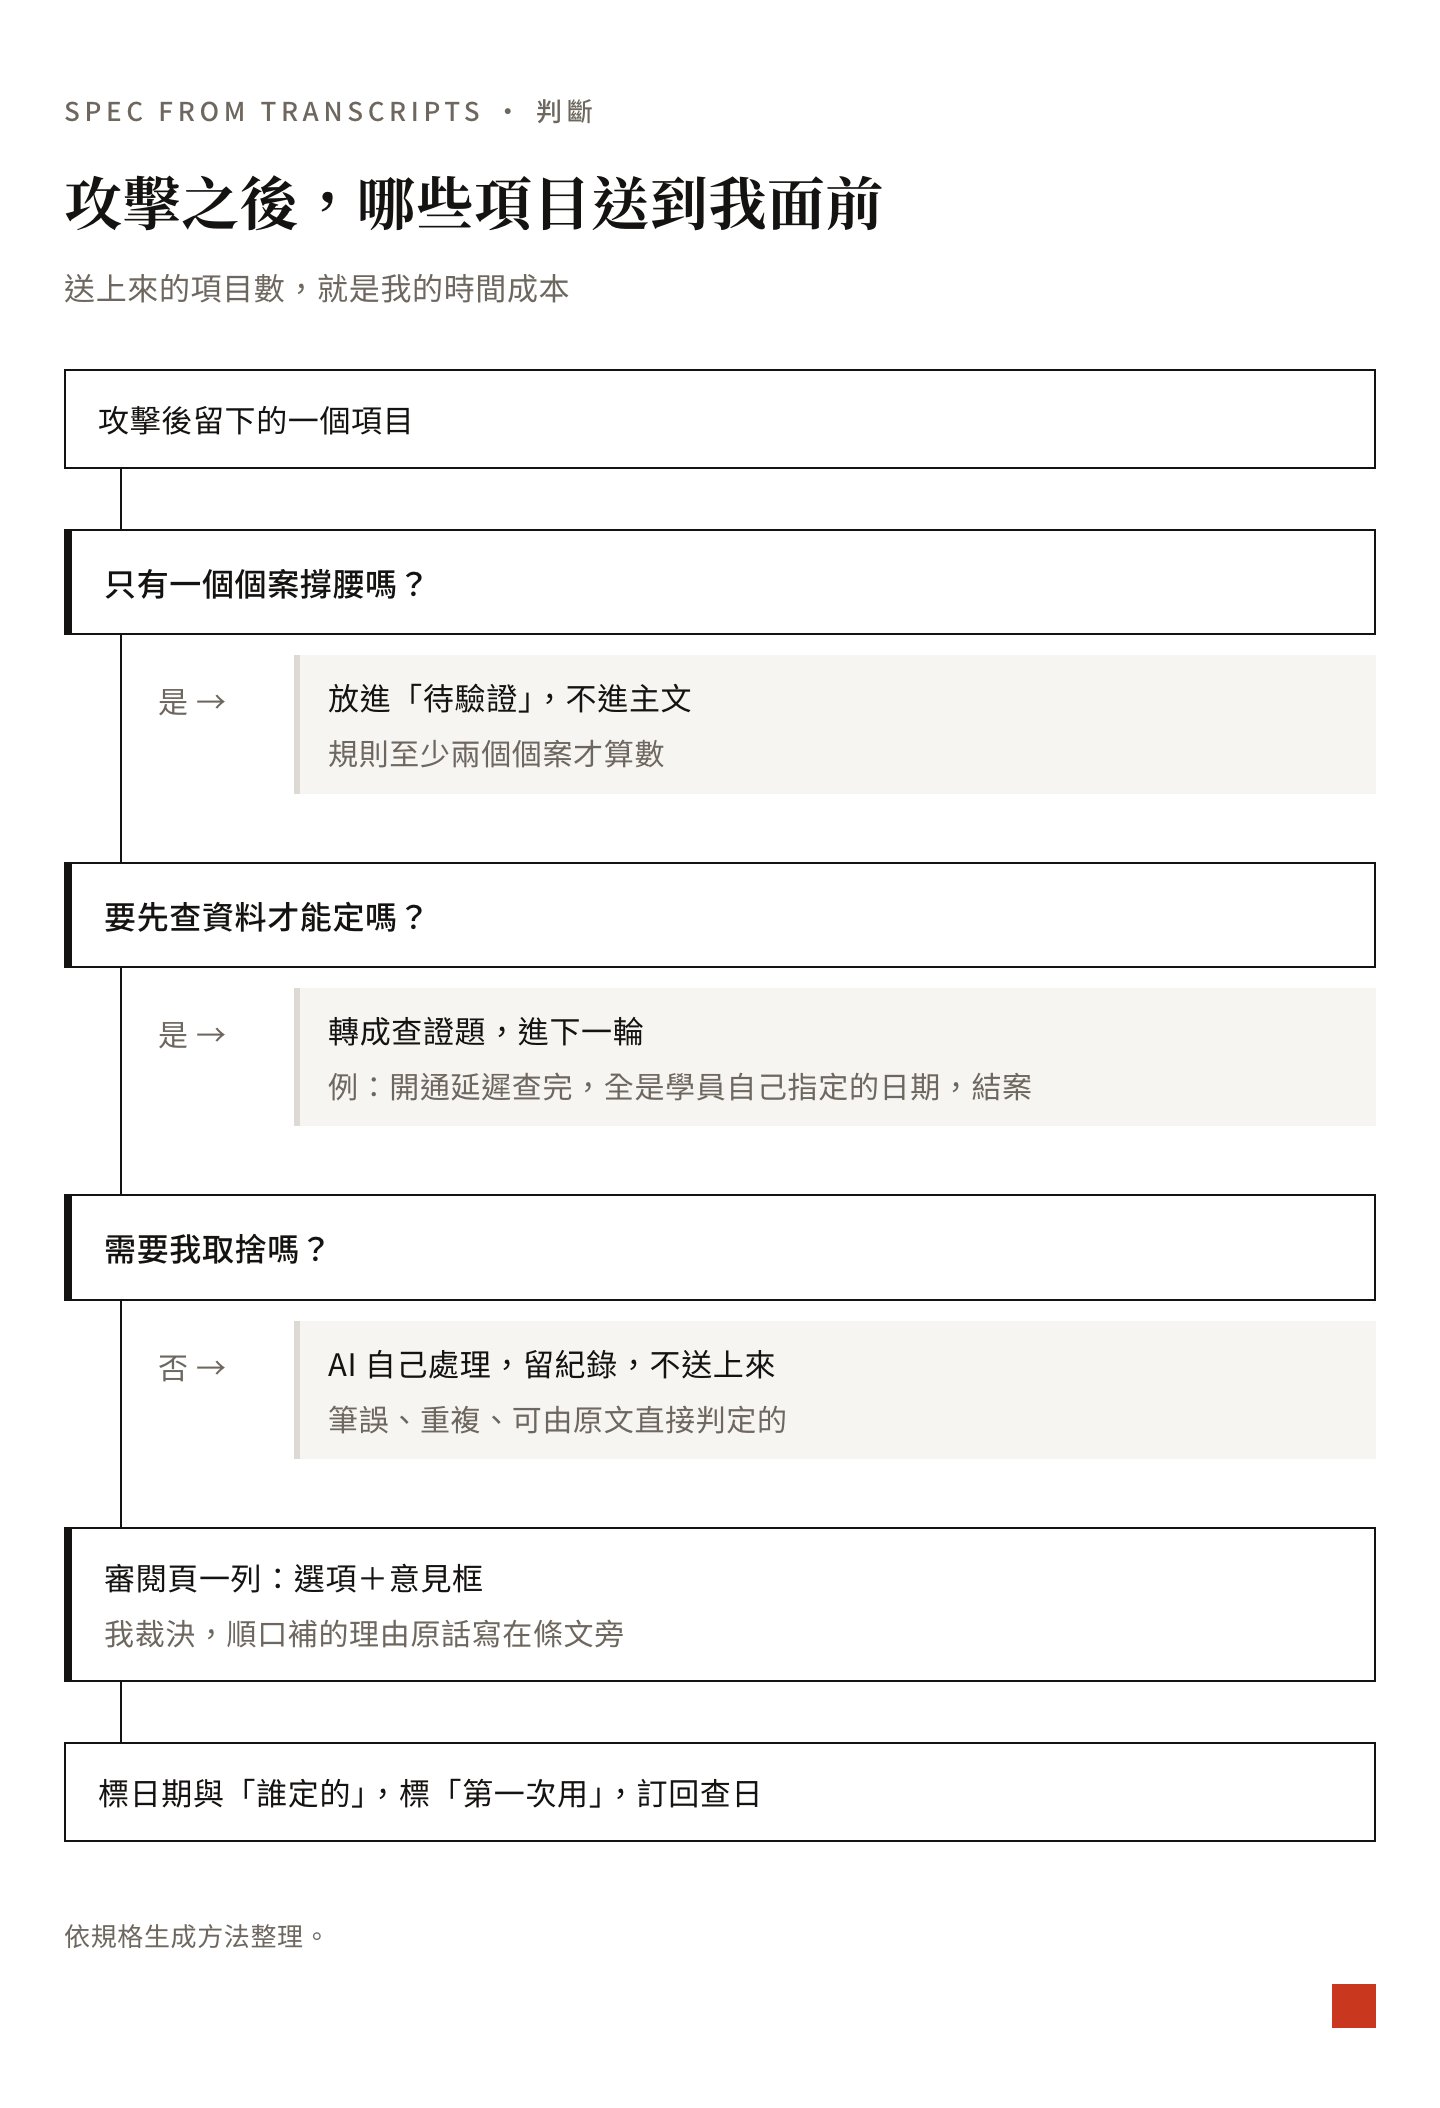
審閱頁每一列是一個決定:附選項(採納、採納但有例外、不採納)和意見框,底部只列有例外的項目,一鍵複製貼回對話。我用一個叫 review-page 的 skill 產生這張頁面。裁決寫回規格時,裁決紀錄固定四欄:
| 裁決 | 補充理由(原話) | 已做 | 待辦 |
|---|---|---|---|
| 採納 | 我順口補的那句 | 改了哪一條 | 要回查的事 |
每條修訂帶日期與「誰定的」。被推翻的舊條文標「作廢」,留在裁決紀錄,不靜默刪除。
規則的一生
新規則不直接當定案。標「第一次用、待觀察」,配一條有日期的回查待辦。回查時看實際有沒有在跑,跑不起來就收掉。偏離規格的做法先記成「已知變體」,第三次出現或驗證有效才升級。
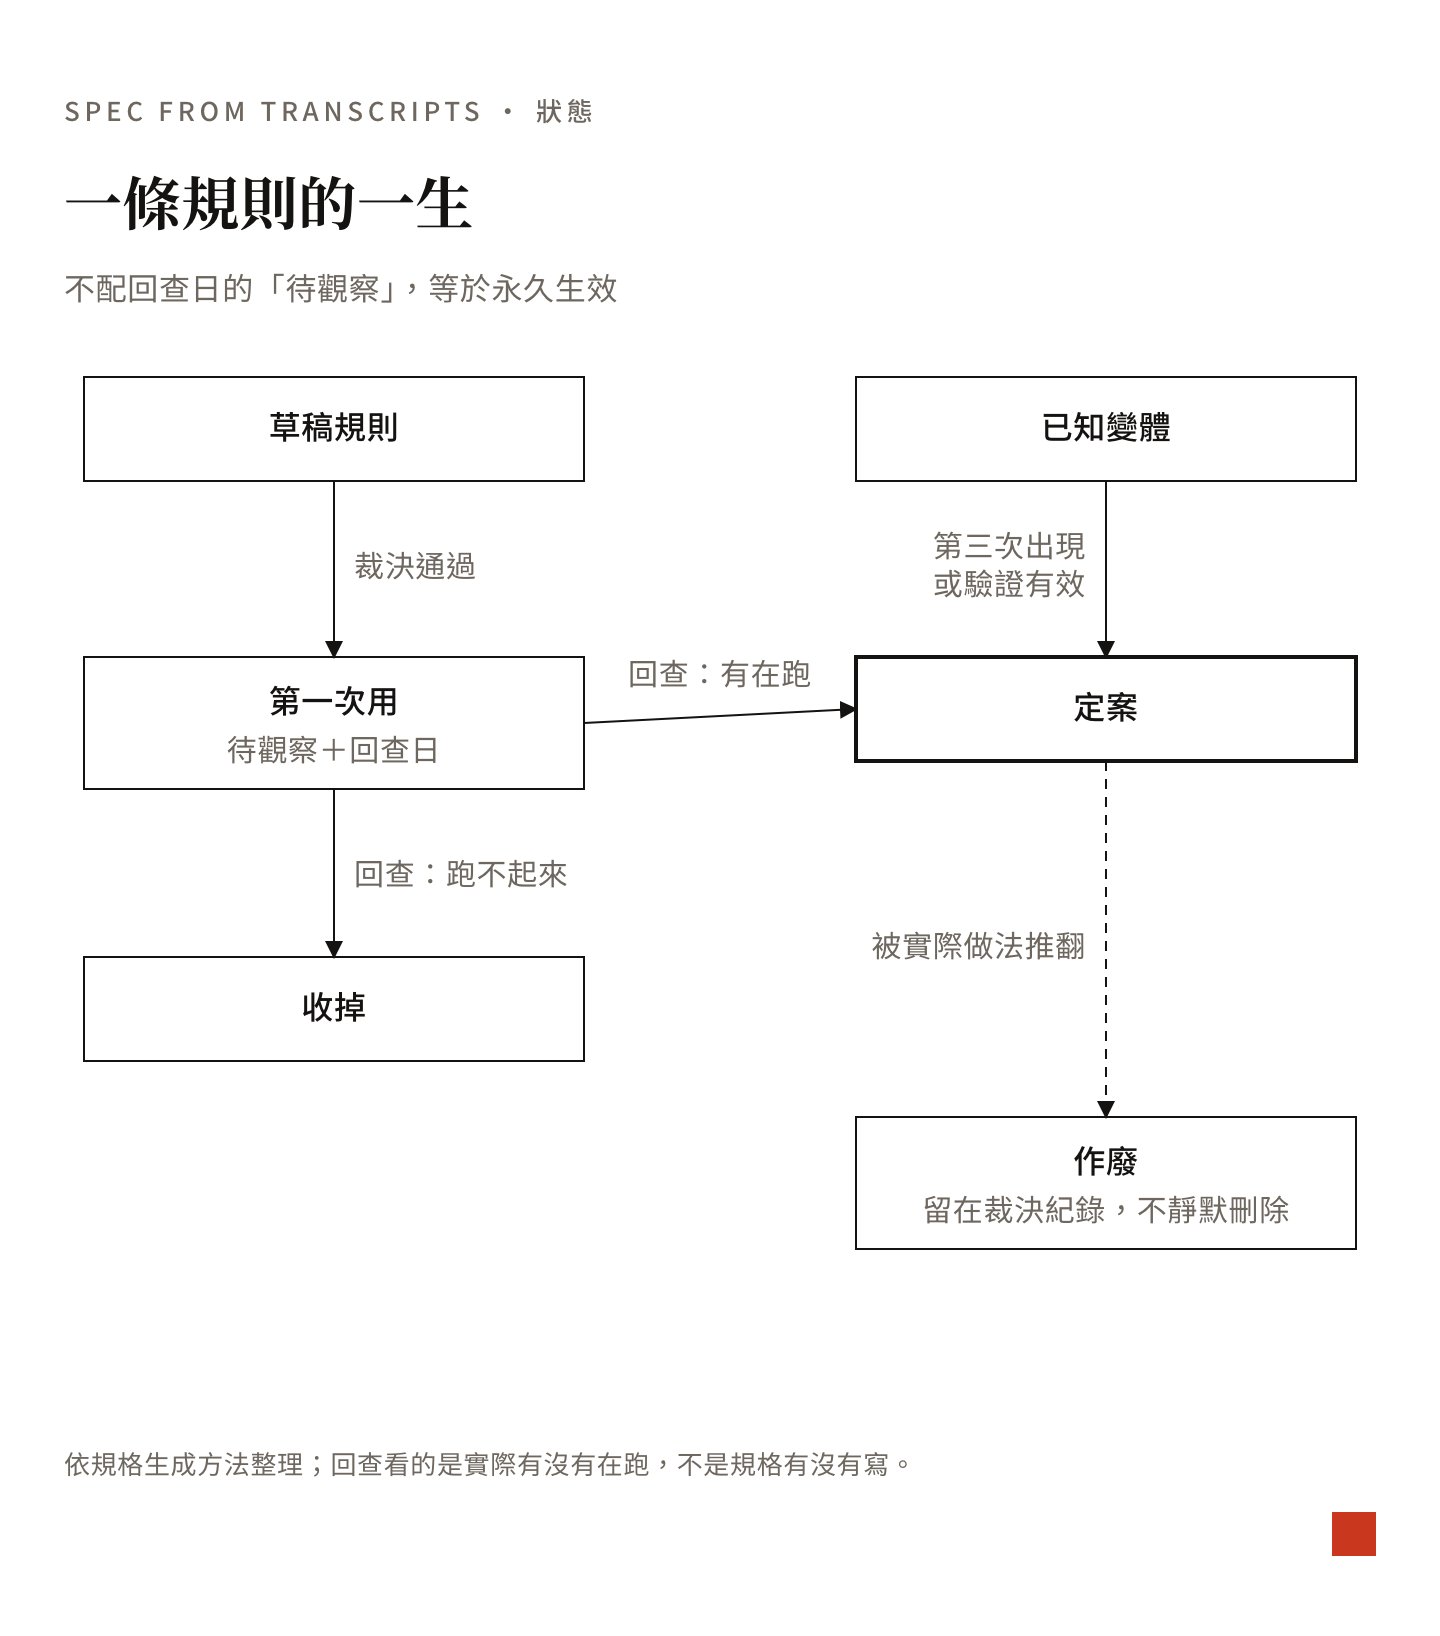
規則的強制度分三級:會擋寫入的閘門(hook、lint、由腳本擁有的欄位)、事後提醒、文字規則加定期回檢。能機器化的優先做成「寫錯當下擋下來」,閘門寫好之後要做反向測試,證明該擋的擋、該放的放。同一類問題第三次出現時,停下來問「是什麼結構讓它一直出現」,答案寫進提交訊息。
想自己做:最小版本
- 一個症狀,加一個算得出來的數字(超時幾分鐘、說好的事沒做幾次)。
- 一份抽取檔,每筆有
quote和pos,再用上面那支腳本驗過。 - 起草與攻擊各派一次,攻擊者不看前輪結論,指令裡寫明過關條件。
- 把需要你判斷的項目做成一頁,一列一個決定,你補的理由原話留在條文旁。
- 定案的規則標「第一次用」,訂一個回查日。