10/06 早上上課帶 Codex,慢到炸,都已經開 6.1 Sol low effort fast mode 了,還是慢到十幾分鐘才能回來看下一個 turn,雙開都解決不了尷尬⋯
還好林北以前是 150 人教室的大班講台磨練出來的,我只能發揮傳統教學技藝,各種尬聊,聊規劃、聊理想、聊未來的架構,然後也故意打開我的 Claude Code 示範,讓客戶看看速度差距。
OpenAI:砍速度,砍額度,什麼都砍
OpenAI 最近確定是關了。砍速度,砍額度,什麼都砍,送重置已經被看破手腳。
X 上 @mylifcc 有一張實測截圖:Astra、5.6 Sol、Luna 的速度全部被降低到原來的 60%,GPT-6.1 Sol 更是降低到 15 tok/s。
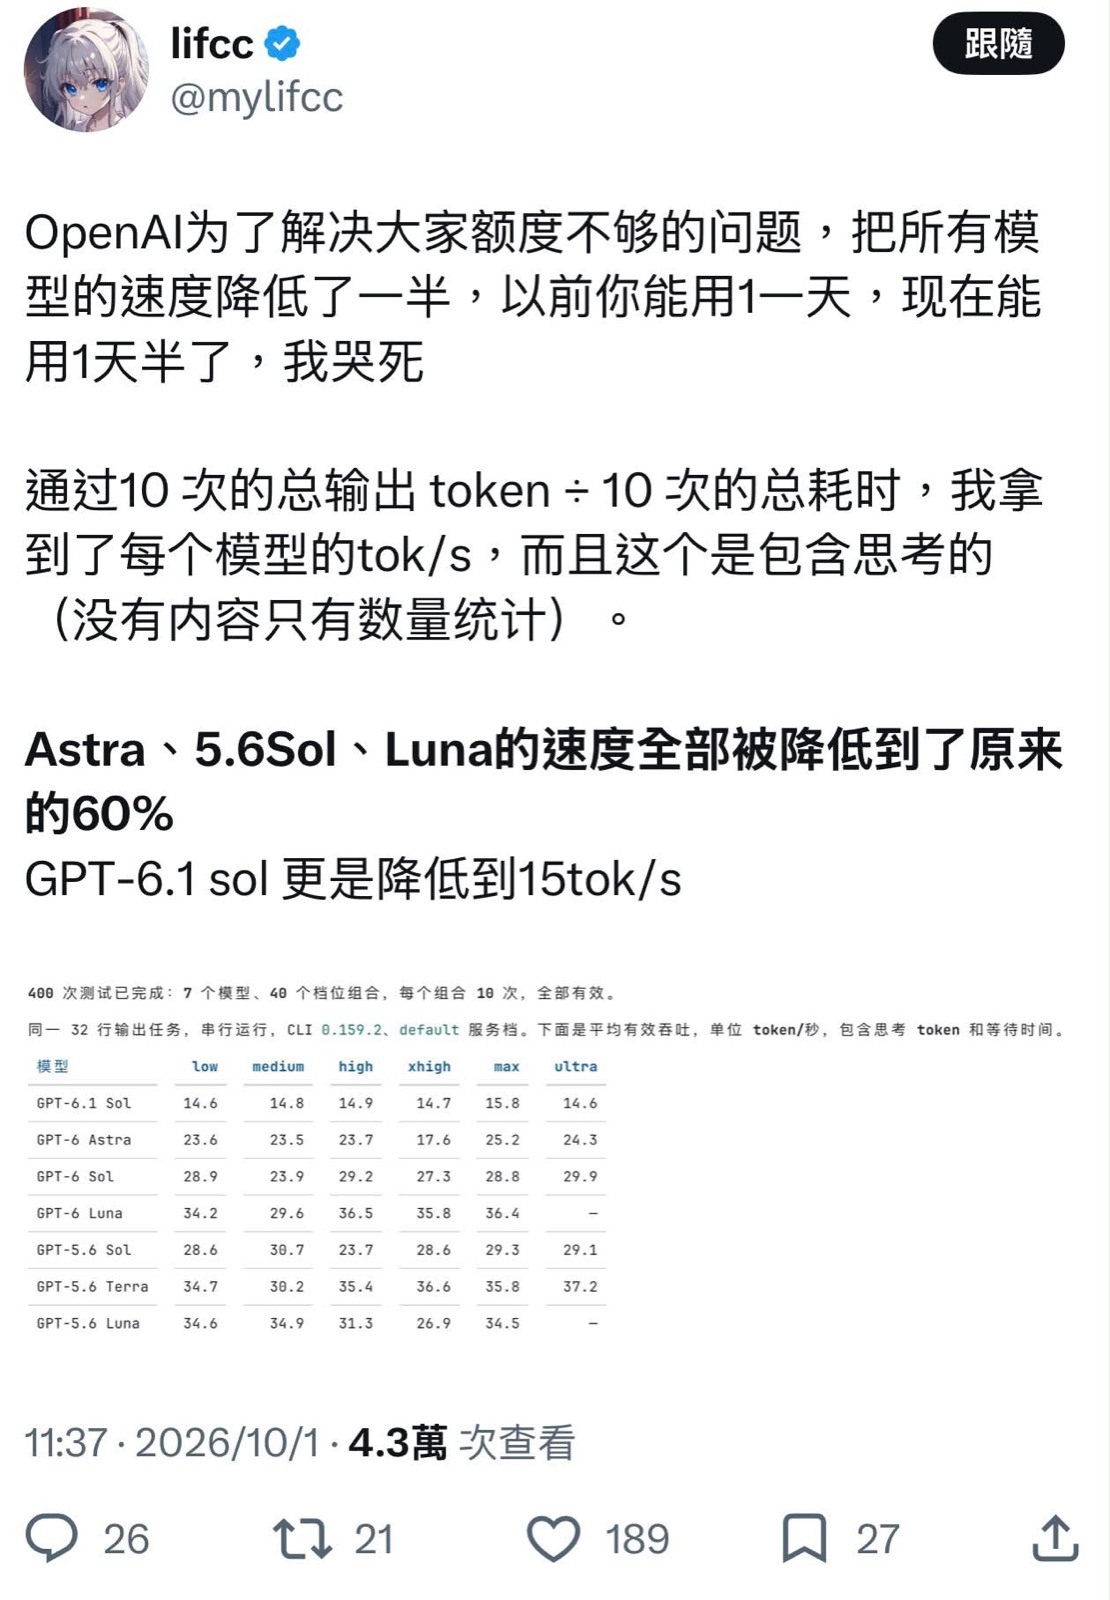
過去幾天 codex 慢到靠杯的元兇,看來就是這個⋯?
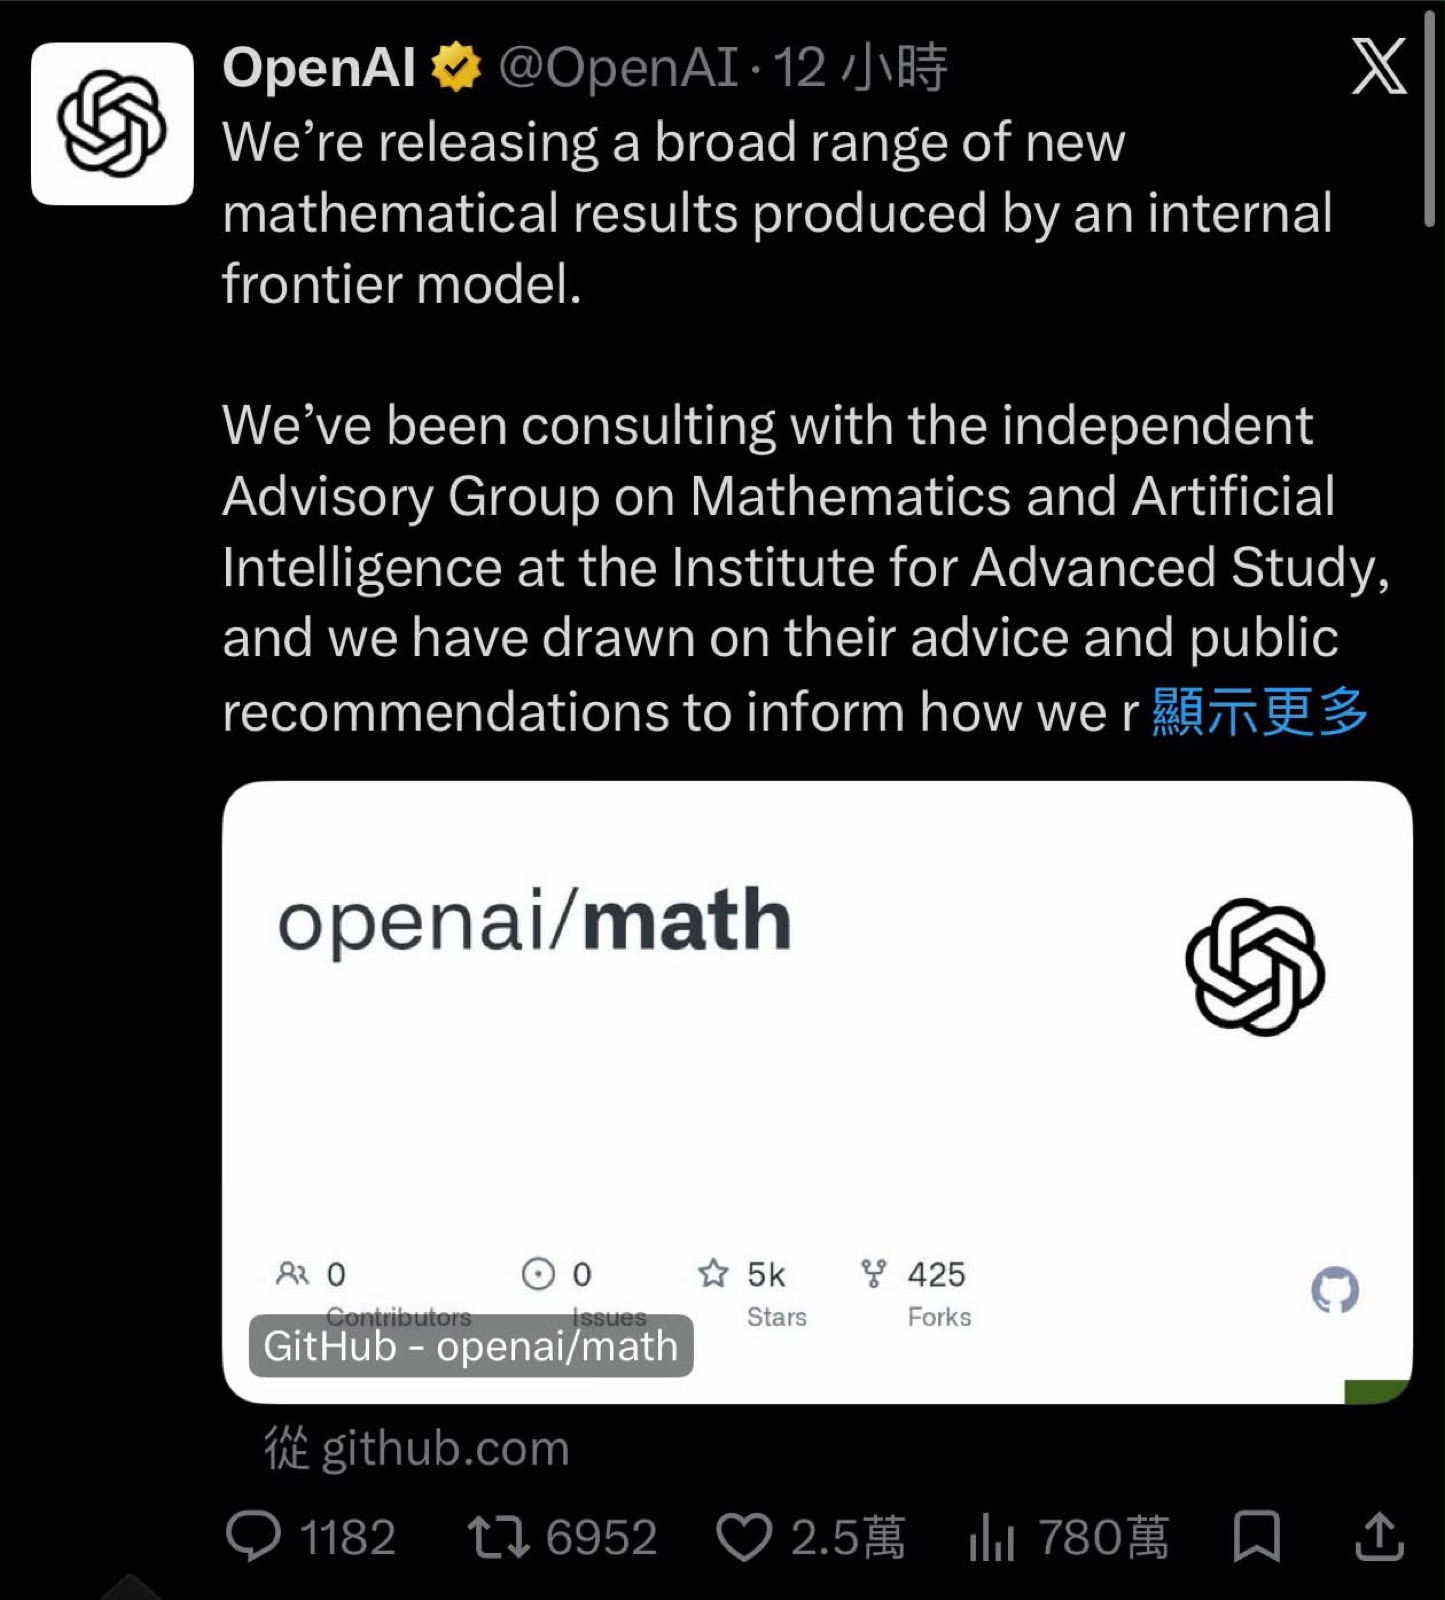
眼看他起朱樓,眼看他宴賓客,眼看他樓塌了~
最近讓 GPT 6.1 Sol 做的事情中,我最滿意的是做這張梗圖:
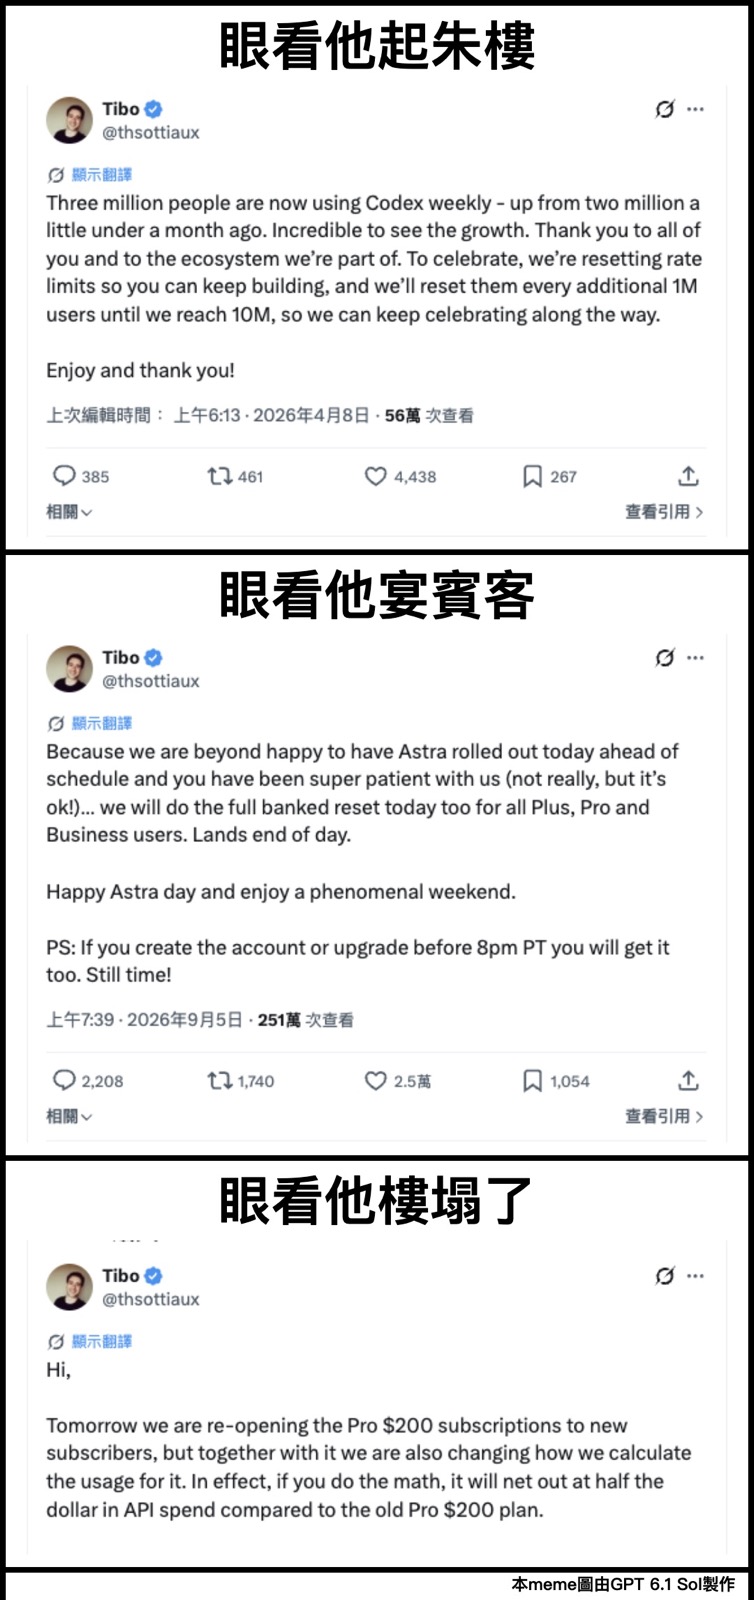
做正事又慢又卡,找素材、做 meme 圖臭自己東家竟然做得又快又好,果然是 OpenAI 口中最接近人類的 AGI(?
6.1 在知識工作上一樣爛,我另外寫過為什麼 GPT 6 Sol / Luna 用起來這麼蠢。現在 codex 只能讓他去做爬蟲等單點任務了,我也是真的很心累。我反覆搬家的紀錄在這篇。
A\ 這邊:前陣子要關,現在大門敞開
A\ 則是前陣子要關過,最近又大門敞開了,尤其是 O 5.5,簡直 cp 怪物。
以下是我最新的實測,100 USD 開出 5469 大禮包。
所以我現在最大的願望就是希望 OAI 能夠稍微爭氣一點,這樣:
- A\ 才不會一家獨大拿翹
- O 才不會有更多人逃難過來把算力擠爆
拜託 OAI 快點振作,不然太多人逃難過來,到時候 A\ 算力不夠遭殃的又是我們。
封號:寧可錯殺一百
講到封號,其實要逃真的很難,因為他們的數位指紋識別抓法設定,就是完全不在乎 Type 1 Error,拼了命的要降低 Type 2 Error,也就是「寧可錯殺一百,不願放過一人」。
不過這其實可以很好理解,因為企業戶才是他們的收益主要來源。
訂閱戶他們是賠本 50 倍補貼的,但是被假號蒸餾的巨大風險又是來自於這些訂閱戶,所以錯殺好幾百個也不會影響到他們的收益。
更重要的是兩大模型商歷史上的重要上位時刻,靠的大多都是對手的失誤。只要錯殺比例不要高到大屠殺級別的比例,社群很難有感也很難跳槽到對面。
要不是 OAI 亂七八糟,A\ 哪敢那麼囂張。
兩三個月前,風向是反的
兩三個月前,風向是 A\ 明明原本領先,為什麼會被 OAI 瘋狂搶走客戶?
Opus 5 上線的時候,本來想說他們很勇敢。後來想一想,Claude 一到日都有 outage 過,他們壓根就不在乎 uptime。
怎麼知道一間模型商要開始逆風了?就是他們一直推各種花里胡俏終端應用的時候。想想 Claude Design 那時誇張的一天一上新,想想 OpenAI Sora 的社交短影音 App。當這些東西收斂、剪枝的時候,模型商就要開始順風了。
其實就意識到這兩家會輪流自作孽就好,平常心就好。
做好備援
我在課堂上也明確地說:這些模型商就是皮癢身子賤,輪流做死被唾棄的;如果公司未來要仰賴商業 AI 做 Agent,那就要做好備援,不然模型躺了公司也跟著躺了。
Codex 的另一個問題:防禦式語氣
之前看到一則諷刺,好好笑,這種防禦式寫作我看 Codex 的嫌疑很大:「好的,我會誠實揭露我的睡眠狀態。我會分清楚『閉目養神』、『淺眠』與『深眠』,不會把三種狀態合併計算。我也會用 SHA-256 驗證睡眠時長與夢境內容一致。」
我請 Claude 派 subagent 去用 /history-find 抓 codex 防禦性寫作的口癖:我很不喜歡他過度強調「不能、不可以、不⋯不代表⋯」的說話方式,想知道是 harness 的問題還是 base model 的問題,為什麼同一套 sync harness,Claude 就不會這樣,codex 就會?是不是要在 sync 外加入專門給 codex 的 patch,讓他不要這樣說話?
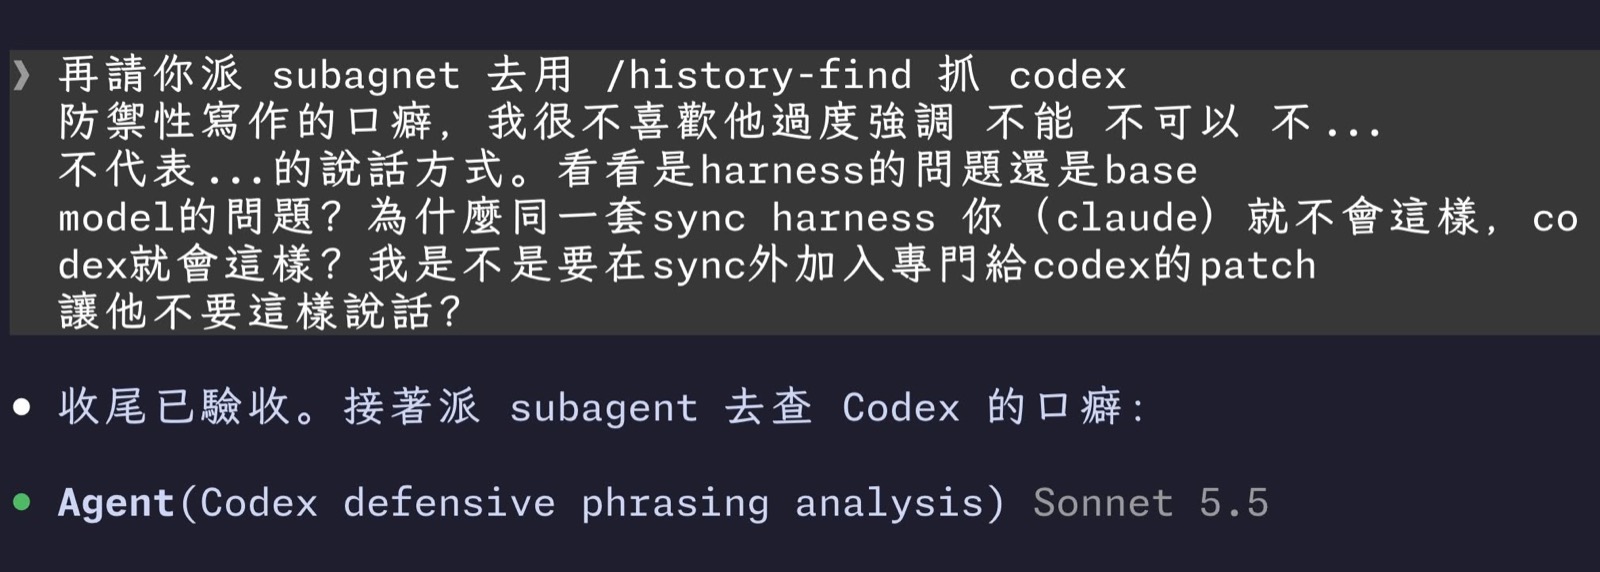
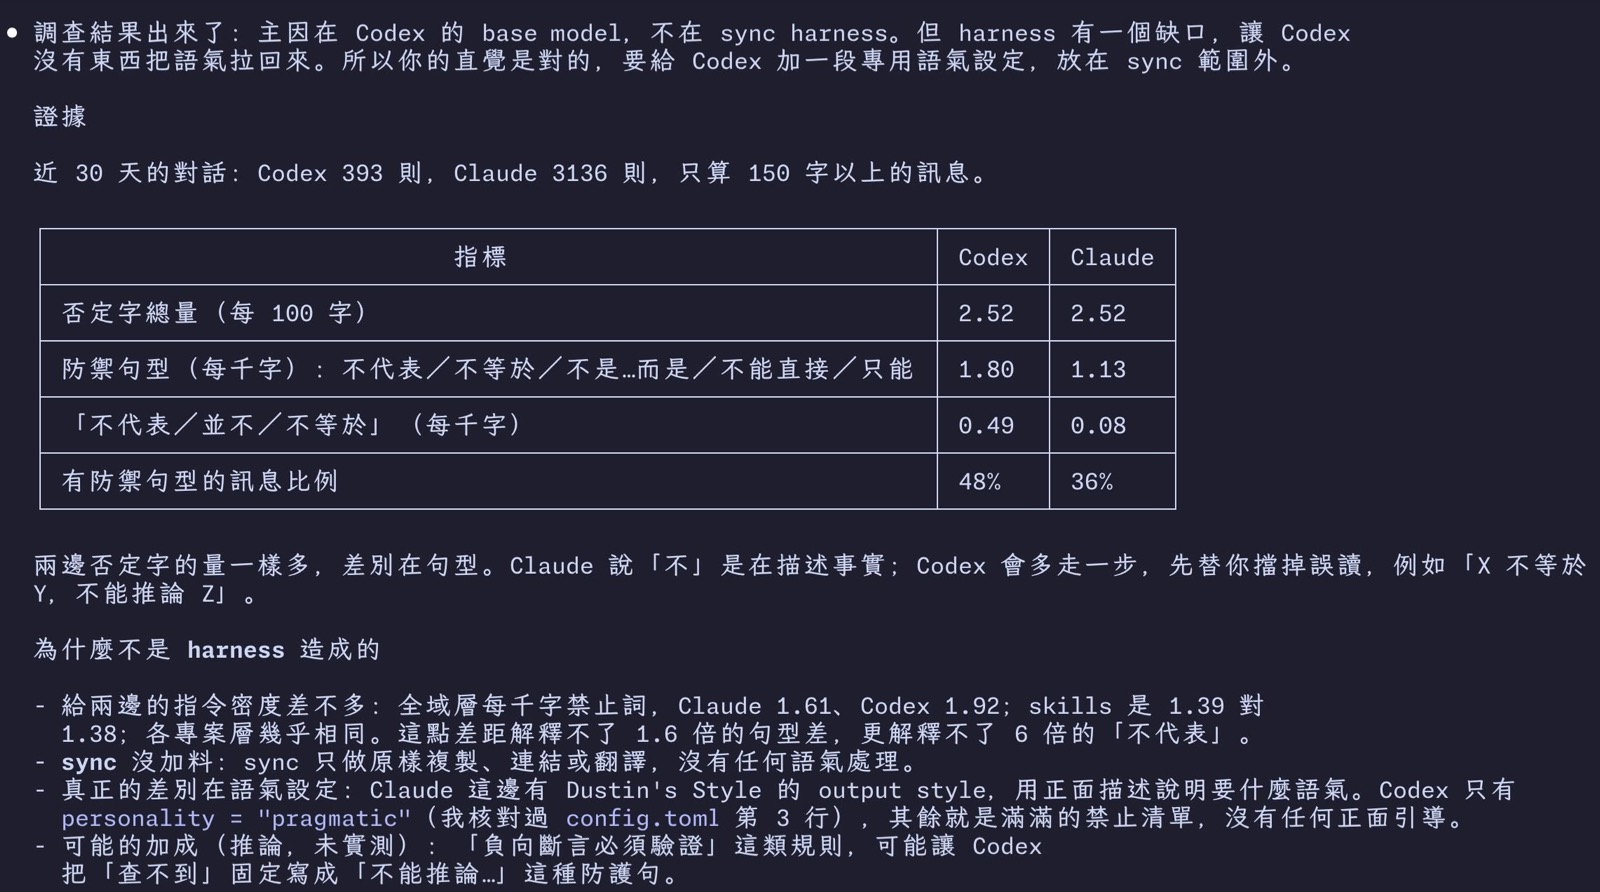
調查結果:主因在 Codex 的 base model,不在 sync harness。但 harness 有一個缺口,讓 Codex 沒有東西把語氣拉回來,所以要給 Codex 加一段專用語氣設定,放在 sync 範圍外。
證據是近 30 天的對話(Codex 393 則、Claude 3136 則,只算 150 字以上的訊息):
| 指標 | Codex | Claude |
|---|---|---|
| 否定字總量(每 100 字) | 2.52 | 2.52 |
| 防禦句型(每千字):不代表/不等於/不是…而是/不能直接/只能 | 1.80 | 1.13 |
| 「不代表/並不/不等於」(每千字) | 0.49 | 0.08 |
| 有防禦句型的訊息比例 | 48% | 36% |
兩邊否定字的量一樣多,差別在句型。Claude 說「不」是在描述事實;Codex 會多走一步,先替你擋掉誤讀,例如「X 不等於 Y,不能推論 Z」。
為什麼不是 harness 造成的:給兩邊的指令密度差不多,全域層每千字禁止詞 Claude 1.61、Codex 1.92,skills 是 1.39 對 1.38,各專案層幾乎相同,這點差距解釋不了 1.6 倍的句型差,更解釋不了 6 倍的「不代表」。sync 只做原樣複製、連結或翻譯,沒有任何語氣處理。真正的差別在語氣設定:Claude 這邊有 Dustin’s Style 的 output style,用正面描述說明要什麼語氣;Codex 只有 personality = “pragmatic”(config.toml 第 3 行),其餘就是滿滿的禁止清單,沒有任何正面引導。另外有一個可能的加成(推論,未實測):「負向斷言必須驗證」這類規則,可能讓 Codex 把「查不到」固定寫成「不能推論…」這種防護句。
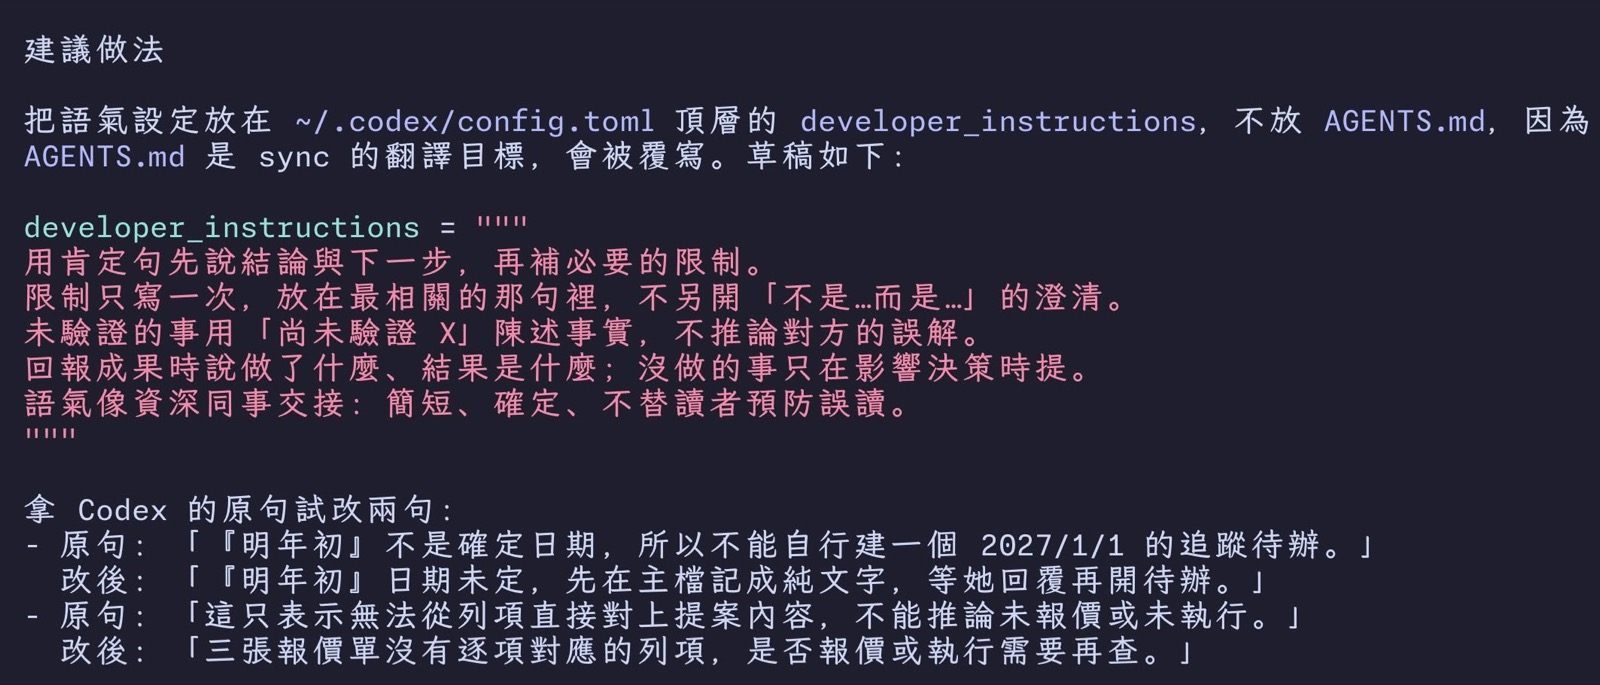
建議做法:把語氣設定放在 ~/.codex/config.toml 頂層的 developer_instructions,不放 AGENTS.md,因為 AGENTS.md 是 sync 的翻譯目標,會被覆寫。草稿如下:
developer_instructions = """
用肯定句先說結論與下一步,再補必要的限制。
限制只寫一次,放在最相關的那句裡,不另開「不是…而是…」的澄清。
未驗證的事用「尚未驗證 X」陳述事實,不推論對方的誤解。
回報成果時說做了什麼、結果是什麼;沒做的事只在影響決策時提。
語氣像資深同事交接:簡短、確定、不替讀者預防誤讀。
"""
拿 Codex 的原句試改兩句:
- 原句:「『明年初』不是確定日期,所以不能自行建一個 2027/1/1 的追蹤待辦。」改後:「『明年初』日期未定,先在主檔記成純文字,等她回覆再開待辦。」
- 原句:「這只表示無法從列項直接對上提案內容,不能推論未報價或未執行。」改後:「三張報價單沒有逐項對應的列項,是否報價或執行需要再查。」