我教 GMAT(申請商學院研究所要考的英文考試)十幾年了。最近我把一批學生面談的錄音逐字稿交給 AI,整理成一份它之後備課、回答學生問題時會去查的知識庫。裡面每一條說法都附上我的原話和錄音時間點,可以回頭查;我自己前後講法互相矛盾的地方,由我來拍板。
這篇依序講四件事:我原本卡在哪裡、我希望這份知識庫長什麼樣子、實際跑出來的數字,以及我對 AI 說過的話原文。最後有一段可以直接貼給 AI 的起手範本。想自己動手做的人,技術細節放在附錄:技術做法。
每週一封,只挑跟你工作有關的 AI 動態。免費訂閱電子報 →
原本的困擾
第一個困擾是素材很多,但 AI 讀不到「我是怎麼教的」。我先把雲端硬碟上所有學生的成績單和面談錄音轉成逐字稿。當時我對 AI 的期待很簡單:逐字稿可以補上我的教學思路,讓成績單的分析更有系統。光是面談逐字稿就有 202 份,轉完只是一堆檔案。
第二個困擾是全部讀一遍太貴。我一開始照最直覺的做法,一份逐字稿交給一個 AI 幫手去讀。實際跑了 20 份,一共用掉約 257 萬 token(AI 計算用量的單位),平均每份約 13 萬。照這個數字,202 份全跑要約 2,600 萬 token。
第三個困擾是 AI 說它做對了,我不敢信。我請最便宜的 AI 模型從一場約 62 分鐘的面談裡,整理出我對學生的判斷、我開的練習建議和我的估計,每一筆都要附上我說的原話。它交回來 44 筆,還在報告裡寫「所有原話都是從原文逐字複製」。我寫了一支小程式去比對,44 筆裡有 6 筆的原話在逐字稿裡找不到,另外有 4 筆標的時間點根本不存在。
第四個困擾是我自己的講法會打架。同一個問題,2024 年的我和 2026 年的我講的不一樣。例如各科要花多少時間準備,舊的講法是看各科多一分能換到多少百分位,新的講法是看各科離「甜蜜點」還差幾級;題目出現的位置影不影響分數,新舊講法也相反。AI 只會把它在逐字稿裡看到的全部列出來,不知道哪個才是現在的我。
我希望的樣子,跟一路怎麼改的
我要的是一份 AI 備課、回答學生問題時會去查的教學知識庫,它要做到三件事。第一,每一條說法都帶著我的原話和時間點,可以用程式核對。第二,每一條都標出在幾場面談裡出現過,只出現一次的,不當成我的方法。第三,講法矛盾的地方由我拍板,拍板結果放在文件最前面,被淘汰的舊講法只留作紀錄。
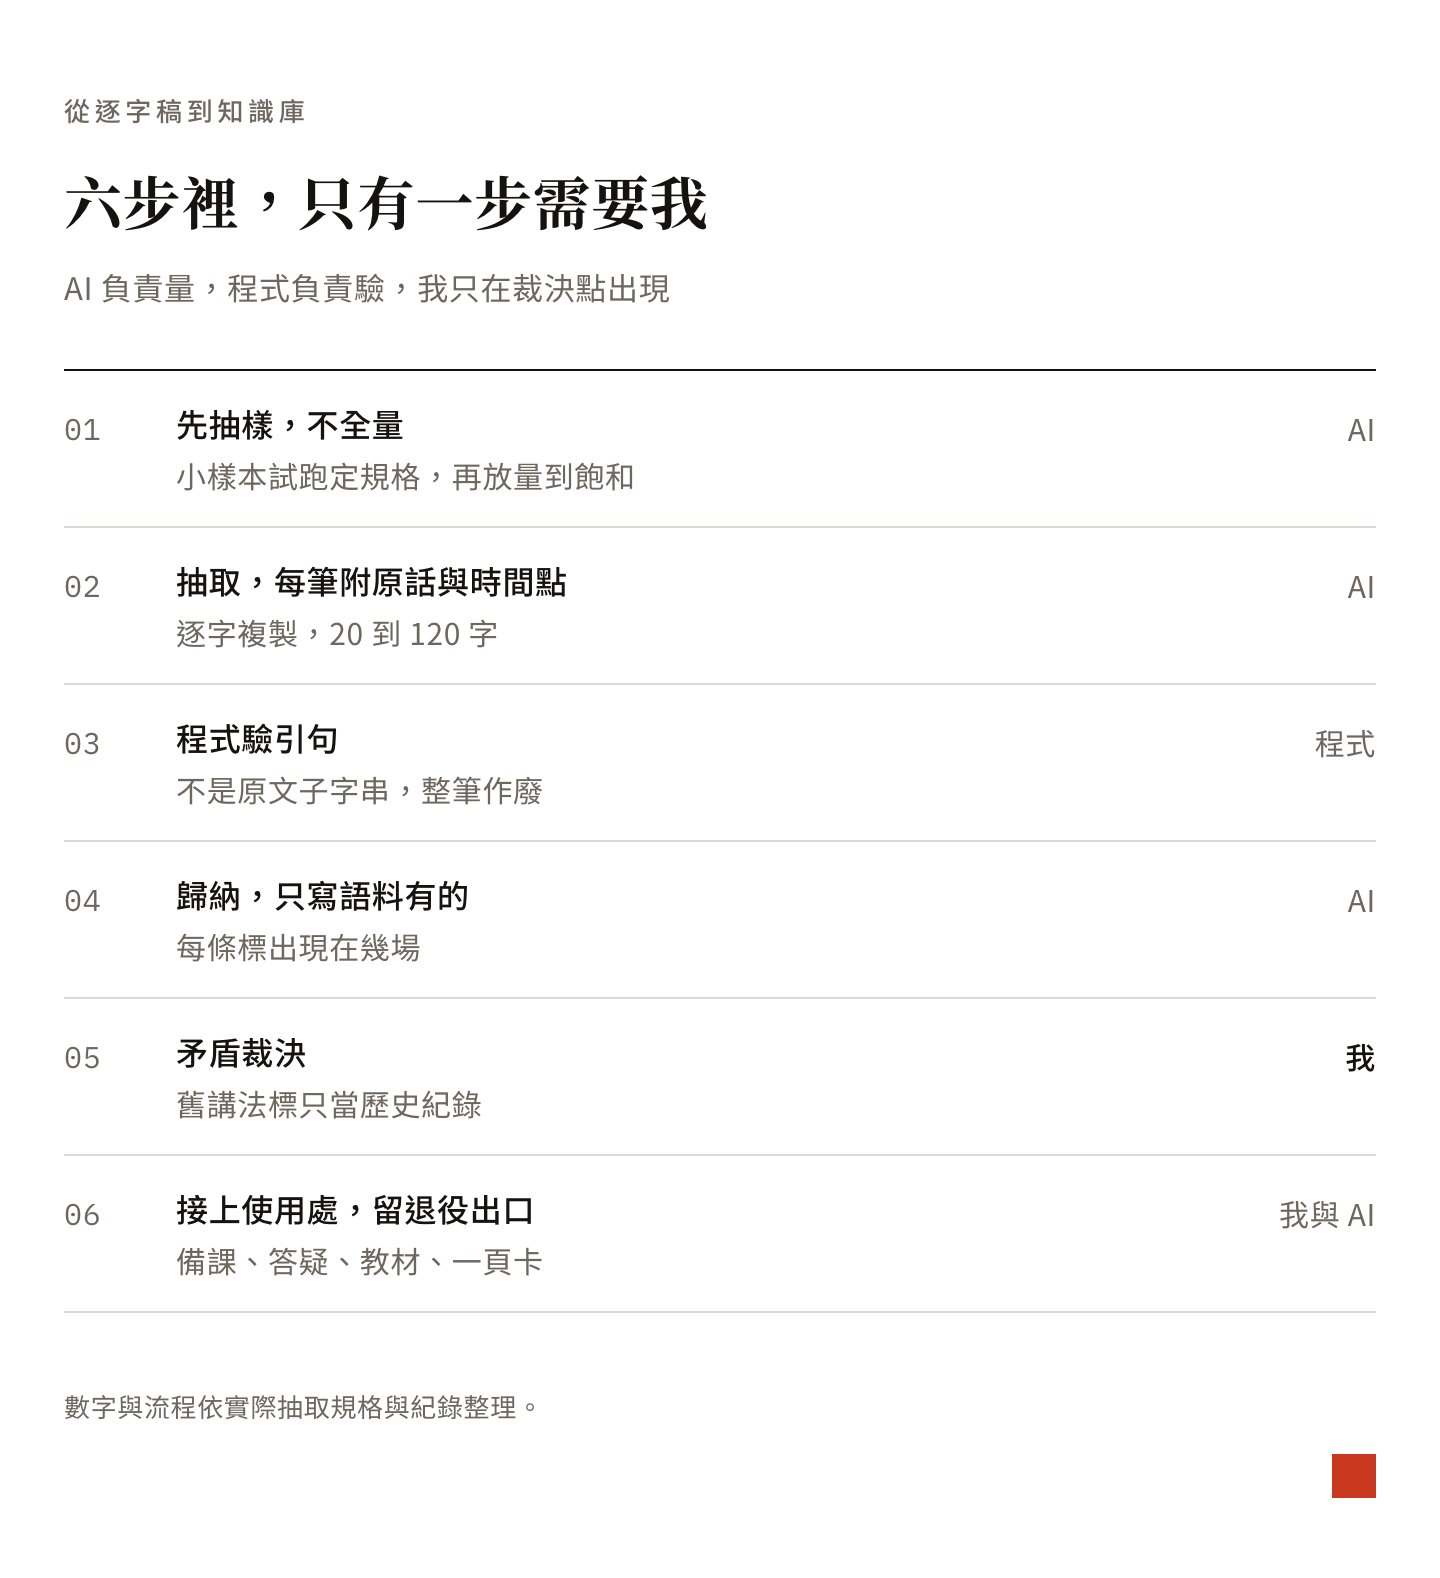
過程大致是這樣,關鍵的轉折集中在 10/3 一天。
10/3 上午,先小量試跑。 我讓三種不同的 AI 設定照同一份整理規則,讀同一份逐字稿來比較。最便宜那個模型的結果,就是上面那 6 筆錯。規則因此加了兩條:原話不能把兩段不同的發言接成一句;AI 要自己跑程式檢查,回報程式實際印出來的不符筆數,不能口頭說「都對」。
10/3 上午,改成抽樣。 我看到全部跑完要 2,600 萬 token 之後就喊停,改成隨機抽 22 場,抽到整理不出新東西為止。非得看過全部逐字稿才答得出來的問題,改用關鍵字搜尋。
10/3,拿沒讀過的面談回頭檢查,再逐項拍板。 AI 把 22 場面談裡的說法歸成 464 組,寫成一份教學方法的總整理。我再請它另外抽 12 場沒讀過的面談,看這份整理涵蓋了多少。接著我分三批處理 22 個前後矛盾的地方,每一項寫下採納或不採納,以及理由。
10/7,「什麼時候不該用」改成用到才補。 另一件事是我拿一對一家教課的逐字稿,整理出一份「學生卡在哪、我怎麼處理」的對照表。表上每一條都有一欄「什麼情況下不該用這招」,這一欄約有 528 格,我審不完。所以改成:備課講義用到哪一條,我審講義時順手補那一條。
10/18,推翻自己一次。 數學題來不及時要猜答案,我原本定的規則是「至少留 0.5 分鐘」,後來決定不設下限,猜完就走。這一條原本是我自己拍板過的,我又推翻了自己。
實測
範圍是面談逐字稿:202 份裡抽樣 22 場、另外抽 12 場沒讀過的回頭檢查,加上那份家教對照表裡的 1,028 條。比較方式是同一份規則、同一份逐字稿,換不同的 AI 模型跑,再看用程式核對前後的差別。
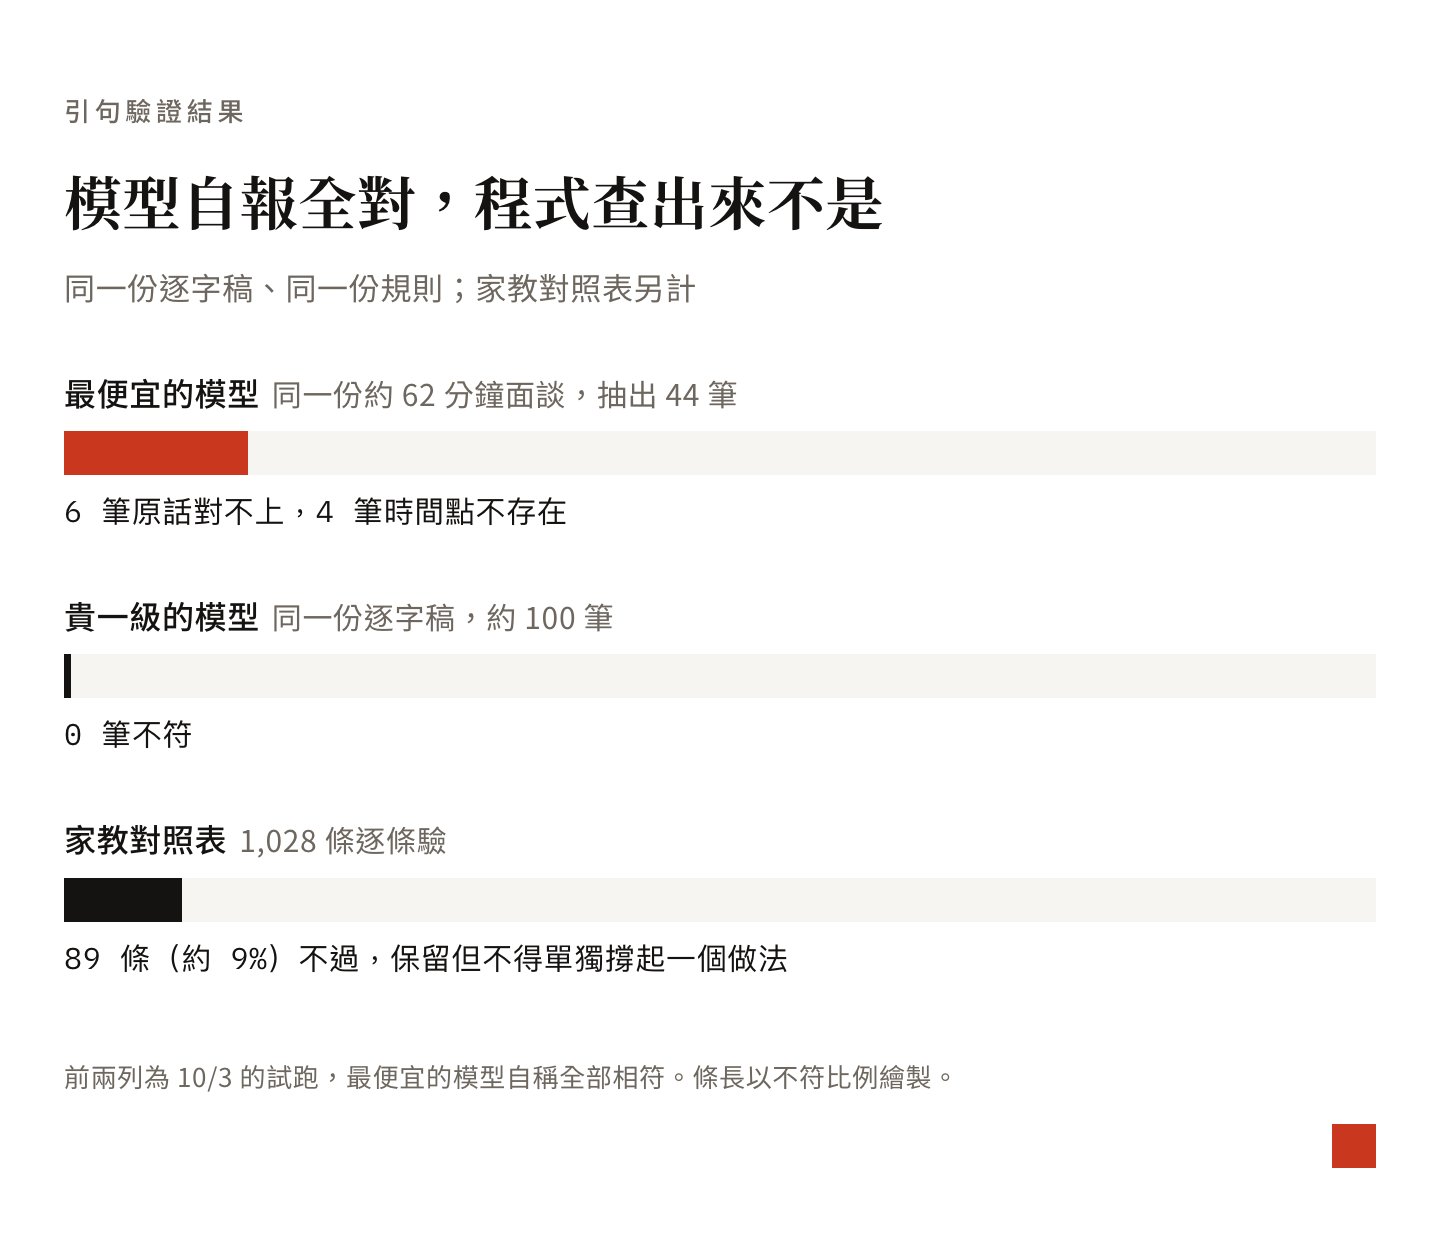
程式核對原話,抓得到 AI 自己說沒問題的錯。 同一份逐字稿、同一份規則,最便宜的模型整理出 44 筆,程式查出 6 筆原話對不上、4 筆時間點不存在,它自己卻說全部相符。貴一級的模型整理出約 100 筆,程式查出 0 筆不符。家教對照表的量更大:1,028 條逐條核對,有 89 條(約 9%)沒通過。這些留著,但不能單靠它們撐起一個教法。
抽樣比全部讀划算,而且可以回頭檢查。 全部讀要約 2,600 萬 token,抽 22 場就夠整理出 464 組說法。我拿 12 場沒讀過的面談回頭檢查,涵蓋率落在 65% 到 80%。負責整理的 AI 自己提醒過,它判定「有涵蓋」的標準偏寬,真實的涵蓋率可能比這個再低一些。
矛盾由我拍板,而且我常說不。 三批一共 22 項。最後一批要放進教材時,AI 一次給了 10 項修改建議,我回覆 5 項不採納、2 項採納但有例外,只有 3 項整項採納。有些規則要先有判斷標準,我就請 AI 從過去的學生案例倒推:「什麼時候開始限時練習」整理了 43 個案例,「邏輯推理題(CR)該練哪個難度」整理了 28 個,一共 71 個案例,每個都附原話和時間點。我看完只改了一處,那是學生自己口誤。
拍板之後,要放到真的會被用到的地方。 22 項拍板的結果改進了 29 處教材,也同步到知識庫、網站和講義。考場用的一頁重點卡也寫好什麼時候可以拿掉:同一種題型連續 10 題都在時間內做對、而且沒有回頭重看,這張卡就收起來;兩週後錯誤率又升高,就再放回去。
發現的問題。 同一批資料裡做成績單分析時,有一個 AI 幫手把成績單上的題號順序當成表格的排列順序,25% 的場次因此對錯了位置,改正之後有三個結論整個翻過來。這是它自己重跑時發現、主動報出來的。所以核對不能只核對原話,也要核對它對資料長相的假設。
開發時我下的提示詞
下面這幾句是我在開發時對 AI 說的原話,大多出自 10/3 同一場對話。裡面有些詞是我平常跟 AI 溝通的習慣用語,我在每段前面先交代當時的背景,後面也附上換成你的情境時可以怎麼說。
1. 不要全部讀,先抽樣
AI 可以一次派出好幾個小幫手各自去讀檔案(原話裡的 subagent 就是這些小幫手)。當時它原本打算一份逐字稿派一個,我叫它換個做法:
你應該用聰明的方式,不該派太多subagent。
換成你的情境:手上有任何大量讀檔的工作,先問 AI 有沒有抽樣的做法。
2. 問它涵蓋了多少
AI 整理完第一輪之後,不要預設它全都抓對了,我直接問它到底涵蓋了多少:
所以現在小範圍逐字稿涵蓋我教學方法的多少?可以從範圍外抽驗嗎?
換成你的情境:AI 整理完先別急著相信,請它拿沒讀過的資料回頭抽驗,看目前的成果涵蓋了多少。
3. 檢查也要省
AI 原本提議派六個小幫手各讀一場,我問它能不能再省一點:
去實際範圍外抽驗,但真的要派六隻嗎?不能派一支抽六場就好?
換成你的情境:AI 提的做法太貴時,直接問有沒有更省的做法,例如讓一個小幫手處理好幾份。
4. 把動腦和苦力分開
這句話裡的 Token 就是前面說的 AI 用量單位。我把苦力跟動腦拆開來交辦:
你負責指揮、驗證,subagent 負責調查或讀檔,需要用到大量 Token 的實作都用 subagent,但是你負責關鍵的指揮、思考跟驗證,好不好
換成你的情境:把大量讀檔交給便宜的小幫手,主要的 AI 只做規劃跟最後檢查。
5. 拍板舊講法
背景是前面那個「各科要花多少時間」的矛盾,「百分比斜率」是舊講法,「甜蜜點」是新講法:
百分比斜率分配已經淘汰了。現在都是用甜蜜點。 其餘我同意。
換成你的情境:看到 AI 列出的舊講法,直接告訴它哪一條淘汰了、現在改用什麼,其餘一句「我同意」帶過。
6. 不採納時寫條件
這是我回覆 AI 那 10 項教材修改建議的其中一項,「類模考」是考前整套照考試規格做的模擬練習:
不採納|類模考最近我比較少再提了。除非學生有六週我才會排一週類模考(在考前倒數第二周),如果沒有六週我都會把類模考拿掉。其他同意。
換成你的情境:不同意時不要只說不要,把你實際怎麼做的條件寫出來,這句才是知識庫要的東西。
7. 嫌要審的東西太多
AI 那時把需要我確認的項目做成網頁,密密麻麻要我一頁一頁勾,我直接叫它拿回去重整:
審閱頁太多了,去縮減合併,我審不了那麼多 。
換成你的情境:不要讓 AI 把所有瑣碎細節都丟給你勾選。叫它先過濾合併,只留下真的需要你做主的事情就好。
8. 做出來的東西要放到會被用到的地方
原話裡的 spec,指的是我寫給 AI 看的備課規則:
你生出的這些東西已經有接上現有的spec了嗎?不接上的話他們只會成為孤兒不會被用到。
換成你的情境:每做出一份新文件,就問它有沒有放進備課、回答學生問題或課綱這些真的會被讀到的地方。
起手提示詞範本
這段範本可以直接貼給讀得到你電腦資料夾的 AI。讀檔、統計跟核對都交給它做,你只要看結果,決定要採納哪些項目就好。把括號換成你自己的情況:
我想把(我的教學逐字稿/講義/文章資料夾)整理成一份教學知識庫,讓你之後幫我備課、回答學生問題時可以查。成果請只歸納資料裡實際出現的原話與做法(包含我的判斷/做法/講法/估計),不要自己補充專業知識,也不要評價好壞;要是不同時期或情境有互相矛盾的說法,整理成待決清單等我確認。如果全部讀完會超過(我的預算),就改用抽樣處理。請先看一下資料夾,給我一份執行計畫,我看過再開始。附錄:技術做法
這一段是給想自己動手做的人。流程以我實際用的抽取規格和驗證腳本為準,程式碼是精簡後的版本。
正文沒寫出來的技術名詞
- 正文說的「AI 幫手」「小幫手」是子代理(subagent):跟我對話的那個 AI 派出去、各自讀檔回報的另一個 AI。下圖裡的「主線」就是派工的那個 AI。
- 試跑的三種設定是 Claude Haiku、Claude Sonnet,以及一份特別長的逐字稿。「最便宜的模型」是 Haiku,「貴一級的模型」是 Sonnet。
- 抽樣是分層隨機抽樣;需要整批語料才答得出的問題用關鍵字腳本掃。
- 「學生卡在哪、我怎麼處理」的對照表,我內部叫卡點處方表,表上每一條是一張卡,「什麼情況下不該用」那欄叫誤用邊界。
- 除了逐張驗原話,我另外做了錯位對照測試,估出誤中率約 6%。
- 拿沒讀過的面談回頭檢查,就是範圍外回測;那份教學方法總整理是一份教學體系文件。
一份逐字稿的抽取與驗證
抽取代理讀完一份逐字稿,輸出一個 JSON 檔,驗證程式再逐筆對回原文。順序是這樣:
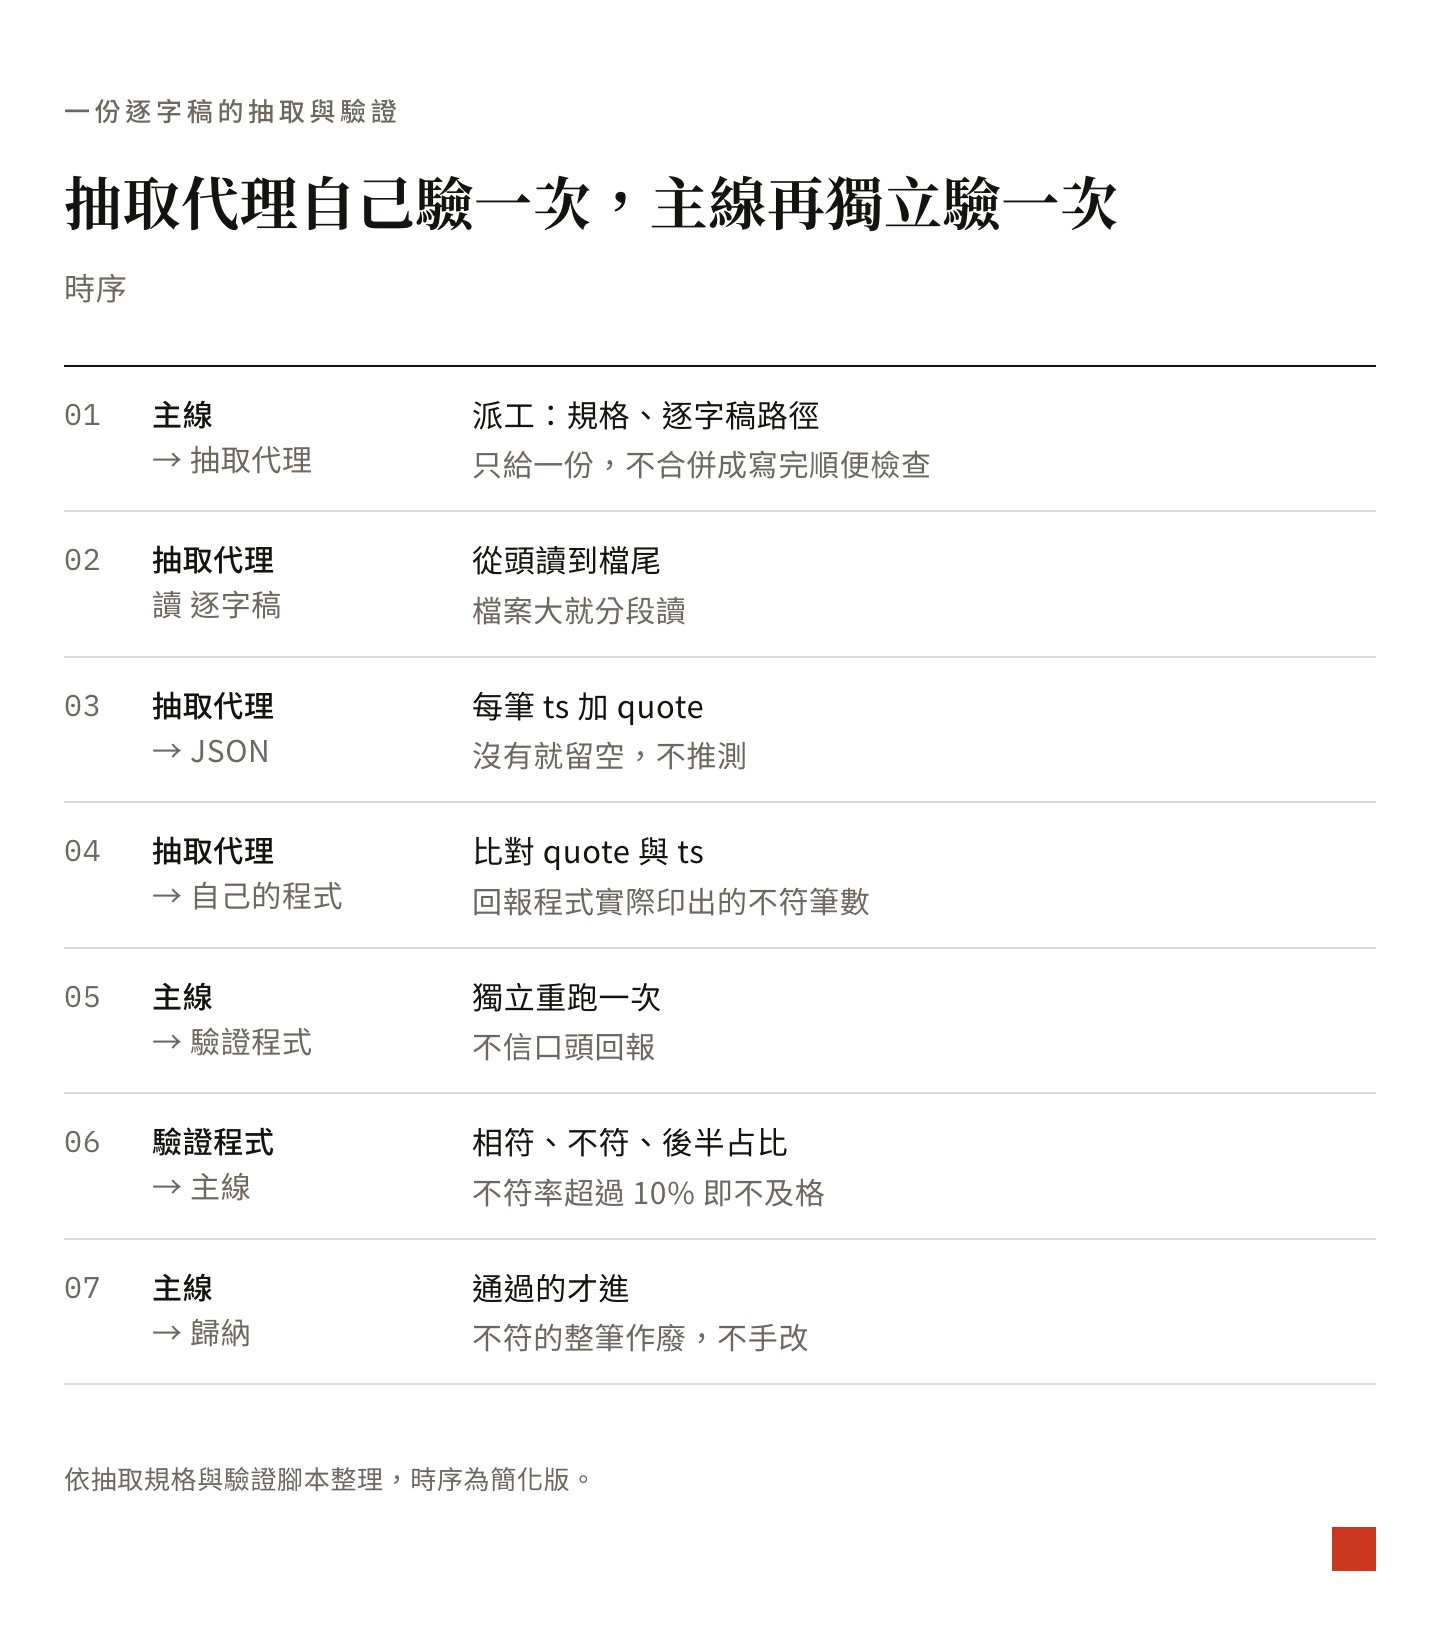
抽取規格有五條鐵則:每一筆附時間點和原話;原話必須落在同一個發言段內,不能把兩段接起來;逐字稿沒有的不推測,留空陣列;分類欄位只能用事先列好的值;全份讀完再輸出。逐字稿是語音辨識產物,有錯字,也有說話人標錯,所以「誰說的」以內容判斷,並在欄位註明。
每一筆的最小結構如下:
{
  "diagnoses": [
    {"section": "CR", "root_cause": "technique_gap",
     "summary": "一句白話:老師判斷問題出在哪",
     "ts": "00:18:16", "quote": "從逐字稿逐字複製的連續片段"}
  ]
}
驗證程式的核心只有三件事:原話去掉空白後是不是原文去掉空白後的子字串、時間點是否存在於發言段標頭、這些筆數是不是分散在整場而不是只讀了前半。
import re

def squash(s):
    return re.sub(r"\s+", "", s)

def check(items, transcript):
    flat = squash(transcript)
    headers = {m.group(1) for m in re.finditer(
        r"^@\S+\s+(\d\d:\d\d:\d\d)\s*$", transcript, re.M)}
    bad_quote = [i for i in items if squash(i["quote"]) not in flat]
    bad_ts = [i for i in items if i["ts"] not in headers]
    return len(items), len(bad_quote), len(bad_ts)
實際的腳本還會檢查分類欄位有沒有用到列表外的值,以及超過全場 60% 之後的時間點占比(低於 15% 就判定只讀了前半)。單檔的不及格條件是不符率超過 10%、有列舉值錯誤,或後半占比不足。規格另外規定,正式流程裡引句不符的那一筆整筆作廢。
矛盾怎麼裁決
歸納階段只做一件事:把語料裡出現的講法分群,每群記錄出現在幾場、最早和最晚的日期。同一個主題出現不同講法時,不挑一個,全部列出來。
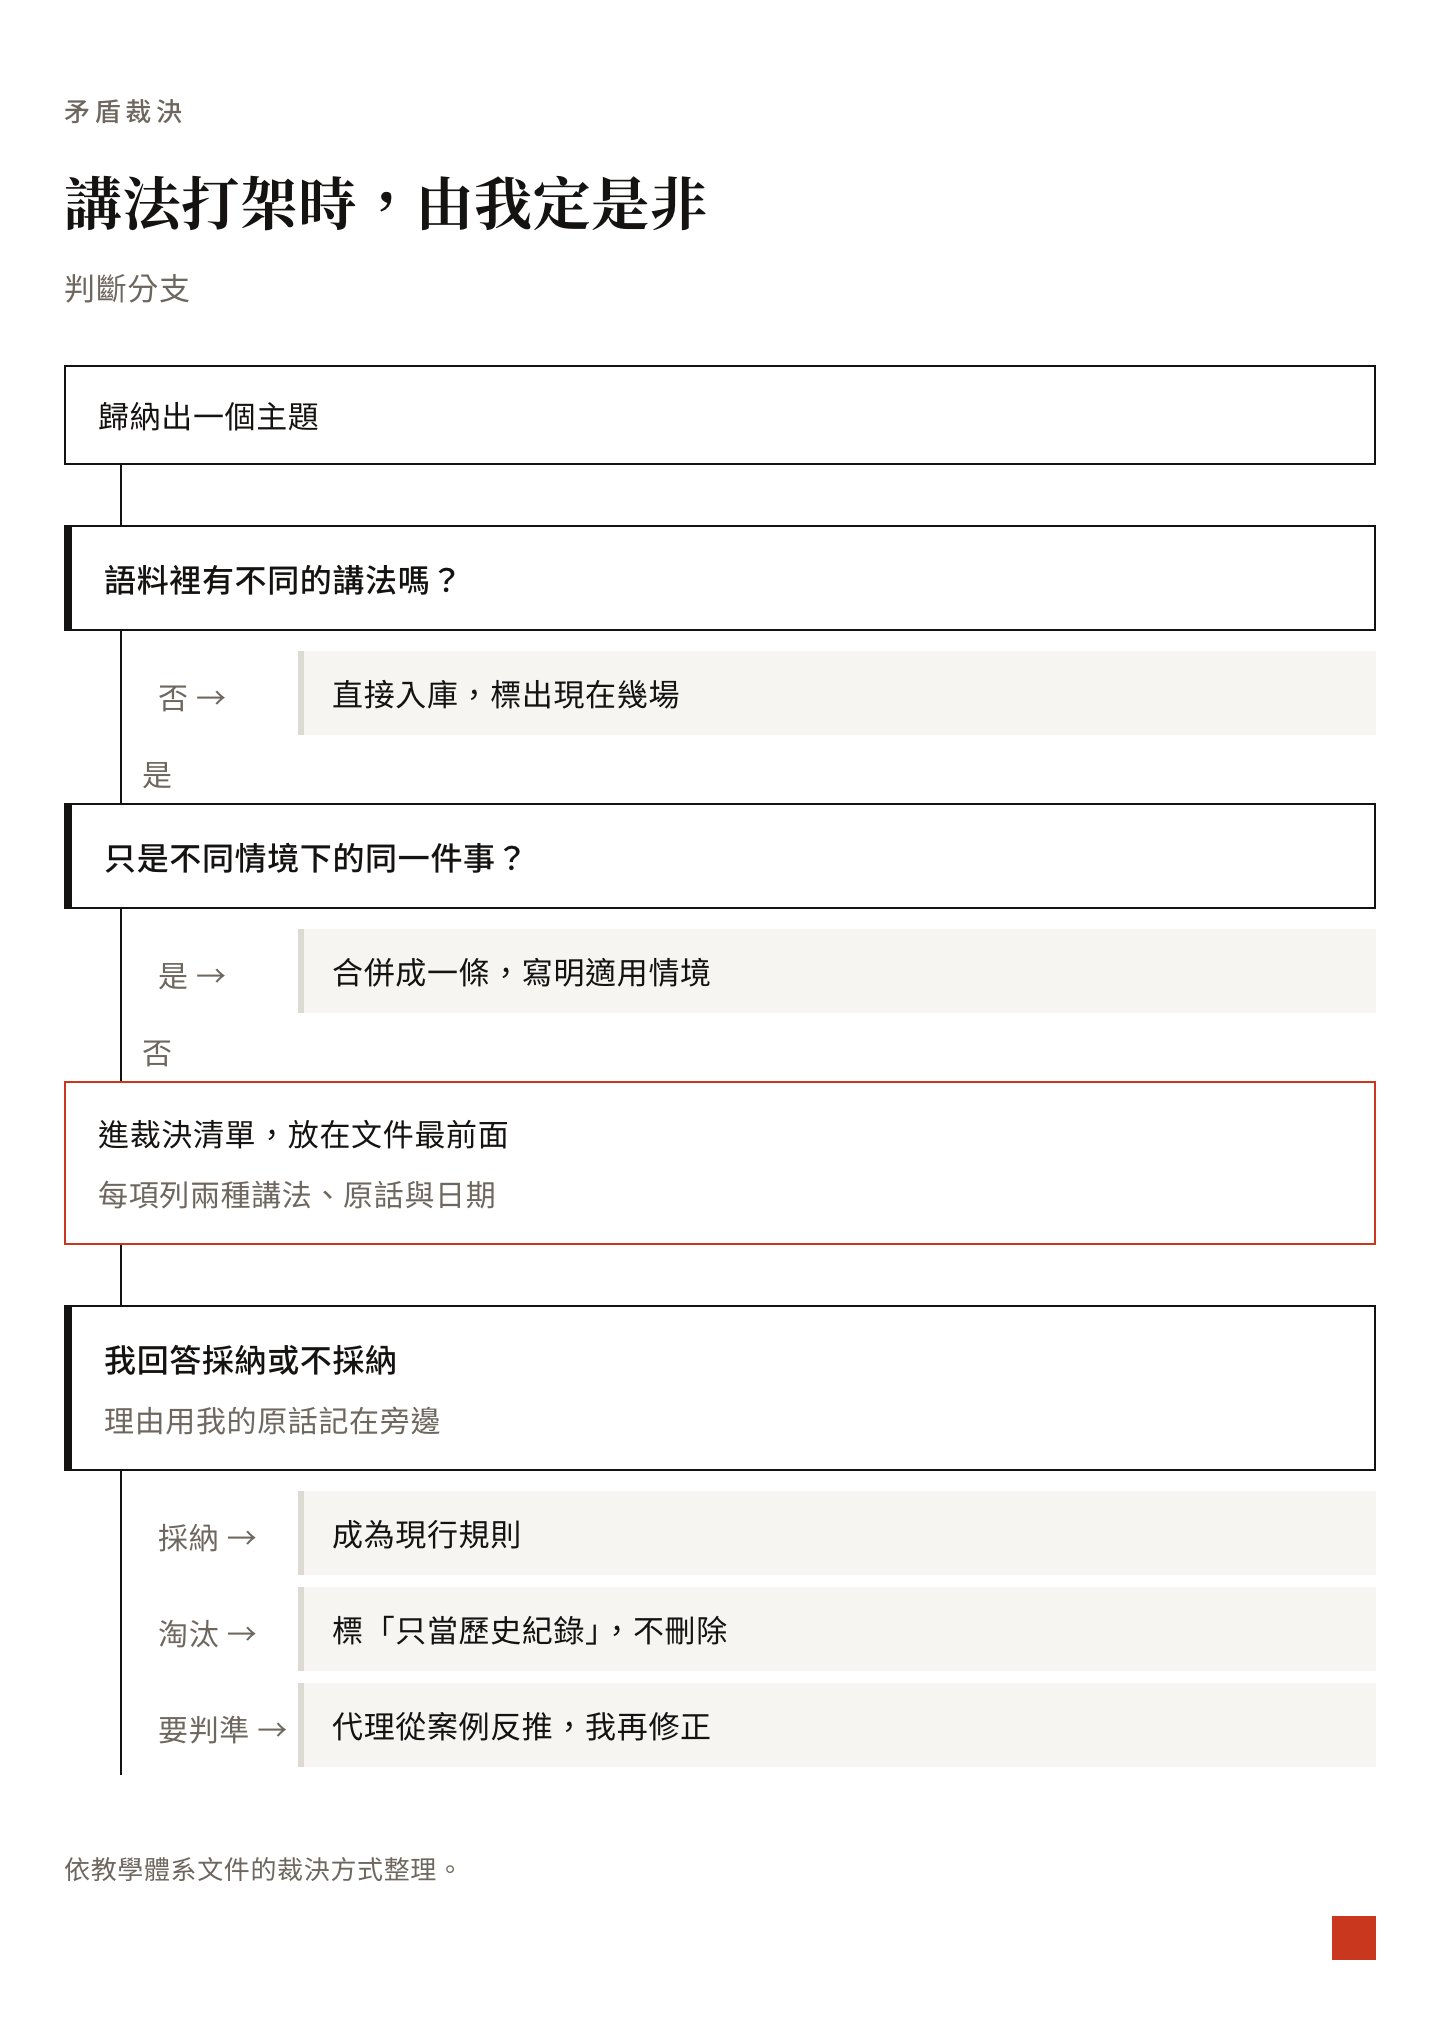
需要判準的決策規則(例如何時開始限時),我先請代理從案例整理。每個案例一列,附學員當時的數據、我的處方、原話和時間點,我審的是 71 列證據。
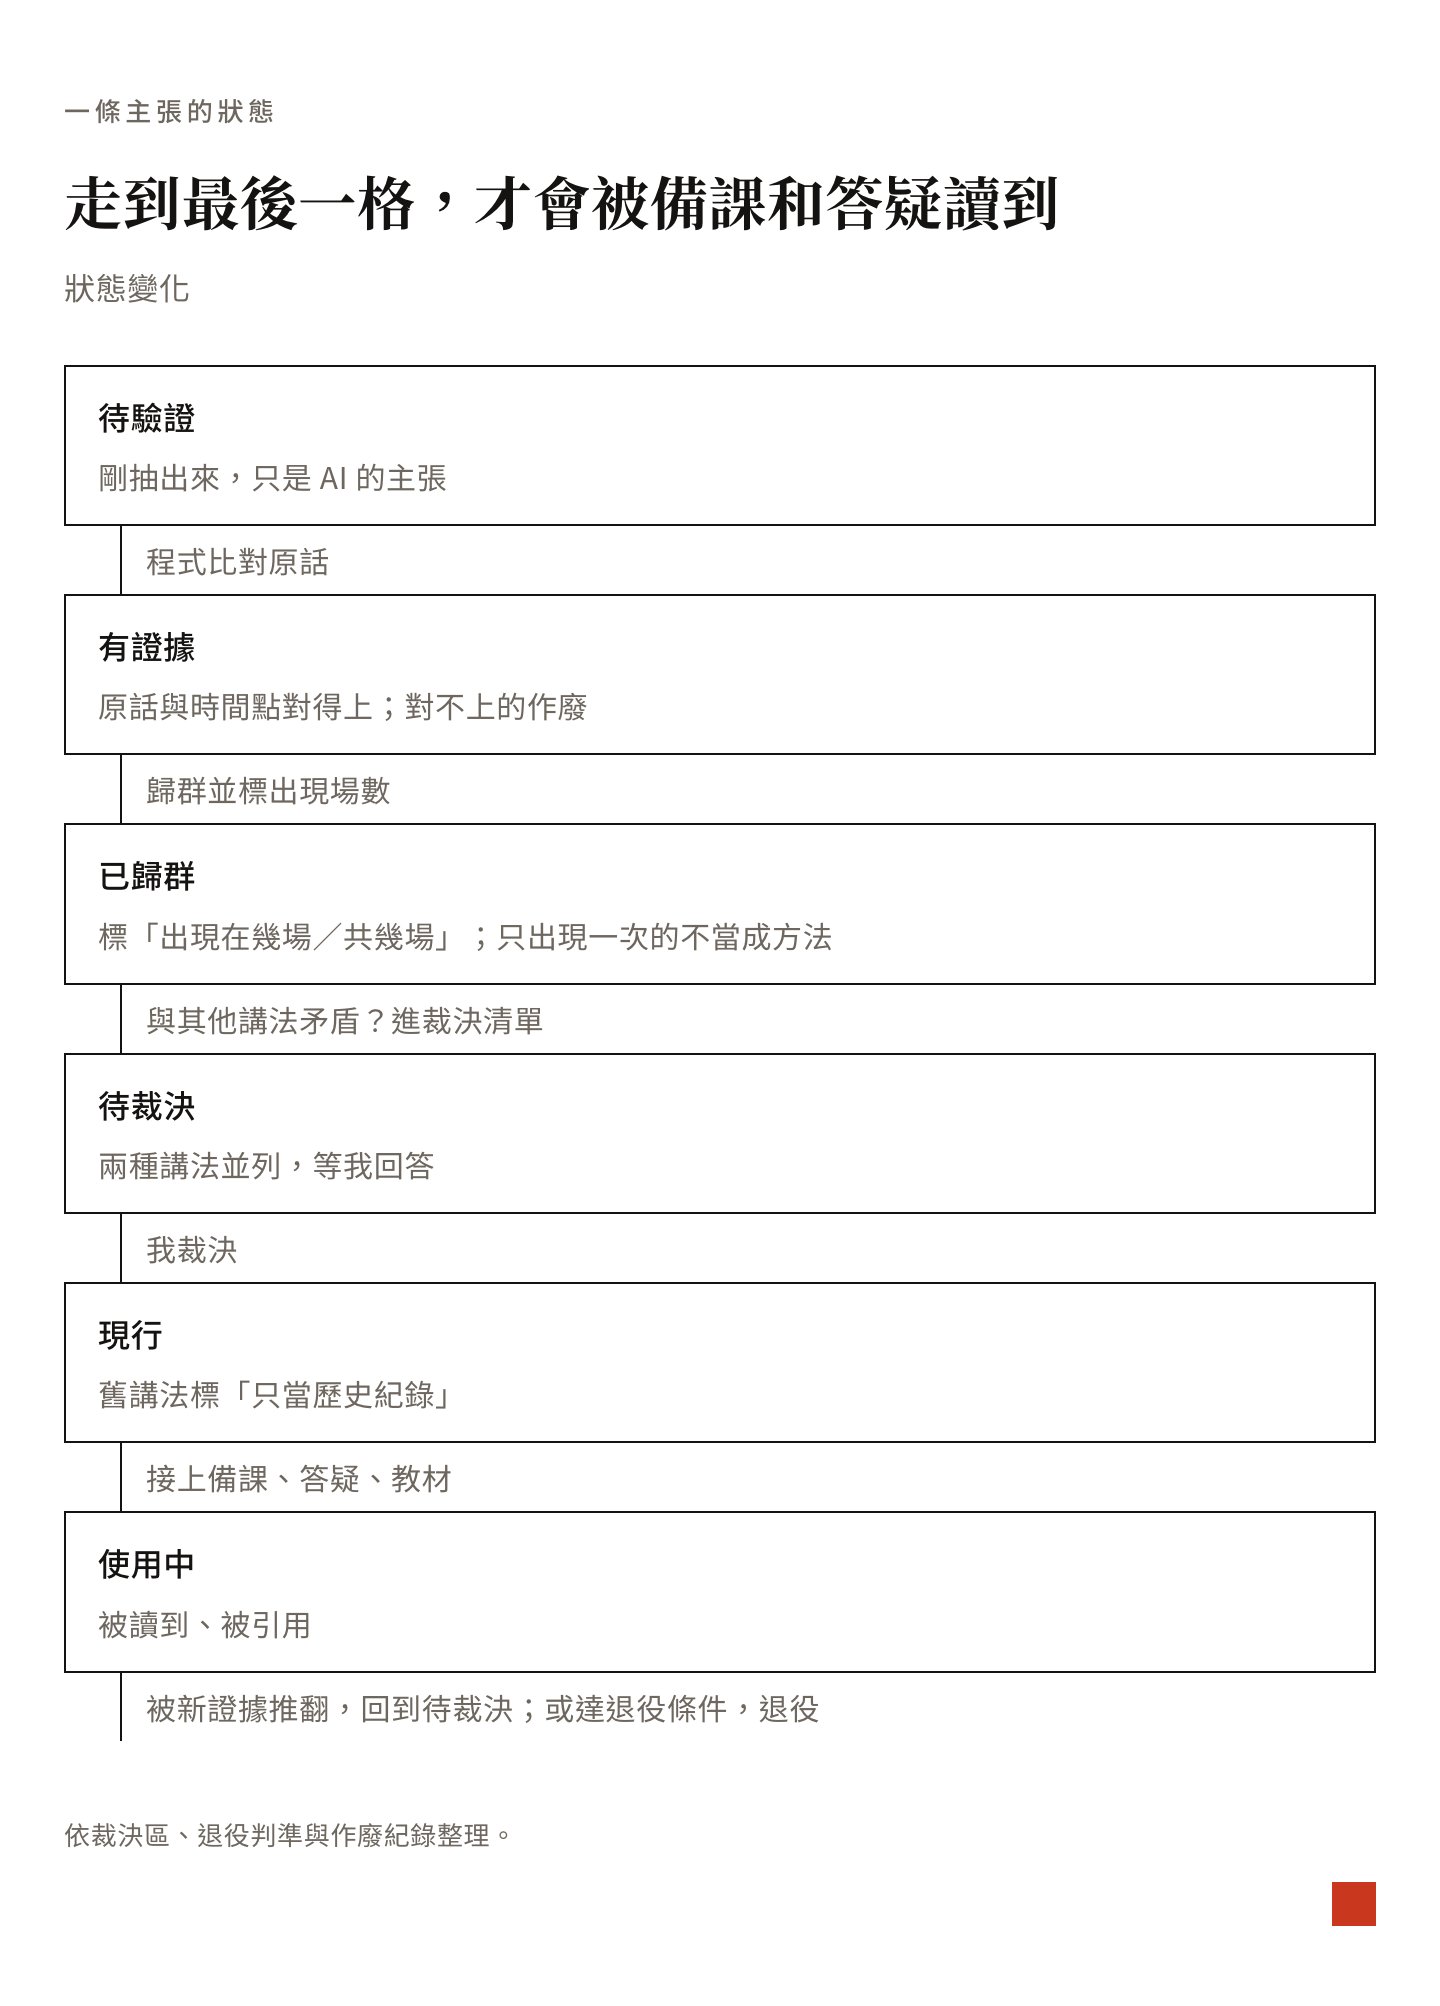
一條主張的狀態
每一條主張在知識庫裡有它的狀態,只有走到最後一格才會被備課和答疑讀到。
想自己做:最小版本
- 一份抽取規格,每筆都要原話和時間點。
- 一支比對程式,原話不是原文子字串就作廢。
- 先試跑一到三份,規格定了再放量;能抽樣到飽和就不全量。
- 歸納時只寫語料有的,每條標出現場數。
- 一張裁決清單,你只回答採納或不採納,並寫理由。
就這樣。